
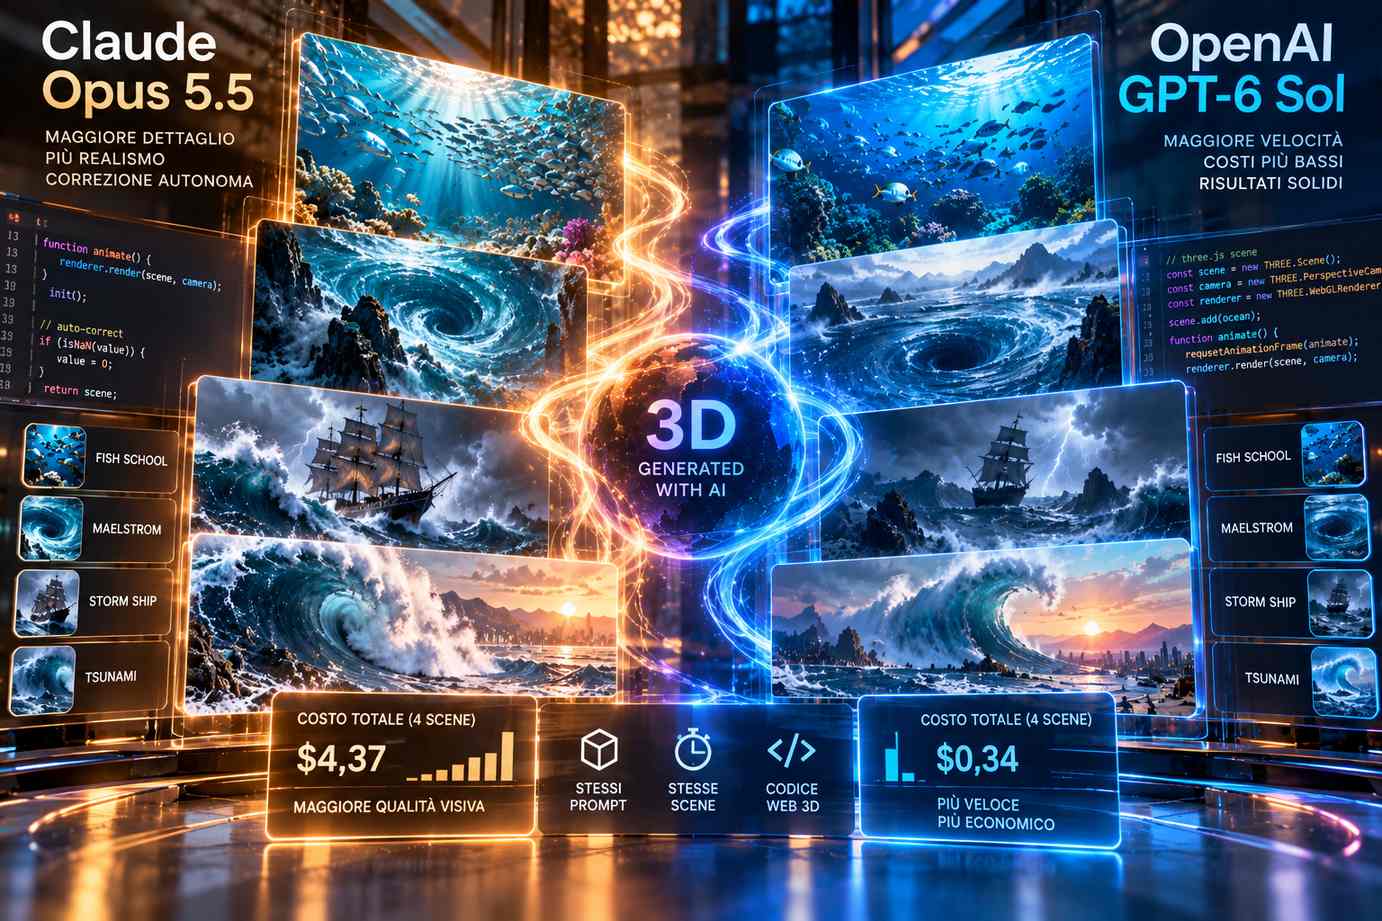
Claude Opus 5.5 e GPT-6 Sol sono stati messi a confronto nella generazione di scene web 3D attraverso codice, facendo emergere differenze nette tra qualità visiva, capacità di correzione autonoma e costo di esecuzione. AI/ML API ha utilizzato le API di Anthropic e OpenAI sottoponendo ai due modelli gli stessi quattro prompt one-shot, ciascuno composto sostanzialmente dal nome della scena da realizzare: un banco di pesci animato, Fish School, un Maelstrom, una nave in mezzo a una tempesta e uno Tsunami. In condizioni quindi particolarmente essenziali, senza una lunga sequenza di istruzioni aggiuntive, Claude Opus 5.5 ha prodotto render più dettagliati e scene caratterizzate da una maggiore cura degli elementi grafici, riuscendo inoltre a individuare e correggere autonomamente errori nel codice durante la generazione. GPT-6 Sol ha mostrato invece maggiori limiti nell’estensione degli algoritmi 3D e nella rifinitura degli elementi visivi, ma ha completato lo stesso gruppo di quattro attività con un costo complessivo molto inferiore: 0,34 dollari contro i 4,37 dollari di Opus 5.5, una differenza di circa 12,8 volte. Nel solo test iniziale del banco di pesci, per esempio, il costo riportato è stato di circa 1,076 dollari per Opus 5.5 contro 0,085 dollari per GPT-6 Sol. Il confronto evidenzia quindi due comportamenti differenti nello stesso tipo di attività: Opus utilizza più elaborazione per costruire e rifinire la scena, mentre Sol punta su un’esecuzione nettamente più economica pur arrivando a un risultato meno dettagliato.
Un secondo esperimento, realizzato utilizzando la libreria grafica Three.js e prompt molto più estesi, ha approfondito ulteriormente queste differenze mettendo Claude Opus 5.5 a confronto con GPT-6 Astra e Claude Fable 5.1. In questo caso ogni modello ha ricevuto circa 100.000 token comprendenti un pacchetto di competenze Three.js, il brief e una checklist obbligatoria per la consegna e ha dovuto generare tre produzioni a tema post-apocalittico, ciascuna racchiusa in un singolo file HTML e costruita esclusivamente tramite codice. Le scene riguardavano un parco divertimenti immerso nella nebbia al tramonto, con ingresso, carosello, montagne russe e ruota panoramica; una ghost town nel Mojave, comprendente riprese dell’autostrada, della strada principale, dell’interno di un diner e dell’intera cittadina; e una centrale nucleare notturna, nella quale il cielo doveva costituire l’elemento dominante e comprendere almeno 30.000 stelle, Via Lattea, due torri di raffreddamento alte 150 metri, il villaggio dei lavoratori e la sala di controllo. Ogni produzione comprendeva quattro inquadrature inserite in una timeline automatica di circa 90 secondi, con transizioni, dissolvenze e possibilità di passare manualmente da una scena all’altra. In questo test GPT-6 Astra ha ricevuto un singolo prompt e restituito una sola risposta tramite OpenRouter, senza utilizzare un ciclo agentico o visualizzare il risultato nel browser; Claude Opus 5.5 e Fable 5.1 hanno invece operato all’interno di Claude Code come agenti, scrivendo il file, aprendolo nel browser, osservando i frame, individuando eventuali problemi e intervenendo ripetutamente sul codice.
Le differenze di metodo si sono riflesse direttamente sia nei tempi sia nella quantità di token utilizzati. GPT-6 Astra ha completato tutte e tre le produzioni in 27 minuti e 16 secondi, con 93.905 token di output e un costo complessivo di 8,43 dollari, contro circa 40 minuti e 3 secondi, 98.000 token e 9,20 dollari stimati per Fable 5.1 e 69 minuti e 18 secondi, 373.076 token e 19,38 dollari per Opus 5.5. Astra ha inoltre prodotto 4.714 righe di codice, quasi il doppio delle 2.580 di Opus e nettamente più delle 1.691 attribuite a Fable. Tutte le 36 inquadrature previste sono state renderizzate, ma Opus 5.5 e Fable 5.1 hanno rispettato correttamente tutti e 12 i segmenti del brief, mentre Astra ne ha completati 11: nella scena della centrale nucleare il cielo conteneva infatti pochissime stelle, nonostante fosse esplicitamente indicato come elemento principale. Sul piano della pura velocità Astra ha richiesto fra 7 minuti e 18 secondi e 10 minuti e 32 secondi per ciascun film senza mai aprire il browser, mentre il costo delle singole produzioni è stato rispettivamente di 2,54 dollari per il parco divertimenti, 3,08 per la ghost town e 2,81 per la centrale nucleare. Opus ha richiesto 4,85, 9,94 e 4,59 dollari per gli stessi tre compiti, ma ha utilizzato il ciclo agentico per osservare direttamente ciò che aveva generato e correggere problemi che non sarebbero stati necessariamente rilevabili analizzando soltanto il codice.
Proprio questa possibilità di controllare visivamente l’output ha permesso a Opus 5.5 di individuare diversi difetti durante il lavoro: fra gli esempi riportati figurano un valore NaN negli effetti di luce che produceva linee nere tratteggiate all’interno del diner, l’utilizzo di “patch” come nome di variabile nonostante fosse una parola riservata in GLSL, una telecamera che terminava la scena della sala di controllo puntando direttamente dentro una console e alcuni alberi che nascondevano la luce lampeggiante di una ciminiera alla fine di una strada. Il modello ha inoltre mostrato un progressivo riutilizzo del lavoro già svolto: la ghost town, sviluppata per prima, ha richiesto 46 chiamate al modello e 9,94 dollari, mentre il parco divertimenti è sceso a 16 chiamate e 4,85 dollari e la centrale nucleare a 17 chiamate e 4,59 dollari grazie al riuso degli strumenti costruiti durante il primo progetto. Una parte rilevante della spesa di Opus, circa 8,8 dollari sui 19,38 complessivi, è derivata dalle cache read, perché ciascun passaggio del ciclo agentico rileggeva un contesto compreso fra circa 200.000 e 450.000 token. Il vantaggio ottenuto con questo processo è risultato visibile soprattutto nella rifinitura grafica: Opus è stato l’unico a inserire fasci di luce solare attraverso le persiane polverose del diner e a riflettere le sue circa 38.000 stelle nel canale di raffreddamento della centrale, mentre Fable ha raggiunto un livello comparabile nella costruzione del cielo con circa 42.000 stelle e una Via Lattea completa di bande di polvere.
I dati tecnici diffusi da Anthropic per Claude Opus 5.5 vanno nella stessa direzione sul versante dell’efficienza rispetto alla precedente generazione della stessa famiglia. Il modello mantiene capacità di controllo agentico vicine a quelle di Claude Fable 5.1, ma secondo Anthropic riduce di circa il 40% il costo dei workflow reali rispetto a Opus 5 e aumenta di oltre il 30% la velocità di output. In un’attività di auditing e modifica di una codebase composta da circa 200.000 righe, un lavoro che con Opus 5 richiedeva più di 20 ore sarebbe stato completato da Opus 5.5 in meno di tre ore, utilizzando circa 2,5 volte meno token. Anche le tariffe sono diminuite: Opus 5.5 è proposto a 4 dollari per milione di token in input e 20 dollari per milione in output, con cache read a 0,20 dollari per milione, mentre GPT-6 Sol costa 2 dollari per milione in input e 10 in output. La differenza di listino aiuta quindi a spiegare la forte distanza di costo osservata nel primo esperimento, anche se il prezzo finale di un’attività dipende anche dalla quantità di token effettivamente generata, dal caching e dal numero di passaggi agentici necessari per arrivare al risultato.
Le prove mostrano quindi comportamenti molto differenti quando il coding viene utilizzato non soltanto per produrre software tradizionale, ma per costruire direttamente contenuti visivi complessi nel browser. GPT-6 Sol ha completato le quattro semplici scene one-shot a circa un tredicesimo del costo di Opus 5.5, mentre GPT-6 Astra, nel test Three.js più articolato, ha prodotto rapidamente in una singola risposta una struttura completa e funzionante, risultando il modello più veloce e meno costoso dei tre impiegati in quella prova. Opus 5.5 ha invece sfruttato il ciclo agentico e l’ispezione diretta del browser per correggere il proprio lavoro e aumentare progressivamente la qualità visiva, pagando questo comportamento con più tempo, più token e un costo complessivo superiore. Fable 5.1 ha occupato una posizione intermedia nei tempi e nei costi, ma ha utilizzato una quantità di token vicina ad Astra senza raggiungere la stessa velocità e, nelle valutazioni riportate, non ha eguagliato la capacità di rifinitura mostrata da Opus. Si tratta comunque di esperimenti effettuati immediatamente dopo il rilascio dei nuovi modelli e basati su specifiche configurazioni, prompt e modalità di esecuzione: ulteriori test potranno quindi fornire indicazioni più precise sul comportamento dei modelli in workflow di sviluppo differenti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)