
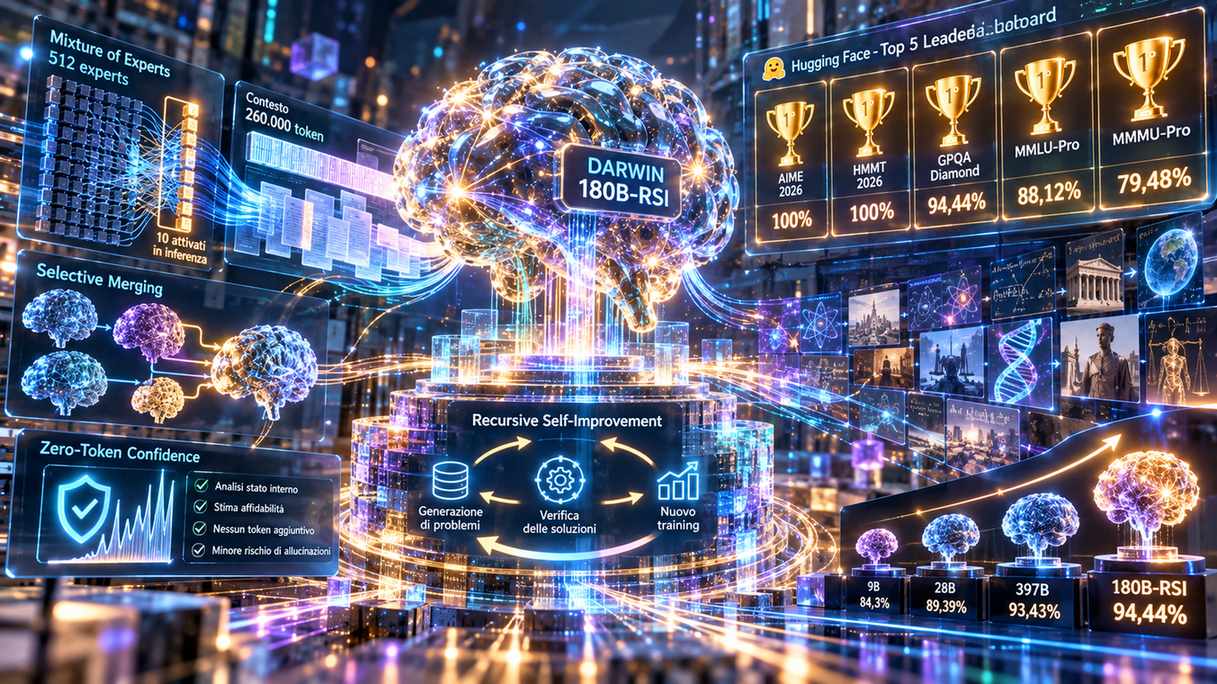
La startup sudcoreana Bedraft ha sviluppato Darwin-180B-RSI, un modello di ragionamento da 180 miliardi di parametri che ha raggiunto il primo posto in cinque leaderboard ufficiali di Hugging Face. Il modello utilizza un’architettura Mixture of Experts con 512 esperti complessivi, dei quali soltanto 10 vengono attivati durante l’inferenza, scelta pensata per ridurre il costo computazionale pur mantenendo una capacità complessiva molto elevata. La finestra di contesto arriva a circa 260.000 token e il foundation model di partenza è Qwen3.8-Flash-Next. Darwin-180B-RSI è stato pubblicato come modello aperto su Hugging Face e i risultati dichiarati riguardano benchmark classificati come ufficiali dalla piattaforma, non test privati predisposti direttamente dall’azienda. Nei benchmark matematici AIME 2026 e HMMT 2026 il modello ha raggiunto il 100%, superando i precedenti migliori risultati del 97,1% e del 92,7% ottenuti all’interno di leaderboard che comprendevano oltre 40 modelli, tra cui sistemi di Thinking Machines, Moonshot AI e SK Telecom. Secondo Bedraft, è la prima volta che un modello raggiunge il punteggio pieno in una leaderboard matematica ufficiale di Hugging Face. AIME è utilizzato nel percorso di selezione per le competizioni matematiche statunitensi, mentre HMMT è la competizione matematica organizzata da Harvard e MIT e comprende problemi di livello olimpico.
I risultati si estendono anche ai benchmark di ragionamento scientifico e conoscenza multidisciplinare. Su GPQA Diamond, composto da quesiti scientifici progettati da esperti a livello di dottorato e nel quale anche specialisti del settore raggiungono mediamente circa il 65% di risposte corrette, Darwin-180B-RSI ha ottenuto il 94,44%, superando Kimi-K3, fermo al 93,5%. Bedraft occupa inoltre contemporaneamente la prima e la terza posizione su questo benchmark, perché il precedente Darwin-397B-ZTC risulta ancora terzo. Su MMLU-Pro, che comprende oltre 12.000 domande a scelta multipla distribuite in 14 discipline, tra cui diritto, medicina ed economia, Darwin-180B-RSI ha raggiunto l’88,12%, mentre su MMMU-Pro ha ottenuto il 79,48%. L’azienda sottolinea anche la progressione della propria famiglia Darwin nel GPQA: il modello da 9 miliardi di parametri aveva raggiunto l’84,3%, quello da 28 miliardi l’89,39%, Darwin-397B il 93,43% e l’attuale versione da 180 miliardi il 94,44%. La crescita non viene quindi collegata esclusivamente all’aumento delle dimensioni del modello, ma a un insieme di tecniche proprietarie di fusione, selezione e auto-miglioramento sviluppate nel corso delle diverse generazioni.
Uno degli elementi principali è una tecnica definita selective merging, con la quale Bedraft analizza internamente differenti modelli in modo paragonato dall’azienda a una scansione MRI, identifica le componenti che mostrano le prestazioni migliori e le trasferisce o combina sulla base del livello di affidabilità rilevato. L’obiettivo è evitare una fusione uniforme dell’intero modello e integrare soltanto le parti considerate utili, contenendo il costo del ragionamento e permettendo al tempo stesso di lavorare anche con architetture di dimensioni fino a 397 miliardi di parametri. A questa tecnica si aggiunge il Recursive Self-Improvement, o RSI, che rappresenta il principale elemento distintivo di Darwin-180B-RSI. A differenza della distillazione tradizionale, nella quale un modello più potente produce risposte che vengono successivamente utilizzate per addestrarne uno più piccolo o meno capace, il sistema RSI fa risolvere i problemi direttamente al modello, verifica i risultati e seleziona soltanto le soluzioni considerate corrette per generare nuovi dati di training. Il modello produce quindi autonomamente una parte del materiale sul quale viene successivamente riaddestrato, creando un ciclo nel quale generazione, verifica e apprendimento possono ripetersi e migliorare progressivamente le prestazioni senza richiedere che un modello esterno più potente fornisca continuamente le risposte corrette. Bedraft mette questa impostazione in relazione con tecniche di auto-miglioramento sviluppate anche da Sakana AI, sostenendo tuttavia di disporre attualmente di una gamma più ampia di modelli e di risultati superiori: secondo i dati riportati su Hugging Face, Bedraft avrebbe circa sei volte il numero di modelli ufficiali di Sakana AI e più di sette volte i download complessivi, con oltre 50 modelli ufficiali e circa 400 varianti derivate. Le tecniche alla base della famiglia sono state inoltre descritte nel lavoro di ricerca “Darwin Family”.
Darwin-180B-RSI integra anche Zero-Token Confidence, o ZTC, una tecnologia progettata per stimare la probabilità di correttezza di una risposta prima che il modello inizi effettivamente a generarla. Il sistema analizza lo stato interno del modello e ricava un’indicazione di affidabilità senza introdurre token aggiuntivi e quindi, secondo Bedraft, senza richiedere ulteriore costo computazionale legato alla generazione. L’obiettivo è utilizzare questa stima preventiva per individuare situazioni nelle quali aumenta il rischio di allucinazioni o di comportamenti errati da parte di un agente AI e impedire che l’azione venga eseguita prima che l’errore si propaghi all’interno di un workflow. La combinazione di selective merging, RSI e ZTC costituisce quindi il nucleo tecnico della nuova versione: la prima tecnica seleziona e combina capacità provenienti da modelli differenti, la seconda genera autonomamente nuovi esempi verificati per il training e la terza cerca di misurare in anticipo l’affidabilità delle risposte. Bedraft intende proseguire su questa direzione sviluppando modelli capaci di migliorare progressivamente senza intervento umano diretto, facendo dell’auto-miglioramento ricorsivo non soltanto una tecnica di post-training, ma uno degli elementi centrali dell’evoluzione della famiglia Darwin.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)