
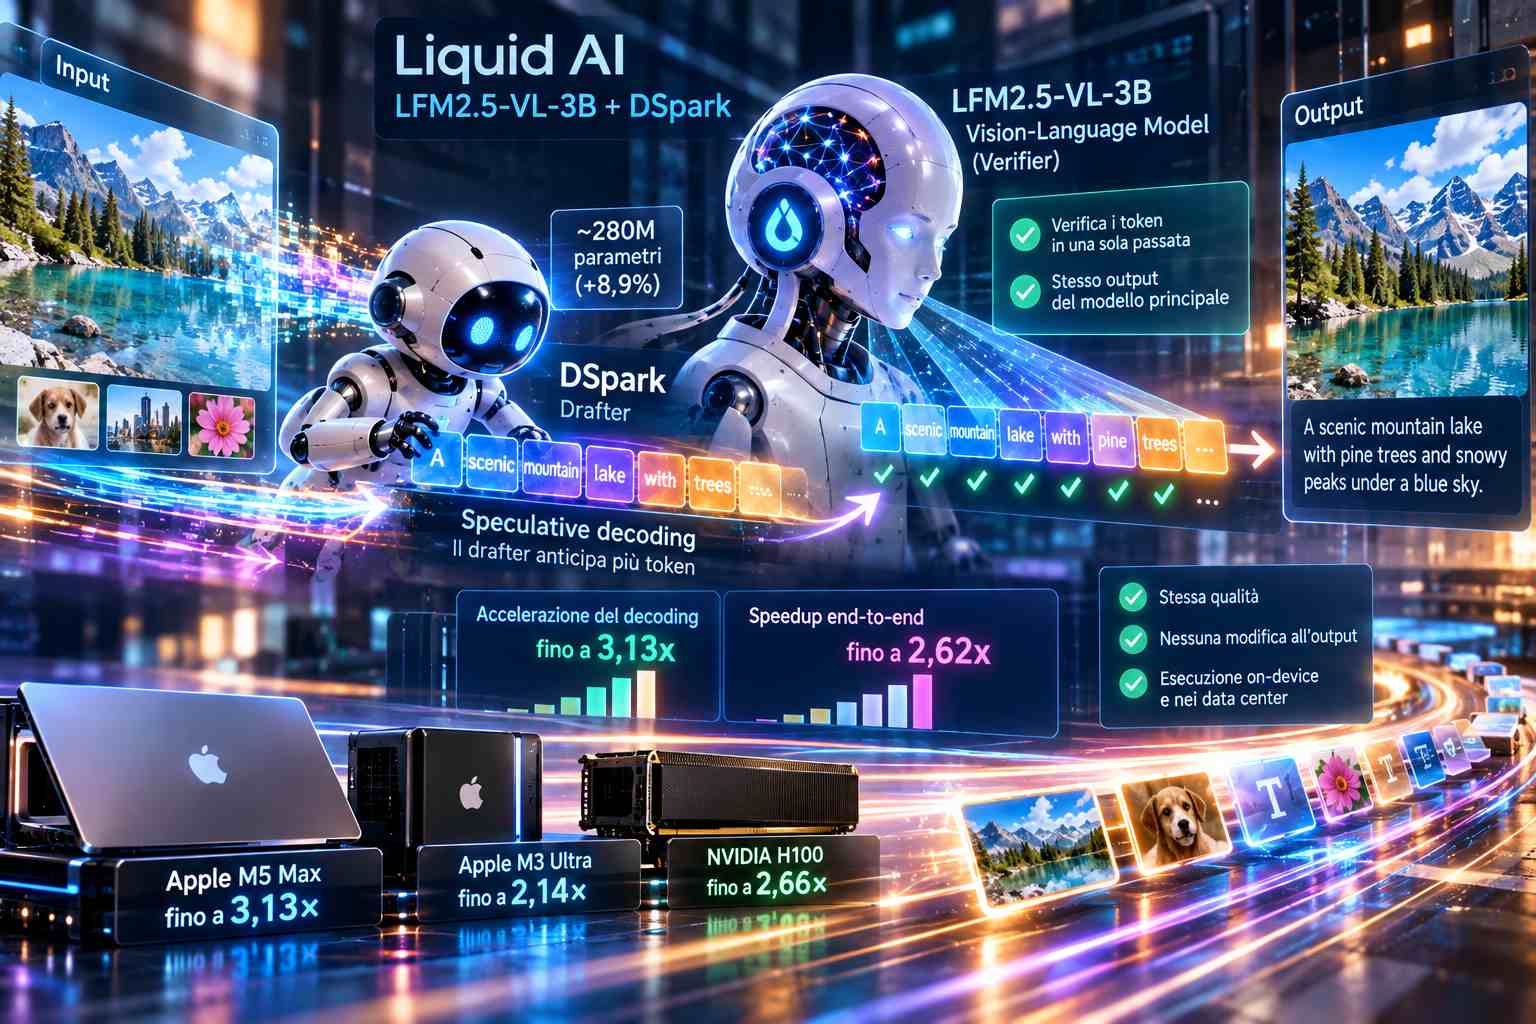
Liquid AI ha esteso ai modelli visione-linguaggio la tecnica dello speculative decoding, finora utilizzata soprattutto nei modelli testuali, presentando DSpark per accelerare la generazione dei token senza modificare l’output prodotto dal modello principale. Il 24 settembre l’azienda ha pubblicato LFM2.5-VL-3B-DSpark, un drafter sperimentale progettato specificamente per LFM2.5-VL-3B: il componente aggiunge circa 280 milioni di parametri, aumentando dell’8,9% il numero complessivo di parametri da distribuire, ma permette di ridurre in modo sostanziale il tempo necessario alla fase di decoding. Il principio è diverso dalla generazione autoregressiva tradizionale, nella quale il modello produce normalmente un token alla volta. Con DSpark, un modello più piccolo e veloce anticipa invece una sequenza di token che ritiene probabile, mentre il modello visione-linguaggio principale li verifica successivamente tutti insieme in una singola passata. Se le previsioni vengono accettate, più token possono quindi essere elaborati contemporaneamente anziché richiedere una nuova inferenza completa per ciascun elemento della sequenza. Il drafter non lavora inoltre soltanto sull’output precedente, ma riceve gli hidden state interni del modello target e li utilizza come informazione aggiuntiva per formulare previsioni più accurate, aumentando così il tasso di accettazione nonostante le dimensioni molto inferiori rispetto al VLM principale.
Nei test condotti da Liquid AI su sei attività visione-linguaggio, l’accelerazione varia in funzione dell’hardware e della quota del workload effettivamente occupata dalla generazione dei token. Su Apple M5 Max la velocità della sola fase di decoding è aumentata fino a 3,13 volte, mentre il miglioramento end-to-end ha raggiunto un massimo di 2,62 volte. Su M3 Ultra i valori massimi sono stati rispettivamente di 2,14 e 1,77 volte, mentre su NVIDIA H100 DSpark ha raggiunto fino a 2,66 volte la velocità di decoding e 2,27 volte quella complessiva. La differenza tra questi due tipi di misurazione deriva dalla struttura stessa di un VLM. Quando viene fornita un’immagine, il sistema deve prima elaborarla attraverso il vision encoder e trasformarla in rappresentazioni che producono centinaia di token visivi; questi devono poi essere processati dal modello linguistico durante la fase di prefill prima che inizi la generazione vera e propria. DSpark accelera esclusivamente il decoding e non interviene né sull’encoding dell’immagine né sul prefill, quindi l’aumento della velocità complessiva dipende da quanto tempo viene normalmente trascorso in ciascuna fase. Questo limite diventa particolarmente evidente sui dispositivi edge, dove la capacità computazionale è inferiore rispetto alle GPU da data center e il prefill può rappresentare una parte più consistente della latenza totale: di conseguenza, anche quando il decoding viene accelerato di oltre tre volte, l’utente può osservare un miglioramento end-to-end più contenuto.
Uno degli obiettivi principali di DSpark è aumentare la velocità senza introdurre una degradazione della qualità delle risposte. In configurazioni a bassa temperatura, nelle quali viene utilizzato un decoding sostanzialmente greedy e viene selezionata ogni volta l’alternativa con la probabilità più elevata, il modello target verifica comunque tutti i token suggeriti dal drafter e produce quindi lo stesso risultato che avrebbe generato senza speculative decoding. Anche con temperature più elevate è possibile preservare la stessa distribuzione di output applicando le medesime condizioni di sampling, anche se in questo caso aumenta la probabilità che le previsioni del drafter divergano da quelle del modello principale: un maggior numero di token viene quindi rifiutato e il vantaggio prestazionale tende a ridursi. Tecnicamente il drafter DSpark utilizza una struttura semplificata basata sull’attenzione composta da quattro layer e Liquid AI raccomanda di fargli proporre gruppi di circa otto o nove token alla volta. L’estensione della tecnica dai modelli testuali ai VLM è stata resa possibile dal fatto che, una volta trasformati nella rappresentazione interna del modello linguistico, testo e immagini vengono entrambi trattati sotto forma di tensori. Il meccanismo DSpark sviluppato in precedenza per il testo ha quindi potuto essere adattato anche all’elaborazione multimodale, pur con un vincolo importante: il drafter deve essere progettato per lo specifico modello visione-linguaggio e deve essere compatibile con il relativo vision projector, per cui non è possibile prendere direttamente un drafter realizzato per un modello solo testuale e utilizzarlo senza modifiche con un VLM.
LFM2.5-VL-3B-DSpark è stato pubblicato su Hugging Face nei formati Safetensors e GGUF e può essere eseguito attraverso llama.cpp, MLX-VLM e SGLang, scelta che rende la tecnologia utilizzabile non soltanto nei data center ma anche su dispositivi basati su Apple Silicon e in altri scenari di inferenza locale. L’interesse principale riguarda proprio l’esecuzione on-device di agenti multimodali, dove la latenza nella produzione delle risposte può rappresentare uno dei principali ostacoli all’utilizzo pratico: un agente che osserva lo schermo, interpreta immagini o interfacce e deve generare rapidamente una sequenza di azioni risente particolarmente del costo del decoding ripetuto. Allo stesso tempo, i risultati mettono in evidenza anche il prossimo problema da affrontare nell’ottimizzazione dei VLM. Una volta ridotto significativamente il tempo necessario alla generazione dei token, aumentano infatti in termini relativi il peso del vision encoder e soprattutto quello della fase di prefill; per ottenere guadagni end-to-end comparabili all’accelerazione del decoding sarà quindi necessario intervenire anche su questi due passaggi. DSpark mostra così come lo speculative decoding possa essere trasferito dalla generazione testuale ai sistemi multimodali mantenendo invariata la distribuzione delle risposte, ma evidenzia contemporaneamente che l’ottimizzazione dei VLM richiede di considerare separatamente acquisizione visiva, prefill e generazione, perché accelerare soltanto l’ultima fase non elimina tutti i colli di bottiglia dell’inferenza.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)