
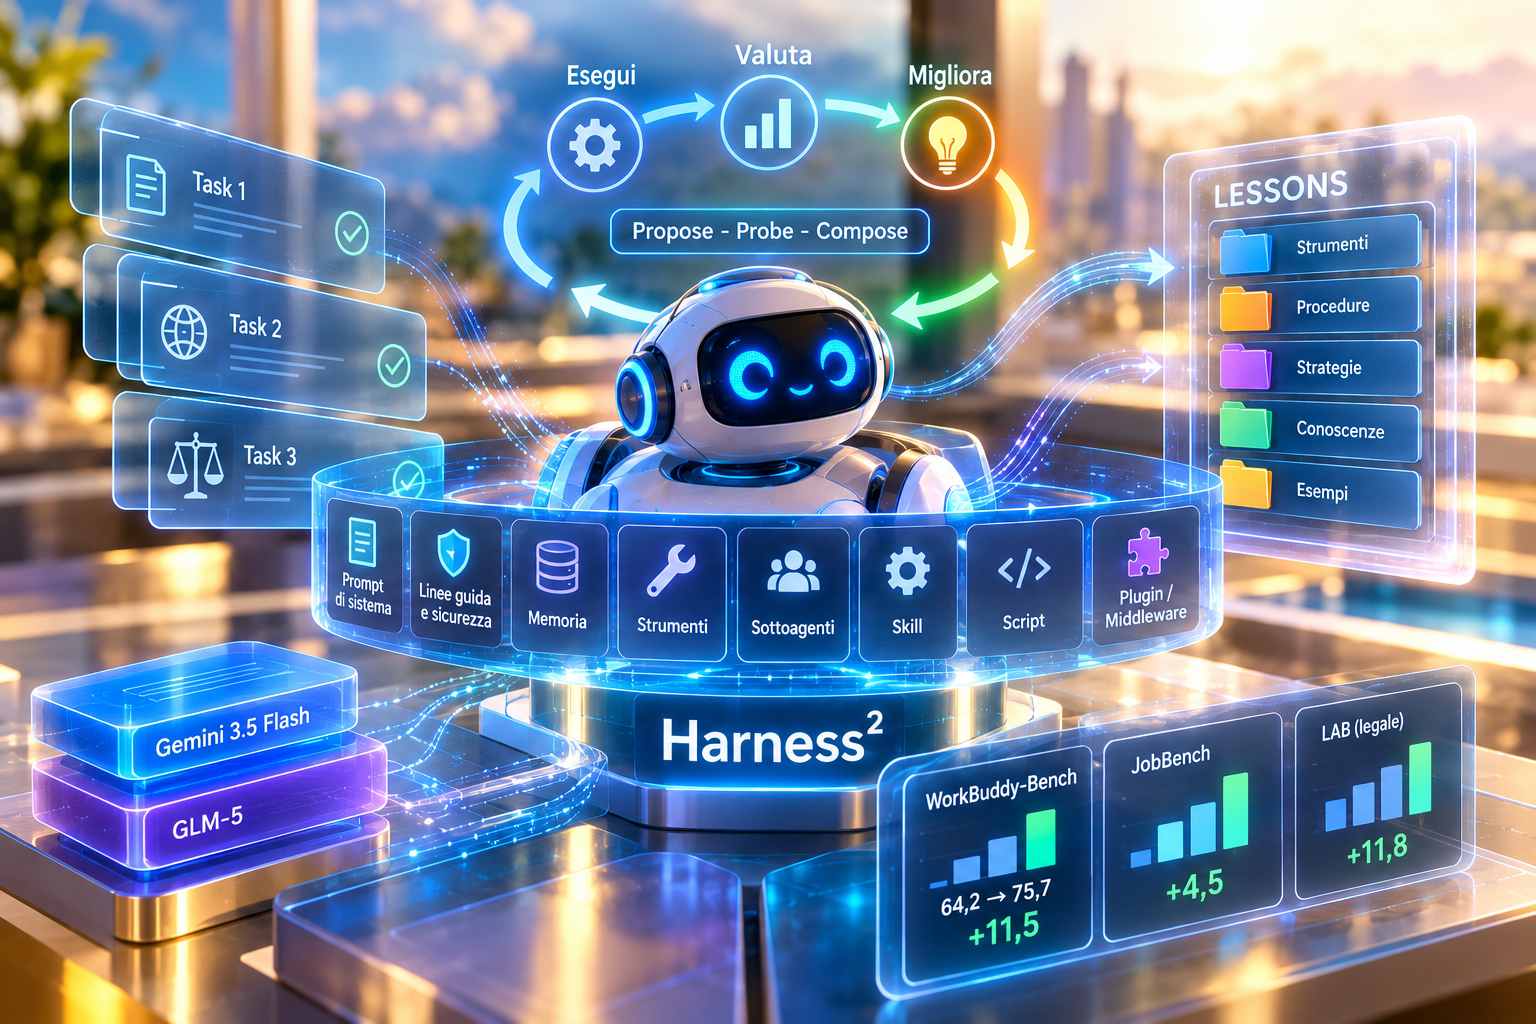
Google ha reso disponibile Harness², un framework open source progettato per consentire agli agenti di intelligenza artificiale di migliorare autonomamente le proprie modalità operative attraverso l’esperienza acquisita durante l’esecuzione dei compiti, senza modificare i pesi del modello linguistico sottostante. Il sistema interviene sull’harness, ossia l’insieme dei componenti software e delle istruzioni che regolano il funzionamento dell’agente e ne determinano le modalità di interazione con gli strumenti esterni. I ricercatori hanno identificato otto componenti principali di questo ambiente: prompt di sistema, linee guida e regole di sicurezza, memoria, istruzioni per l’utilizzo degli strumenti, sottoagenti, skill, script e componenti di tipo plugin o middleware. Questi elementi possono essere rappresentati da file montati nell’ambiente di esecuzione e modificati indipendentemente dai parametri del modello. Harness² si concentra proprio sulla possibilità di riorganizzare tali componenti sulla base dei risultati osservati nelle attività precedenti, permettendo di ottenere prestazioni differenti anche quando il modello di partenza rimane invariato.
Il framework affronta un problema caratteristico degli ambienti operativi aperti, nei quali gli agenti devono eseguire attività nuove e non sempre dispongono di una risposta corretta con cui confrontare automaticamente il risultato. Per gestire questa condizione, Google ha sviluppato una procedura di verifica contrastiva denominata Propose-Probe-Compose, che confronta il comportamento dell’agente in seguito all’applicazione di differenti modifiche all’harness. Il miglioramento avviene attraverso due livelli iterativi. Nel primo, relativo al singolo compito, l’agente esegue inizialmente il lavoro utilizzando la configurazione di base; successivamente il sistema propone due interventi alternativi, uno riguardante aspetti generali come pianificazione e utilizzo degli strumenti, l’altro destinato a migliorare conoscenze o procedure specifiche del dominio applicativo. Le configurazioni vengono sperimentate sul medesimo compito e confrontate osservando le differenze nel processo di esecuzione, così da individuare le modifiche che producono risultati migliori anche in assenza di un verificatore capace di stabilire direttamente la risposta esatta.
Il secondo livello riguarda il trasferimento delle esperienze tra attività successive. Le informazioni sulle modifiche risultate efficaci vengono registrate in una libreria persistente denominata LESSONS, che conserva indicazioni riutilizzabili relative a strumenti, procedure e strategie di esecuzione. Il sistema non applica automaticamente a ogni nuovo compito tutte le modifiche introdotte in precedenza: ciascuna attività riparte dall’harness di base e utilizza le esperienze accumulate per proporre nuovamente gli adattamenti pertinenti. Questa impostazione è progettata per limitare il rischio che una configurazione particolarmente efficace in uno scenario produca effetti indesiderati in condizioni differenti. Il miglioramento non consiste quindi nell’accumulazione indiscriminata di istruzioni, ma nella selezione contestuale delle modifiche attraverso confronti sperimentali.
Google ha valutato Harness² utilizzando tre benchmark dedicati ad attività professionali, WorkBuddy-Bench, JobBench e LAB, quest’ultimo orientato alle prestazioni in ambito legale. Le prove hanno coinvolto i modelli GLM-5 e Gemini 3.5 Flash in quattro differenti combinazioni con ambienti di esecuzione agentici. Dopo un solo ciclo di miglioramento, tutte le combinazioni hanno registrato progressi nei tre benchmark, pur con entità differenti. Il risultato più significativo è stato ottenuto associando GLM-5 a OpenCode, con un punteggio WorkBuddy-Bench passato da 64,2 a 75,7, corrispondente a un incremento di 11,5 punti. Su JobBench sono stati rilevati miglioramenti fino a 4,5 punti, mentre in LAB il tasso di superamento delle prove è aumentato fino a 11,8 punti percentuali. In altre configurazioni l’effetto è risultato più contenuto: GLM-5 con Codex, per esempio, è passato da 23,6 a 24,8 punti su JobBench, con un guadagno di 1,2 punti. I ricercatori hanno osservato che un maggior numero di iterazioni e risorse dedicate alla ricerca delle modifiche potrebbe consentire ulteriori miglioramenti. Il codice del framework è stato pubblicato su GitHub per permetterne la sperimentazione con modelli e ambienti agentici esistenti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)