
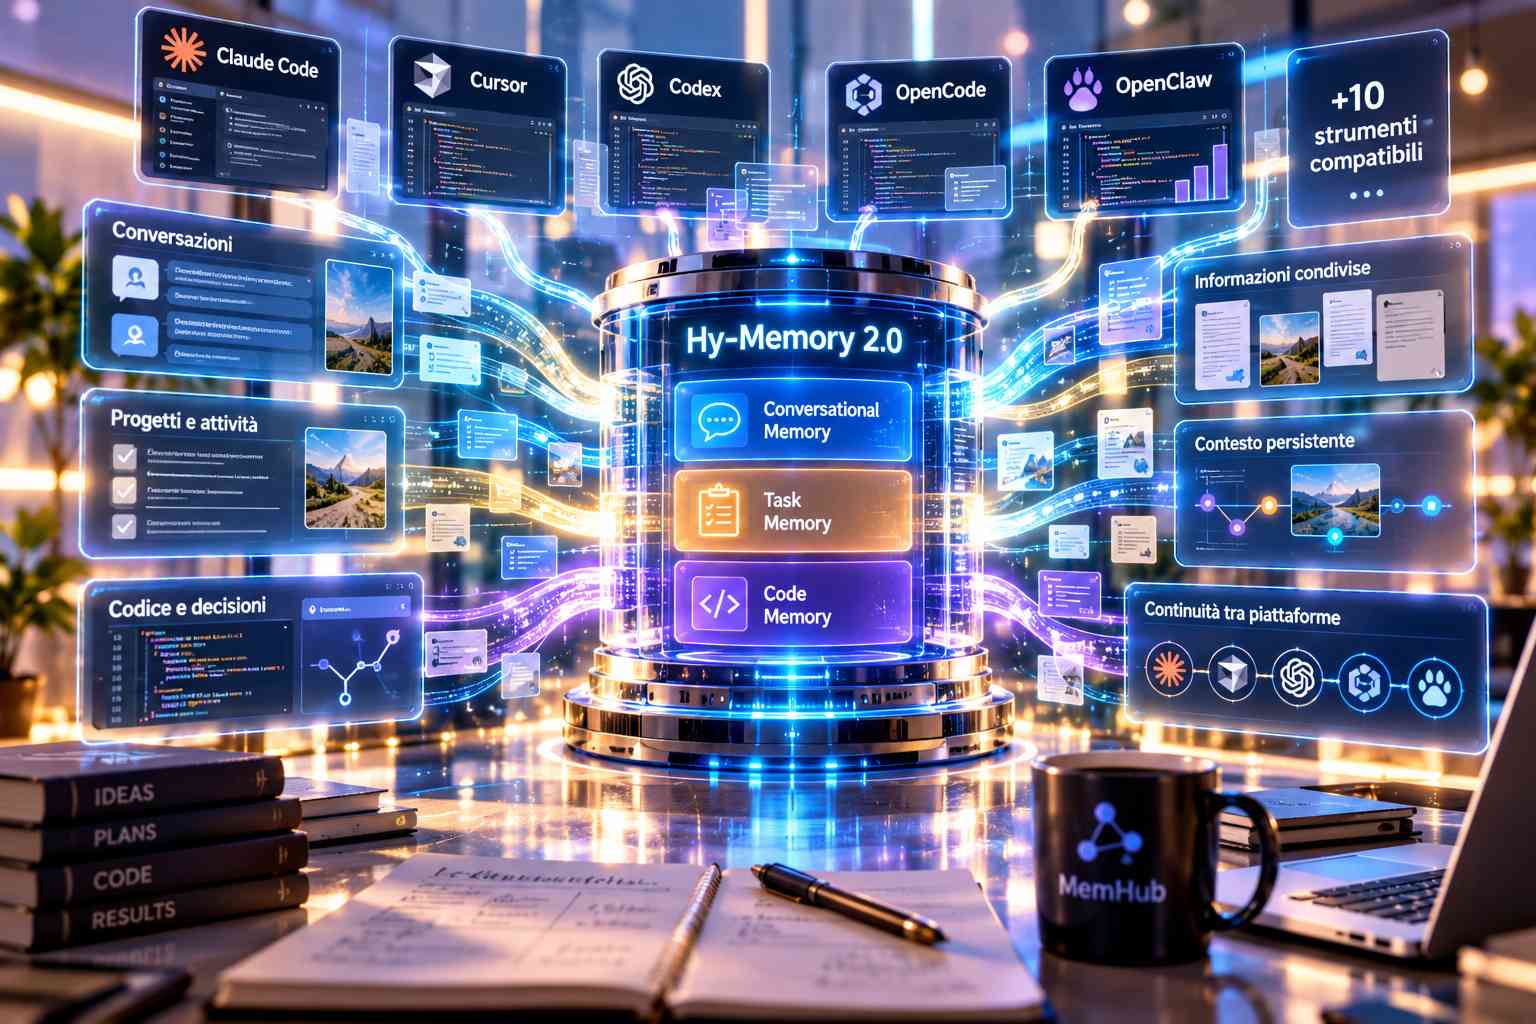
Tencent ha pubblicato Hy-Memory 2.0, un sistema open source per la gestione della memoria degli agenti di intelligenza artificiale progettato per conservare e condividere informazioni tra piattaforme differenti, superando la separazione dei dati conversazionali e operativi normalmente mantenuti all’interno dei singoli servizi. Presentata il 16 ottobre 2026, la tecnologia consente di collegare cronologie delle conversazioni, decisioni progettuali e registrazioni delle attività svolte da diversi assistenti, rendendole disponibili in un archivio comune indipendente dal modello utilizzato. L’architettura è articolata in tre componenti: un modello di intelligenza artificiale specializzato nella gestione dei ricordi, un framework dedicato all’estrazione e all’organizzazione delle informazioni e un’applicazione desktop denominata MemHub, incaricata di collegare gli strumenti compatibili. I tre livelli possono funzionare separatamente oppure essere integrati in un’unica soluzione, permettendo agli sviluppatori di adottare soltanto le componenti necessarie alle proprie applicazioni.
MemHub supporta l’integrazione con oltre dieci strumenti di intelligenza artificiale attraverso plugin agentici open source, tra cui Claude Code, Cursor, Codex, OpenCode e OpenClaw. Dopo l’autorizzazione dell’utente, il programma può importare le conversazioni precedenti e le registrazioni delle attività dai sistemi collegati, riunendole in un archivio condiviso e sincronizzando anche i nuovi dati generati durante l’utilizzo. Il sistema adotta una gestione prevalentemente locale delle informazioni e mette a disposizione un’interfaccia a riga di comando, oltre a un’applicazione per macOS. In un progetto software, per esempio, uno sviluppatore può iniziare a lavorare con Cursor e proseguire successivamente con Codex senza dover ricostruire manualmente tutte le decisioni precedenti, le modifiche apportate al codice o le attività ancora da completare. La continuità operativa dipende dalla disponibilità delle informazioni pertinenti nell’archivio condiviso, che viene mantenuto separato dai servizi di generazione utilizzati.
Il framework organizza le informazioni in tre categorie principali. La memoria conversazionale conserva gli elementi rilevanti delle interazioni passate e delle preferenze dell’utente, rendendo disponibile un contesto persistente oltre la singola sessione. La memoria delle attività registra obiettivi, decisioni, risultati intermedi ed esperienze riutilizzabili, consentendo agli agenti di ricostruire lo stato di avanzamento di un incarico articolato in più passaggi. La memoria del codice mantiene invece traccia delle modifiche software, delle procedure di correzione e delle motivazioni progettuali, così da recuperare il contesto delle scelte tecniche effettuate. Le ultime due categorie sono state introdotte o ampliate nella versione 2.0 per supportare in maniera specifica la ripresa di attività complesse. Anche la memoria conversazionale è stata aggiornata per aggregare informazioni distribuite in differenti sessioni, collegandole a riferimenti temporali, geografici e personali e gestendo duplicazioni o contraddizioni. La selezione delle informazioni da trasmettere all’agente serve inoltre a limitare l’influenza di ricordi obsoleti o non pertinenti.
Tencent ha accompagnato il framework con Hy-Memory-30B-A3B, un modello specializzato nell’estrazione, nel consolidamento, nell’aggiornamento e nella risoluzione dei conflitti tra informazioni memorizzate. Il modello utilizza un’architettura Mixture of Experts, con circa 30 miliardi di parametri complessivi e circa 3 miliardi attivati durante l’elaborazione. A differenza dei modelli principalmente destinati alla generazione delle risposte, è ottimizzato per identificare informazioni da conservare, organizzarle e gestirne le eventuali incompatibilità. I pesi sono disponibili su Hugging Face, mentre il framework, distribuito anche come pacchetto Python e SDK integrabile in altri agenti, è stato pubblicato su GitHub insieme a MemHub.
Nelle valutazioni comunicate dall’azienda, Hy-Memory ha superato i framework open source Mem0, MemOS ed EverOS in quattro benchmark dedicati alla memoria degli agenti. Su MemoryArena, che comprende attività di pianificazione di viaggi e acquisti, la memoria delle attività ha ottenuto un risultato medio del 55,31%. In CodeMemoryBench, la componente dedicata al codice ha raggiunto il 64,2% di accuratezza nelle risposte e il 35,6% di risoluzione delle attività, mentre in SWE-ContextBench ha registrato il 28,3% di compiti completati. La memoria conversazionale ha ottenuto un’accuratezza del 72,6% su LoCoMo, riducendo contemporaneamente il numero di token utilizzati per domanda da 1.159 a 703, pari a un contenimento del 39,3%. I risultati descrivono le prestazioni dichiarate nell’ambito delle configurazioni sperimentali adottate da Tencent.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)