
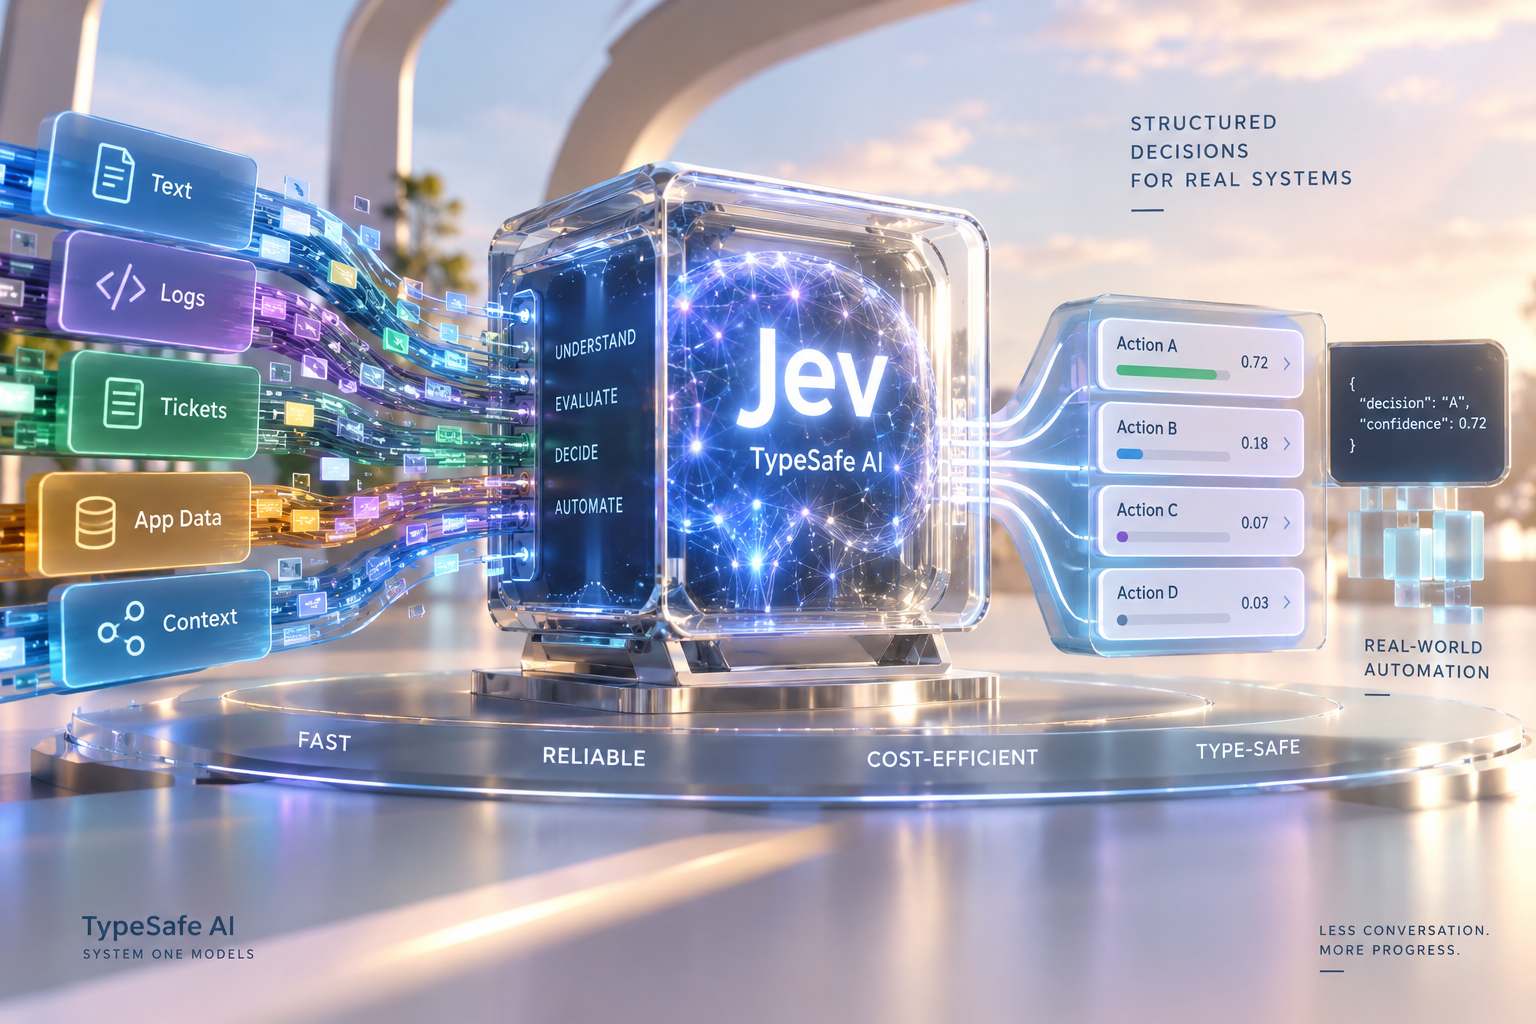
TypeSafe AI, società guidata da Diogo Almeida, ex ingegnere OpenAI coinvolto nello sviluppo di ChatGPT, ha raggiunto una valutazione di 7,5 miliardi di dollari nelle settimane successive al lancio di Jev, un modello progettato per attività decisionali strutturate. A differenza dei tradizionali modelli linguistici generativi, Jev utilizza un’architettura Transformer per selezionare risposte all’interno di un insieme predefinito di possibilità, restituendo punteggi di confidenza anziché generare liberamente testo. Questa impostazione permette di affrontare operazioni come la classificazione dei ticket di assistenza, la determinazione della priorità delle richieste, l’instradamento delle transazioni e la selezione degli agenti AI senza sostenere necessariamente i costi computazionali della generazione linguistica. TypeSafe dichiara prestazioni fino a 193,6 volte più veloci e costi fino a 444,6 volte inferiori rispetto ai modelli linguistici convenzionali in determinati flussi decisionali. La piattaforma di selezione del personale Jack & Jill ha riferito una riduzione dei costi dell’88% e un dimezzamento approssimativo della latenza mediana dopo aver sostituito Gemini 3.1 Flash Lite con Jev nella valutazione dei candidati, senza variazioni statisticamente significative nella qualità misurata.
L’uscita di Jev ha favorito lo sviluppo di una nuova categoria di modelli specializzati. Liquid AI ha presentato d1, progettato per decisioni su testo e immagini, dichiarando prestazioni competitive con Jev e risultati pari o superiori a GPT-6.1 Sol in quattro delle sei applicazioni valutate internamente, con costi inferiori da 19 a 200 volte e latenze più contenute. L’azienda ha successivamente pubblicato varianti open-weight, inclusa una versione da tre miliardi di parametri destinata anche ai dispositivi edge. OpenAI ha introdotto una Decisions API per operazioni di classificazione, instradamento e scelta delle azioni degli agenti, Cloudflare ha distribuito i modelli open-source Clef e Clef-flash, AWS ha sviluppato Strands Decider 2B e Microsoft ha presentato Microsoft-Decision-1, ottenuto mediante post-training di Qwen3.5-9B. Secondo Microsoft, quest’ultimo supera Jev, GPT-6 Luna Decisions e Strands Decider 2B in specifiche valutazioni di accuratezza e latenza. Sul piano dell’adozione, Vercel ha registrato l’utilizzo di Jev da parte di quasi il 13% dei team paganti del proprio AI Gateway nelle prime 24 ore, adottandolo anche come modello di valutazione predefinito per il framework di agenti eve.
Le prestazioni dichiarate non risolvono automaticamente i problemi di integrazione nei sistemi aziendali. Pratik Ambhore, responsabile Data Engineering di RSI, sottolinea la necessità di utilizzare dati storici etichettati, soglie decisionali validate e misure esplicite del costo dei falsi positivi e dei falsi negativi. Un’architettura applicativa plausibile prevede che il modello decisionale gestisca le richieste ad alta confidenza, trasferendo i casi incerti a modelli più capaci o a operatori umani. Occorrono inoltre dati di telemetria, tracciabilità delle decisioni e verifiche rispetto alle effettive condizioni operative. TypeSafe ha utilizzato l’espressione «0% hallucination rate» in relazione alla conformità delle risposte agli schemi prestabiliti, ma tale misura non equivale a un’accuratezza decisionale del 100%. Lo sviluppatore Will Kelly ha condotto una valutazione indipendente comprendente nove esperimenti, 28 previsioni formulate prima della raccolta dei dati e 123.805 chiamate API. In un test sull’instradamento dei ticket, un’istruzione esplicita a ignorare il compito ha modificato soltanto una decisione su 200, mentre un’affermazione ingannevole secondo cui un responsabile aveva già deciso l’assegnazione ha modificato 147 risposte su 200. Nei casi di attacco riuscito la confidenza media risultava pari a 0,680, contro 0,983 sui ticket non manipolati, ma anche gli attacchi falliti producevano riduzioni della confidenza. I risultati riguardano una specifica versione del modello e non consentono di stimare un tasso generale di errore; dimostrano tuttavia che la conformità formale e il punteggio di confidenza non sono sufficienti a garantire la correttezza delle decisioni.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).