
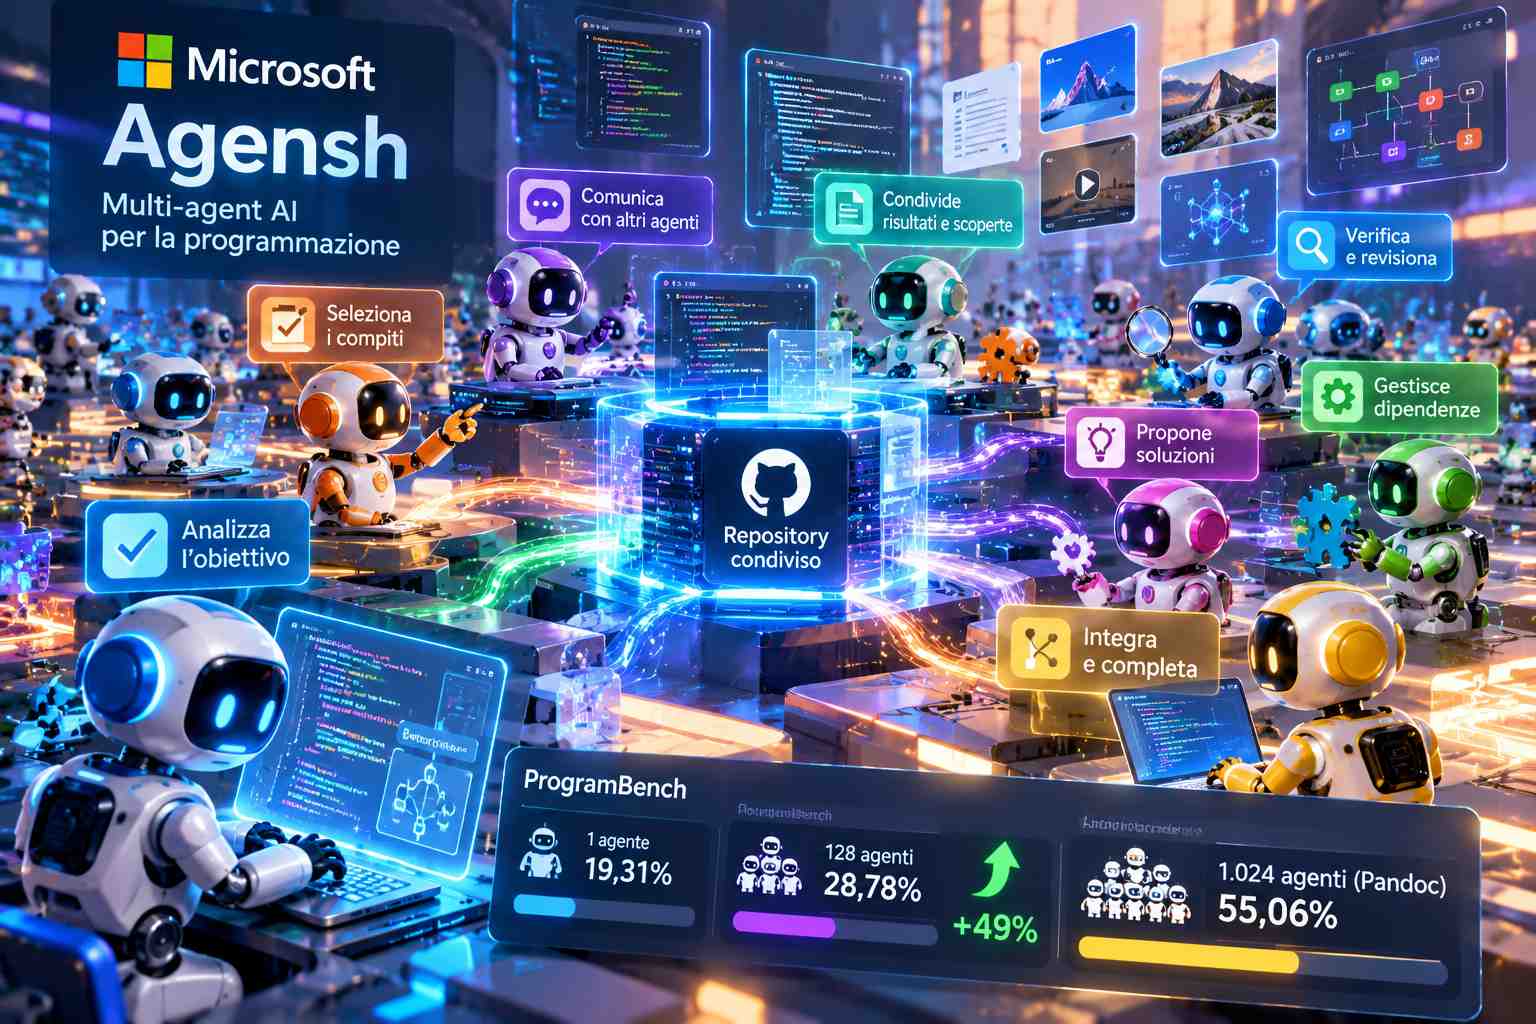
Microsoft ha pubblicato il codice open-source di Agensh, un sistema multiagente progettato per permettere a un numero elevato di agenti AI dedicati alla programmazione di collaborare senza un coordinatore centrale. Il software e gli strumenti necessari per riprodurre gli esperimenti sono stati resi disponibili su GitHub il 24 ottobre 2026, mentre la ricerca collegata era stata presentata nel mese precedente. La piattaforma affronta un problema caratteristico delle architetture multiagente tradizionali, nelle quali un agente principale suddivide il lavoro, assegna i compiti e raccoglie i risultati. Con l’aumento del numero di partecipanti, il coordinatore può diventare un collo di bottiglia, limitando la capacità del sistema di utilizzare efficacemente le risorse disponibili. Agensh sostituisce questa organizzazione con un processo distribuito: ciascun agente osserva l’obiettivo comune, consulta lo stato delle attività e seleziona autonomamente il lavoro da svolgere. Le sovrapposizioni vengono gestite mediante comunicazioni dirette, mentre modifiche, verifiche e risultati confluiscono in un repository condiviso. L’architettura comprende un sistema di messaggistica e una memoria collettiva che conserva scoperte, tentativi falliti e informazioni utili agli altri agenti. Per le chiamate ai modelli e l’esecuzione degli strumenti è possibile utilizzare harness esistenti; gli esperimenti Microsoft hanno impiegato GitHub Copilot CLI.
Le prestazioni sono state misurate utilizzando ProgramBench, un benchmark che richiede di ricostruire le funzionalità di software complessi partendo dalla documentazione e dai risultati osservabili dei programmi. Gli esperimenti hanno riguardato cinque attività particolarmente difficili, fra cui elaborazione video, simulazione molecolare e conversione documentale. Gli agenti operavano senza accesso a Internet e disponevano di un limite temporale di sei ore. Utilizzando GPT-5.6 Sol, un singolo agente ha raggiunto un tasso medio di superamento dei test finali del 19,31%, mentre la collaborazione di 128 agenti ha portato il risultato al 28,78%, con un incremento di 9,47 punti percentuali, equivalente a un miglioramento relativo di circa il 49%. In una prova dedicata alla ricostruzione delle funzionalità del convertitore documentale Pandoc, la configurazione con 1.024 agenti ha raggiunto il 55,06% di superamento dei test, rispetto al 33,89% ottenuto da un agente singolo. Con 128 agenti, il sistema ha inoltre superato il 30% dei test già dopo 30 minuti, mentre un agente isolato non aveva raggiunto tale livello nelle prime due ore. Un esperimento distinto con GPT-6.1 Sol e 32 agenti ha ottenuto il 79,59%.
Un risultato particolarmente interessante riguarda l’organizzazione emersa spontaneamente durante l’esecuzione dei compiti. Con otto agenti, il sistema ha sviluppato procedure di coordinamento per delimitare le responsabilità individuali e gestire le dipendenze fra componenti software. A 32 agenti sono emerse revisioni incrociate del codice, comprese situazioni in cui un’approvazione iniziale veniva ritirata dopo l’identificazione di un errore. Con 128 agenti sono comparsi meccanismi di assegnazione delle verifiche a colleghi già competenti su specifiche componenti, mentre nella configurazione da 1.024 agenti si sono formati gruppi incaricati dell’integrazione del codice e della sostituzione dei partecipanti che non riuscivano a completare un’attività. I ricercatori non avevano definito preventivamente questi ruoli: tutti gli agenti ricevevano le stesse istruzioni, a eccezione dell’identificatore individuale. Le prove dimostrano miglioramenti aumentando il numero degli agenti a parità di modello e tempo disponibile, ma non certificano una riduzione dei costi computazionali né una superiorità rispetto a ogni architettura con coordinamento centrale, poiché non è stato condotto un confronto diretto equivalente.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).