
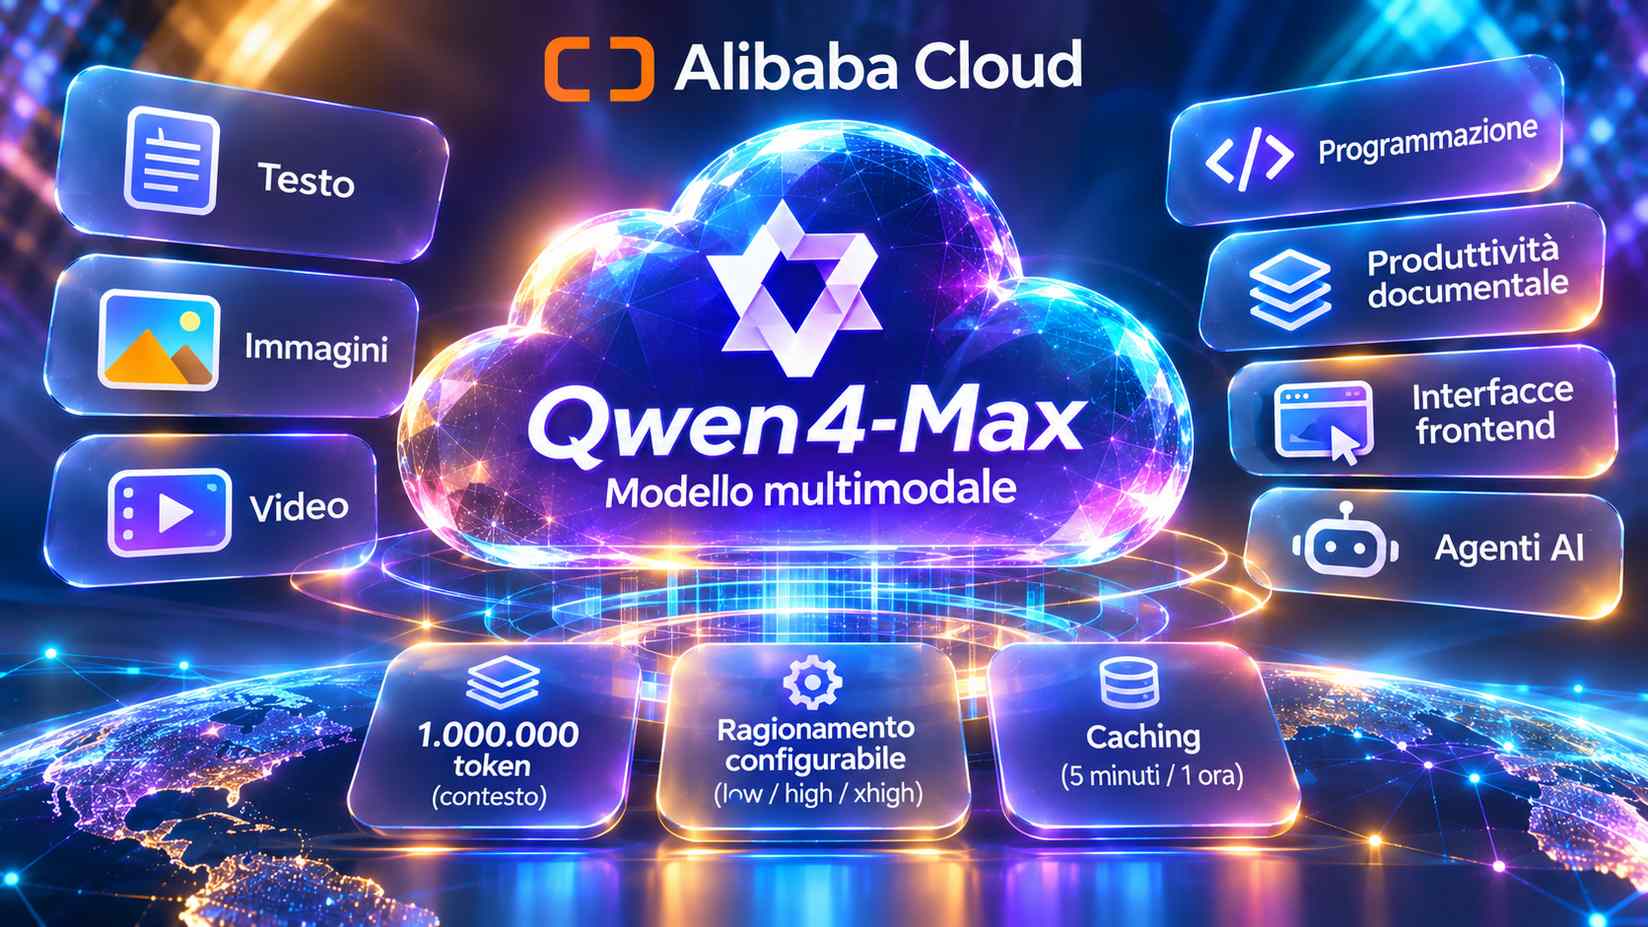
Alibaba Cloud ha introdotto Qwen4-Max, il nuovo modello multimodale di punta della famiglia Qwen, disponibile attraverso la piattaforma Model Studio dal 16 novembre 2026. Il sistema supporta una finestra contestuale di un milione di token e può elaborare contenuti testuali, immagini e video, producendo risposte testuali e dati strutturati. La nuova versione è progettata per attività di programmazione, produttività documentale, realizzazione di interfacce frontend e gestione di agenti AI impegnati in sequenze operative complesse. Qwen4-Max supporta la generazione in streaming, la ricerca sul web, l’esecuzione parallela di strumenti, il function calling, il completamento di prefissi e la produzione di strutture JSON. Per agevolare l’integrazione negli ambienti software esistenti, Alibaba Cloud rende disponibili interfacce compatibili con OpenAI Chat Completions, OpenAI Responses e Anthropic Messages, oltre alle API native DashScope.
Una caratteristica del modello riguarda la gestione configurabile del ragionamento. La modalità thinking è attiva per impostazione predefinita con intensità elevata, ma gli sviluppatori possono selezionare i livelli low, high e xhigh in funzione della complessità delle operazioni. Il budget standard destinato al ragionamento è di 131.072 token, mentre il limite complessivo condiviso fra ragionamento e risposta finale raggiunge 262.144 token. I token consumati durante l’elaborazione interna riducono quindi quelli disponibili per la risposta, rendendo la configurazione del reasoning rilevante sia per la lunghezza dei risultati sia per il consumo complessivo dell’API. Alibaba Cloud ha inoltre aggiornato le tariffe dell’area geografica di Singapore, fissando il costo di Qwen4-Max a 1,50 dollari per milione di token in ingresso e 4,50 dollari per milione di token in uscita. Rispetto ai 2 e 6 dollari previsti per Qwen3.8-Max, entrambe le componenti registrano una riduzione del 25%. Nella stessa regione è prevista una quota gratuita di un milione di token, utilizzabile entro 90 giorni dalla più recente tra l’attivazione di Model Studio, il rilascio del modello e l’approvazione dell’applicazione.
Il modello introduce inoltre opzioni di caching per ridurre il costo delle richieste che riutilizzano istruzioni di sistema, descrizioni degli strumenti o documentazione già inviata. La cache esplicita richiede prefissi di almeno 1.024 token e consente di scegliere una durata di cinque minuti oppure un’ora. I punti di interruzione definiti esplicitamente permettono di recuperare un prefisso identico durante il periodo di validità, mentre la cache implicita individua automaticamente porzioni comuni senza garantire il riutilizzo a ogni richiesta. Il caching automatico può anche collocare un punto di memorizzazione alla fine dell’input, aggiornandolo durante l’espansione progressiva di una conversazione. A Singapore la lettura dalla cache costa 0,075 dollari per milione di token, mentre la creazione di una cache esplicita costa 1,875 dollari per milione di token per la durata di cinque minuti e 3 dollari per quella di un’ora. Lo sconto si applica esclusivamente ai token di ingresso, senza modificare il prezzo di generazione dell’output.
Qwen4-Max risulta disponibile nelle regioni cloud di Pechino, Singapore, Francoforte, Virginia, Tokyo e Hong Kong. L’inferenza batch è supportata soltanto nella regione di Pechino, mentre le funzionalità di fine-tuning e distribuzione personalizzata del modello non risultano disponibili nelle regioni indicate. Per Singapore è previsto anche l’accesso mediante Personal Edition Token Plan, un piano basato su crediti utilizzabile con strumenti interattivi quali Claude Code, Cursor, Qwen Code, Qoder e OpenClaw. Questa modalità è riservata all’utilizzo interattivo degli strumenti di coding e degli agenti: non consente script di automazione, backend applicativi personalizzati o chiamate batch non interattive, che devono pertanto utilizzare l’accesso API a consumo. Il rilascio completo segue Qwen4-Max-Preview, reso disponibile l’11 novembre esclusivamente attraverso Token Plan e destinato a essere ritirato il 25 novembre 2026. La nuova offerta combina dunque una finestra contestuale estesa, strumenti di ragionamento configurabili, gestione dei prefissi memorizzati e condizioni economiche differenziate in base alla regione e alla modalità di accesso.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)