
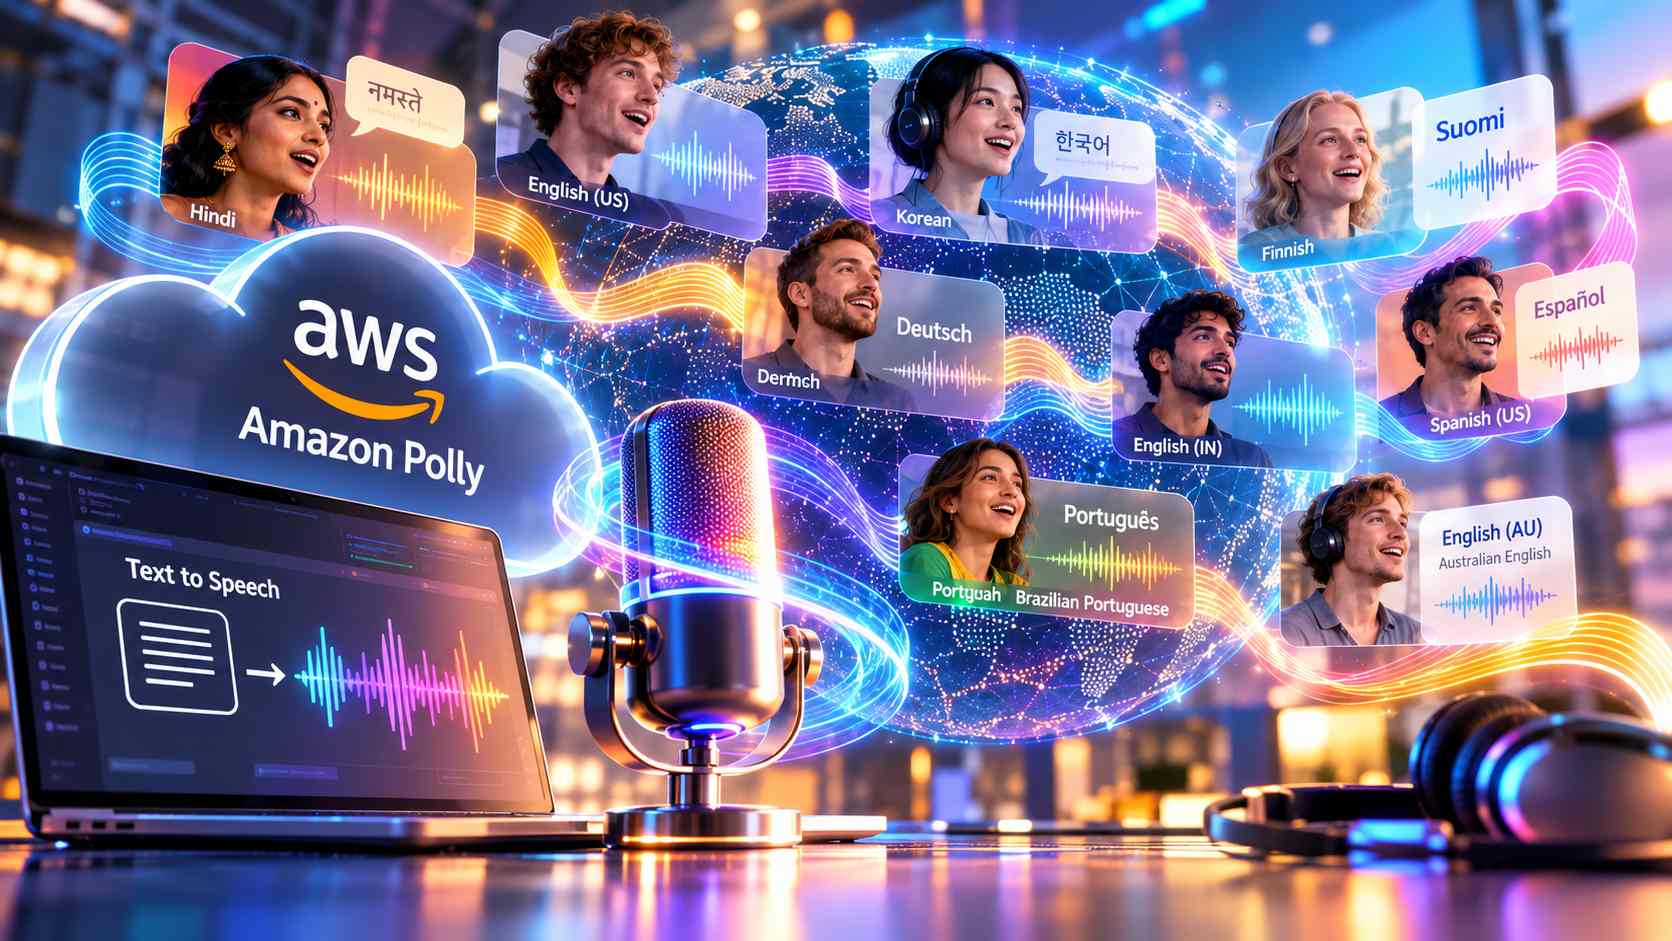
Amazon Web Services ha aggiornato il motore Generative di Amazon Polly, il servizio cloud gestito per la conversione del testo in parlato, introducendo quattordici nuove voci distribuite su nove varianti linguistiche e rendendo disponibile per la prima volta la sintesi vocale generativa in hindi e finlandese. L’aggiornamento, rilasciato il 22 ottobre 2026 e immediatamente disponibile per gli ambienti di produzione, incrementa la naturalezza dell’espressione vocale, la precisione nella lettura e la capacità di adattare automaticamente l’intonazione al contenuto semantico delle frasi. L’evoluzione riguarda soprattutto la gestione della prosodia e delle sfumature emotive: lo stesso testo può essere pronunciato con un tono neutro, incerto oppure sorpreso senza che lo sviluppatore debba configurare manualmente istruzioni espressive per ciascun passaggio. Amazon Polly è utilizzato in applicazioni di assistenza clienti, contact center, servizi di accessibilità, piattaforme didattiche, produzioni multimediali e interfacce vocali per agenti di intelligenza artificiale, nelle quali la sintesi deve combinare qualità acustica, bassa latenza e disponibilità operativa su larga scala.
Il motore Generative rappresenta la più ampia architettura di sintesi vocale sviluppata per Amazon Polly e utilizza un modello transformer con circa un miliardo di parametri, incaricato di convertire il testo grezzo in codici rappresentativi del parlato. Un decoder basato su reti convoluzionali trasforma successivamente tali codici in forme d’onda audio mediante un procedimento incrementale compatibile con lo streaming. Questa struttura permette di produrre segmenti vocali progressivamente, senza attendere necessariamente il completamento dell’intera sequenza testuale, caratteristica particolarmente rilevante per agenti conversazionali e applicazioni vocali interattive. Le migliorie comprendono anche la pronuncia di informazioni strutturate, come numeri di tracciamento, date, intervalli orari, importi monetari e indirizzi postali. Tra le dimostrazioni disponibili figurano le voci Tiffany e Kenneth, utilizzate rispettivamente per una presentazione vocale e per la lettura di una conferma d’ordine contenente dati logistici e commerciali.
Le nuove voci comprendono Kenneth e Nate per l’inglese statunitense, Russell e Curtis per l’inglese australiano, Kiara e Arjun per l’inglese indiano, Tina per il tedesco, Carlos per lo spagnolo statunitense, Leo e Carolina per il portoghese brasiliano, Hyunduk per il coreano, Kiara e Arjun per l’hindi e Suvi per il finlandese. Con queste aggiunte, il catalogo Generative raggiunge complessivamente 57 voci, distribuite su undici lingue e venticinque varianti locali. La disponibilità geografica delle nuove voci comprende undici regioni AWS: US East nella Virginia settentrionale, US West in Oregon, Europe Frankfurt, Europe Zurich, Europe London, Asia Pacific Sydney, Seoul, Singapore e Tokyo, Canada Central e AWS GovCloud US-West. L’espansione in GovCloud amplia inoltre le possibilità di impiego negli ambienti che richiedono infrastrutture cloud specificamente dedicate a organizzazioni governative statunitensi.
L’aggiornamento è stato progettato per preservare la compatibilità con le applicazioni esistenti. Gli identificativi delle voci già disponibili e le chiamate API rimangono invariati, consentendo agli sviluppatori di ottenere le migliorie del motore senza modificare il codice delle integrazioni. La generazione tradizionale continua a utilizzare l’API SynthesizeSpeech con il parametro engine impostato su generative, mentre l’API bidirezionale StartSpeechSynthesisStream consente di inviare progressivamente testo al servizio e ricevere simultaneamente i segmenti audio prodotti. Quest’ultima modalità è destinata soprattutto agli agenti vocali basati su modelli linguistici, ai sistemi conversazionali in tempo reale e ai personaggi interattivi dei videogiochi, nei quali i contenuti da pronunciare vengono generati dinamicamente. Rimane disponibile il supporto ai tag Speech Synthesis Markup Language per il controllo dettagliato della sintesi, mentre le voci generative utilizzano una frequenza di campionamento predefinita di 24 kHz e supportano i formati MP3, OGG Vorbis e PCM non compresso.
AWS ha mantenuto inalterato il modello tariffario, senza introdurre costi aggiuntivi, nuove categorie di prodotto o modifiche contrattuali legate all’aggiornamento. I contenuti vocali statici possono essere memorizzati nella cache e riprodotti successivamente senza ulteriori costi di generazione. Rimangono tuttavia alcune limitazioni funzionali: le voci generative non supportano ancora gli speech marks, disponibili invece per le voci Standard e Neural, e non comprendono lo stile di lettura newscaster. Anche lo streaming bidirezionale è disponibile soltanto in determinate regioni. AWS precisa inoltre che gli aggiornamenti dei modelli e dei dati di addestramento possono introdurre lievi variazioni nella timbrica delle voci nel tempo, elemento da considerare quando vengono prodotti contenuti articolati in più sessioni, come podcast seriali o raccolte audio che richiedono continuità espressiva.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)