
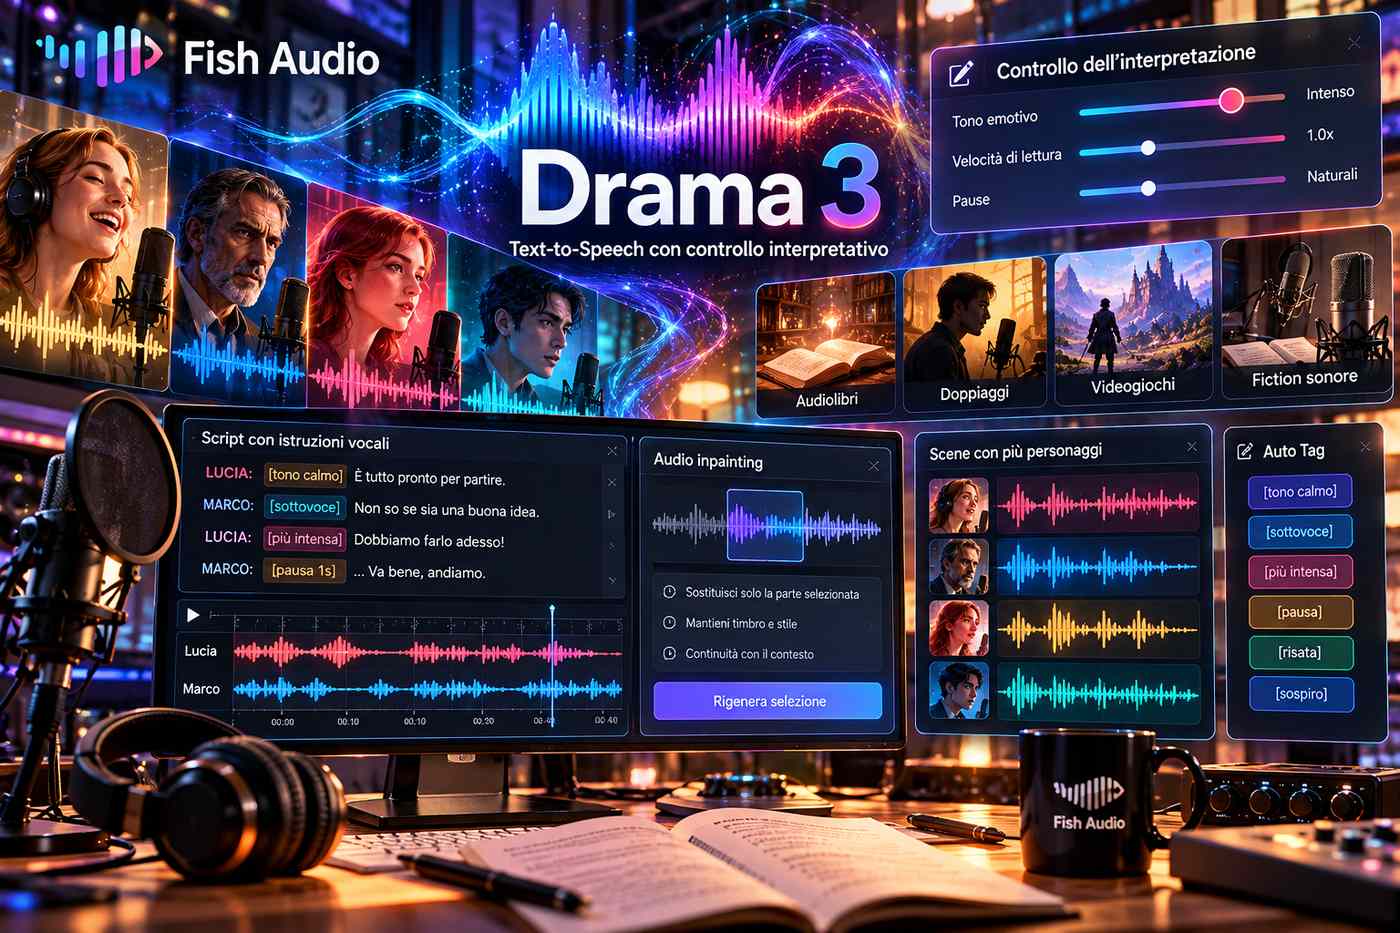
Fish Audio lancia Drama 3, un modello di sintesi vocale text-to-speech progettato per consentire il controllo delle interpretazioni vocali attraverso istruzioni in linguaggio naturale e modifiche mirate delle registrazioni sintetiche. Il sistema è destinato alla produzione di audiolibri, doppiaggi, videogiochi e fiction sonore, con funzionalità per definire il tono emotivo, la velocità di lettura, le pause e le caratteristiche espressive dei personaggi. Il modello permette inoltre di generare scene con più interlocutori e di intervenire su una singola parola o su una breve sezione di un audio già prodotto, evitando di rigenerare l’intera registrazione. Questa funzionalità, denominata audio inpainting, è stata sviluppata per conservare la continuità timbrica ed espressiva del materiale circostante e ridurre la necessità di ricostruire un’intera performance dopo una correzione del testo o della pronuncia.
La direzione vocale di Drama 3 consente agli autori di descrivere il comportamento interpretativo desiderato direttamente nella sceneggiatura. Le istruzioni possono riguardare l’intensità, il ritmo, il carattere della voce o il cambiamento delle emozioni durante una frase. Un personaggio può, per esempio, iniziare un dialogo con un tono calmo e passare progressivamente a una condizione di panico senza richiedere la generazione separata delle due porzioni. Nell’interfaccia pubblica di anteprima, le indicazioni relative a pause, suoni e modalità interpretative possono essere inserite tra parentesi quadre, mentre apposite coppie di tag permettono di applicare effetti a parole o espressioni specifiche. È quindi possibile delimitare una porzione da pronunciare sottovoce, enfatizzare un termine oppure rallentare soltanto una frase. Una funzione denominata Auto Tag suggerisce automaticamente una prima serie di indicazioni interpretative, che possono essere successivamente riviste e modificate da chi prepara il copione.
L’audio inpainting costituisce una delle principali novità operative della piattaforma. Dopo aver generato una registrazione, l’utente può selezionare il segmento che richiede una correzione, modificarne il testo o le istruzioni vocali e chiedere al modello di produrre soltanto la parte interessata. Il sistema utilizza le informazioni acustiche precedenti e successive alla sezione selezionata per adattare il nuovo contenuto all’intonazione, al ritmo e all’identità della voce originale. Questo permette, almeno secondo le capacità dichiarate da Fish Audio, di correggere la pronuncia di un nome, sostituire una parola o cambiare un’espressione senza alterare le parti già approvate. Il problema affrontato è diverso dalla semplice creazione di una nuova clip audio: il segmento sostitutivo deve inserirsi in una performance preesistente senza generare discontinuità percettibili nei punti di collegamento, preservando andamento prosodico, tempi e caratteristiche vocali.
Drama 3 comprende anche la generazione di scene complete con più personaggi in un’unica elaborazione. Ogni interlocutore mantiene una propria identità vocale e la risposta viene prodotta tenendo conto del contesto del dialogo precedente, evitando di trattare ogni battuta come una registrazione indipendente. Fish Audio dichiara inoltre il supporto alla continuità dei personaggi nei copioni lunghi, ai cambiamenti di lingua all’interno della stessa scena e al controllo della pronuncia a livello di fonemi. Fra le lingue espressamente considerate figurano inglese, cinese, giapponese e coreano. La gestione del contesto conversazionale è destinata a mantenere coerenti non soltanto il timbro associato a ciascun personaggio, ma anche la relazione espressiva fra battute successive, comprese esitazioni, reazioni e cambiamenti emotivi.
La nuova soluzione prosegue lo sviluppo tecnologico già intrapreso con Fish Audio S2, nel quale erano state introdotte istruzioni in linguaggio naturale associate a posizioni specifiche del testo. La precedente ricerca aveva descritto un’architettura dual-autoregressiva capace di separare la previsione della sequenza audio dalla produzione dei dettagli acustici, accompagnata da tecniche di reinforcement learning per migliorare intelligibilità, rispetto delle istruzioni e somiglianza vocale. Drama 3 estende il controllo dell’esecuzione alla revisione selettiva delle performance già generate e alla gestione coordinata di più voci. Fish Audio non ha tuttavia presentato, nell’annuncio, una valutazione indipendente che quantifichi l’affidabilità delle correzioni di singole parole su accenti, timbri e transizioni fonetiche differenti, né risultati misurati sulla riduzione dei tempi di produzione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)