
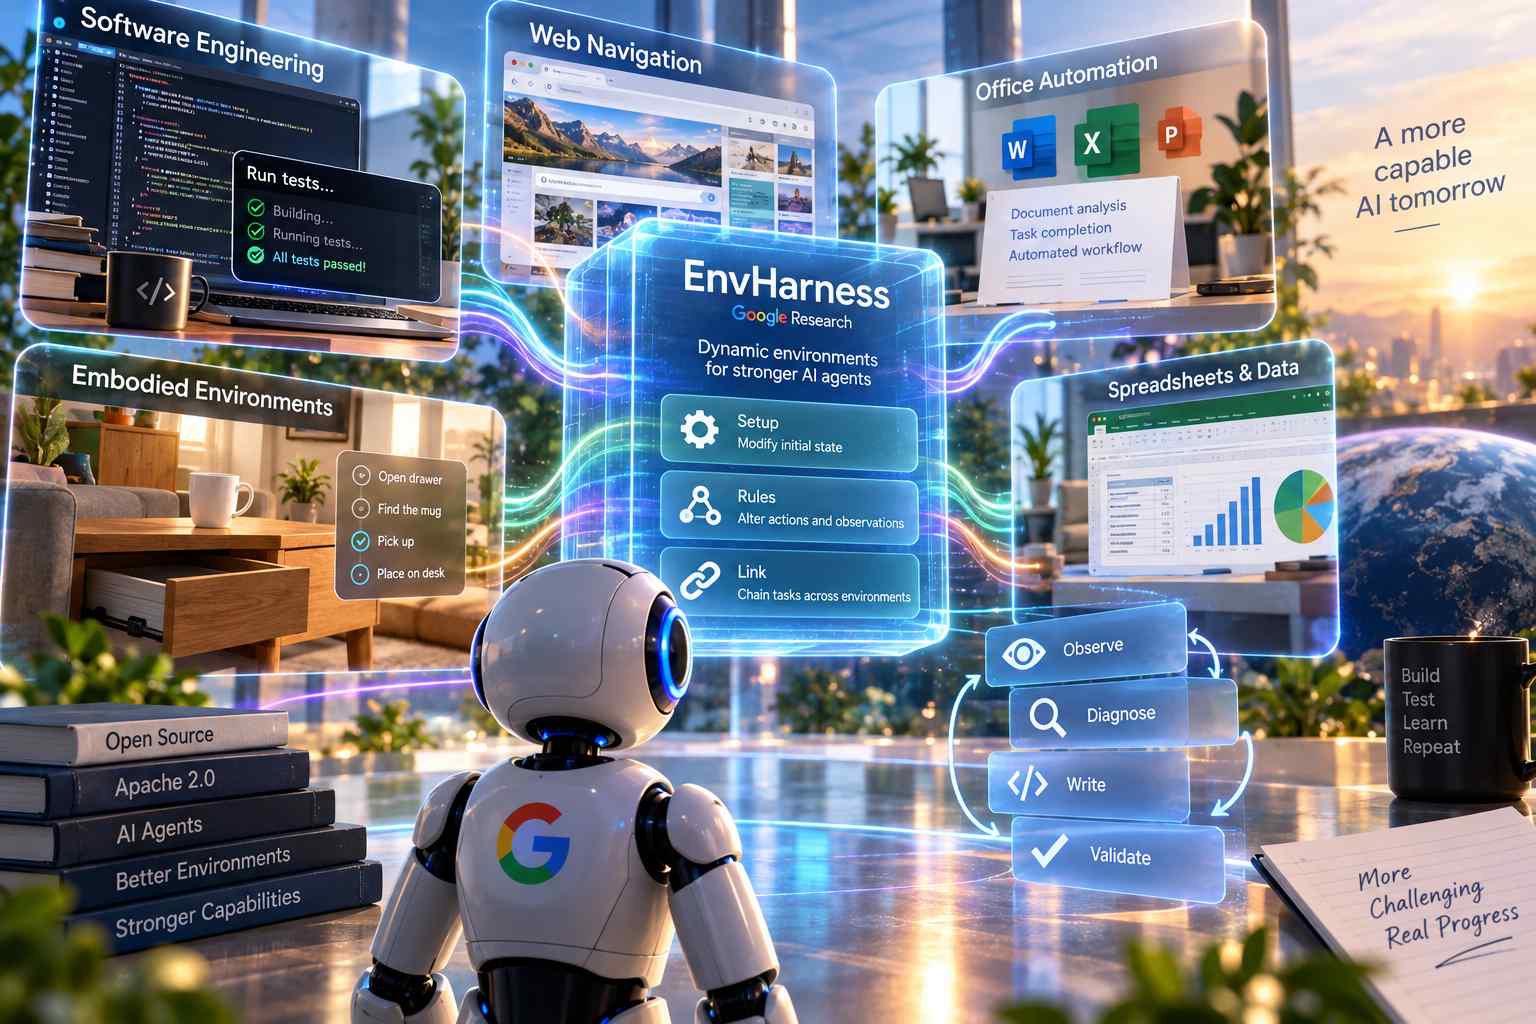
Google Research ha rilasciato EnvHarness, un framework open source con licenza Apache 2.0 progettato per rendere dinamici gli ambienti utilizzati nell’addestramento degli agenti AI senza modificarne il codice interno, i task originali o i sistemi di verifica. Gli agenti destinati ad attività come sviluppo software, navigazione web, automazione d’ufficio o interazione con ambienti simulati imparano normalmente attraverso ripetute interazioni con sandbox nelle quali possono eseguire azioni, ricevere osservazioni, fallire e riprovare. La costruzione di questi ambienti è però costosa, soprattutto quando è necessario disporre di verificatori affidabili capaci di determinare se un compito è stato completato correttamente, e una volta creati tendono a rimanere statici anche mentre le capacità dell’agente migliorano. Un agente che abbia già imparato a risolvere gran parte dei task disponibili riceve quindi progressivamente meno segnali utili per continuare ad apprendere, mentre i casi realmente difficili diventano sempre più rari e richiedono di campionare quantità crescenti di esperienze per individuare nuove debolezze. EnvHarness interviene su questo problema aggiungendo uno strato programmabile tra l’agente e un ambiente esistente, in modo da modificarne dinamicamente le condizioni operative attorno agli errori e ai limiti osservati, mantenendo però intatto il verificatore umano già utilizzato per stabilire il successo del task.
L’impostazione riprende il concetto di agent harness, cioè il livello software che circonda un modello linguistico aggiungendo strumenti, memoria, gestione del contesto e cicli di esecuzione senza modificarne necessariamente i pesi. EnvHarness applica lo stesso principio al lato opposto dell’interazione: invece di trasformare il modello, rende programmabile l’ambiente in cui il modello opera. Il framework espone una singola interfaccia standard, ActionableEnv, e inserisce componenti che possono modificare lo stato iniziale, le azioni consentite, gli effetti delle azioni e le osservazioni ricevute dall’agente. Nel repository questi componenti sono denominati Setup, Rules e Link. Setup modifica il punto di partenza del task riproducendo una sequenza di azioni durante il reset; Rules intercetta ogni passaggio dell’interazione e può cambiare o filtrare azioni, transizioni e osservazioni; Link consente invece di concatenare task appartenenti a un altro ambiente all’interno dello stesso episodio. I diversi livelli possono essere impilati liberamente perché ogni EnvHarness continua a presentarsi all’esterno come un normale ActionableEnv, mentre il task sottostante, le sue dinamiche fondamentali e soprattutto il criterio utilizzato per verificare il risultato rimangono invariati.
Un esempio riguarda ALFWorld, benchmark nel quale un agente deve svolgere attività domestiche simulate attraverso comandi testuali. Se il task originale richiede di mettere una tazza pulita su una scrivania e la tazza si trova inizialmente in una posizione immediatamente visibile, EnvHarness può modificare lo stato iniziale collocandola dentro un cassetto chiuso, costringendo l’agente a cercarla prima di completare l’obiettivo. Lo stesso meccanismo può essere utilizzato nella direzione opposta, completando automaticamente la prima parte di un compito per concentrare l’addestramento sulle fasi successive. Un componente Rules può invece nascondere una parte delle informazioni presenti nella descrizione della stanza, eliminare scorciatoie nella navigazione o impedire temporaneamente determinate azioni, obbligando l’agente a raccogliere informazioni aggiuntive. Attraverso Link è infine possibile concatenare più obiettivi, ad esempio facendo seguire al posizionamento della tazza un secondo task che richiede di riscaldare una patata e collocarla su un piano di lavoro. Il risultato è una traiettoria più lunga nella quale l’agente deve conservare più obiettivi, pianificare le azioni e gestire il proprio budget operativo senza che sia necessario costruire da zero un nuovo simulatore.
L’adattamento automatico dell’ambiente viene gestito da EnvRigger, un agente progettista che tratta la policy da migliorare come una black box e utilizza un ciclo Observe, Diagnose, Write e Validate. Il sistema esegue inizialmente più rollout dell’agente, analizza sia le traiettorie riuscite sia quelle fallite e cerca pattern ricorrenti che permettano di individuare una debolezza specifica. Una volta identificato il problema, EnvRigger scrive codice Python che implementa nuovi componenti EnvHarness, li applica all’ambiente e avvia ulteriori rollout per verificare che la modifica generi un esempio realmente utile, sufficientemente difficile ma ancora risolvibile. Il designer non seleziona quindi soltanto condizioni da un insieme prefissato, ma può produrre direttamente nuove regole eseguibili, che vengono compilate e lanciate in un subprocess isolato in modo che eventuali errori della modifica producano una traccia registrabile invece di interrompere l’intero processo. Negli esperimenti descritti dai ricercatori il ciclo di base parte da cinque esecuzioni sul task originale e da cinque nuove esecuzioni della variante proposta; se questa risulta impossibile, troppo semplice o incapace di produrre un segnale di apprendimento utile, EnvRigger può modificarla nuovamente ed effettuare fino a cinque iterazioni successive di scrittura e validazione.
Nel caso di un agente di coding, per esempio, il sistema può accorgersi che il modello tende a modificare il codice e inviare immediatamente la patch senza eseguire prima i test. EnvRigger può allora generare una regola che intercetta la richiesta di submission e restituisce un avviso finché l’agente non abbia eseguito la suite di test, costringendolo a esercitare proprio il comportamento che tendeva a evitare. La modifica non interviene sul repository, sul codice sorgente o sui test scritti dagli sviluppatori: viene applicata soltanto all’interfaccia attraverso la quale l’agente opera, mentre gli unit test originali continuano a stabilire se la patch sia effettivamente corretta. Lo stesso principio è stato utilizzato nella navigazione web. In WebArena i ricercatori hanno definito una debolezza nella quale l’agente rispondeva prima di scorrere l’intera pagina e perdeva quindi informazioni collocate sotto la parte inizialmente visibile; EnvHarness ha generato una regola che impediva determinate azioni di recupero delle informazioni finché non fosse stato effettuato lo scrolling, producendo così nuove traiettorie nelle quali l’agente imparava a ispezionare il contenuto in modo più completo prima di rispondere.
La valutazione è stata condotta su cinque benchmark distribuiti in quattro aree: ALFWorld per i task embodied simulati, WebArena per la navigazione web, SWE-bench Verified per lo sviluppo software, OfficeQA per il lavoro d’ufficio e SpreadsheetBench per le attività sui fogli di calcolo. Nei principali esperimenti le traiettorie generate dagli ambienti modificati venivano trasformate in competenze riutilizzabili attraverso una pipeline ispirata a ReasoningBank e le skill apprese con EnvHarness hanno superato sia la baseline priva di skill sia quelle estratte dagli ambienti originali su tutti e cinque i benchmark, con miglioramenti fino a 9 punti percentuali sui task held-out e una riduzione media del 9,8% del numero di passaggi di interazione. Su SWE-bench Verified la lunghezza media delle traiettorie è scesa da 55,01 a 49,61 step e EnvHarness ha superato SWE-smith, sistema dedicato alla generazione di ambienti per software engineering, di 2,46 punti percentuali utilizzando in media 5,11 passaggi in meno per episodio. Su ALFWorld il vantaggio medio rispetto a GenEnv, un metodo che utilizza un modello linguistico come simulatore per generare dinamicamente transizioni e osservazioni, è stato di 5,7 punti.
I risultati più significativi emergono quando l’adattamento viene ripetuto man mano che l’agente migliora. Su SWE-bench Verified la policy iniziale partiva da un tasso di successo del 47,67% e raggiungeva il 54,79% quando il pool di addestramento EnvHarness veniva ampliato fino a 300 ambienti modificati. Con lo stesso numero di ambienti originali il risultato arrivava al 52,13%, mentre gli ambienti generati attraverso SWE-smith si fermavano al 50,37%. Secondo i ricercatori, la differenza deriva dal fatto che gli ambienti statici o generati da una distribuzione fissa tendono progressivamente a esaurire i casi informativi, mentre EnvHarness continua a costruire nuove condizioni attorno alle capacità raggiunte dalla policy dopo ogni fase di apprendimento. Nei primi cicli di un agente di coding possono quindi emergere problemi elementari come l’omessa esecuzione dei test o la modifica non corretta dei file, mentre nelle fasi successive vengono individuate debolezze differenti, come test runner non funzionanti, limiti di risorse o la scelta dell’interprete Python corretto. Il paper riporta inoltre risultati positivi nell’uso degli ambienti dinamici come segnale per il reinforcement learning, indicando che il framework non è vincolato alla sola estrazione di skill dalle traiettorie.
EnvHarness non costituisce però un sistema di addestramento completo e non modifica autonomamente la policy che utilizza l’ambiente. Le esperienze generate devono essere abbinate a un meccanismo capace di trasformarle in cambiamenti dell’agente, come estrazione di skill o memoria, fine-tuning, reinforcement learning o altre tecniche di aggiornamento. Per questo motivo il framework può essere utilizzato insieme ai sistemi che intervengono direttamente sull’agent harness, tra cui approcci come Self-Harness, HarnessX e DarwinX: questi modificano regole, workflow o scaffolding sul lato dell’agente, mentre EnvHarness cambia le condizioni con cui l’agente deve confrontarsi. Le due direzioni possono quindi operare in modo complementare, con l’ambiente che espone una debolezza, un sistema agent-side che modifica il comportamento per correggerla e EnvHarness che genera successivamente nuove condizioni capaci di mettere alla prova la policy aggiornata. Il repository comprende inoltre un’implementazione per esperimenti di reinforcement learning basata sull’infrastruttura verl-agent, utilizzata per integrare gli ambienti EnvHarness nei rollout e nell’addestramento delle policy.
L’adozione in ambienti aziendali richiede principalmente due tipi di integrazione. Il primo consiste nel collegare il simulatore esistente all’interfaccia ActionableEnv attraverso un Bridge; il progetto include già bridge per differenti runtime, compresi ambienti Docker utilizzati con SWE-bench, OfficeQA e SpreadsheetBench. Nei workflow software containerizzati lo strato può essere collocato esternamente rispetto all’immagine Docker o Kubernetes già esistente, lasciando quindi invariati repository, test interni e runner e limitandosi a intercettare i comandi all’interfaccia. Il secondo costo riguarda invece la capacità di calcolo necessaria a EnvRigger, perché ogni modifica richiede più esecuzioni dell’agente per osservare il problema, formulare una trasformazione e verificare che il nuovo ambiente rimanga valido e risolvibile. Questo requisito rende EnvHarness particolarmente adatto a sandbox digitali nelle quali il reset dello stato è economico e affidabile, come ambienti di coding, simulazioni per l’uso di strumenti e sistemi di test per l’automazione web. L’esecuzione diretta del ciclo diagnostico su database di produzione, account reali dei clienti, sistemi con effetti irreversibili o robot fisici richiederebbe invece una copia ripristinabile, un tenant di test o un simulatore sicuro.
Il codice, le configurazioni sperimentali e l’implementazione dedicata al reinforcement learning sono disponibili pubblicamente nel repository google-research/envharness con licenza Apache 2.0. Il progetto specifica inoltre di non essere un prodotto Google ufficialmente supportato. L’obiettivo non è sostituire gli ambienti costruiti manualmente, che continuano a fornire task e verificatori considerati affidabili, ma aumentarne la quantità di esperienza utile ricavabile senza dover progettare continuamente nuovi simulatori. L’approccio differisce quindi dai sistemi che generano interamente nuovi mondi di addestramento: EnvHarness mantiene congelato l’ambiente di base e programma soltanto il livello attraverso il quale l’agente lo vede e vi agisce, consentendo allo stesso insieme di task di evolvere insieme alle capacità della policy e di continuare a produrre esempi mirati anche quando i problemi originari sono già stati appresi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)