
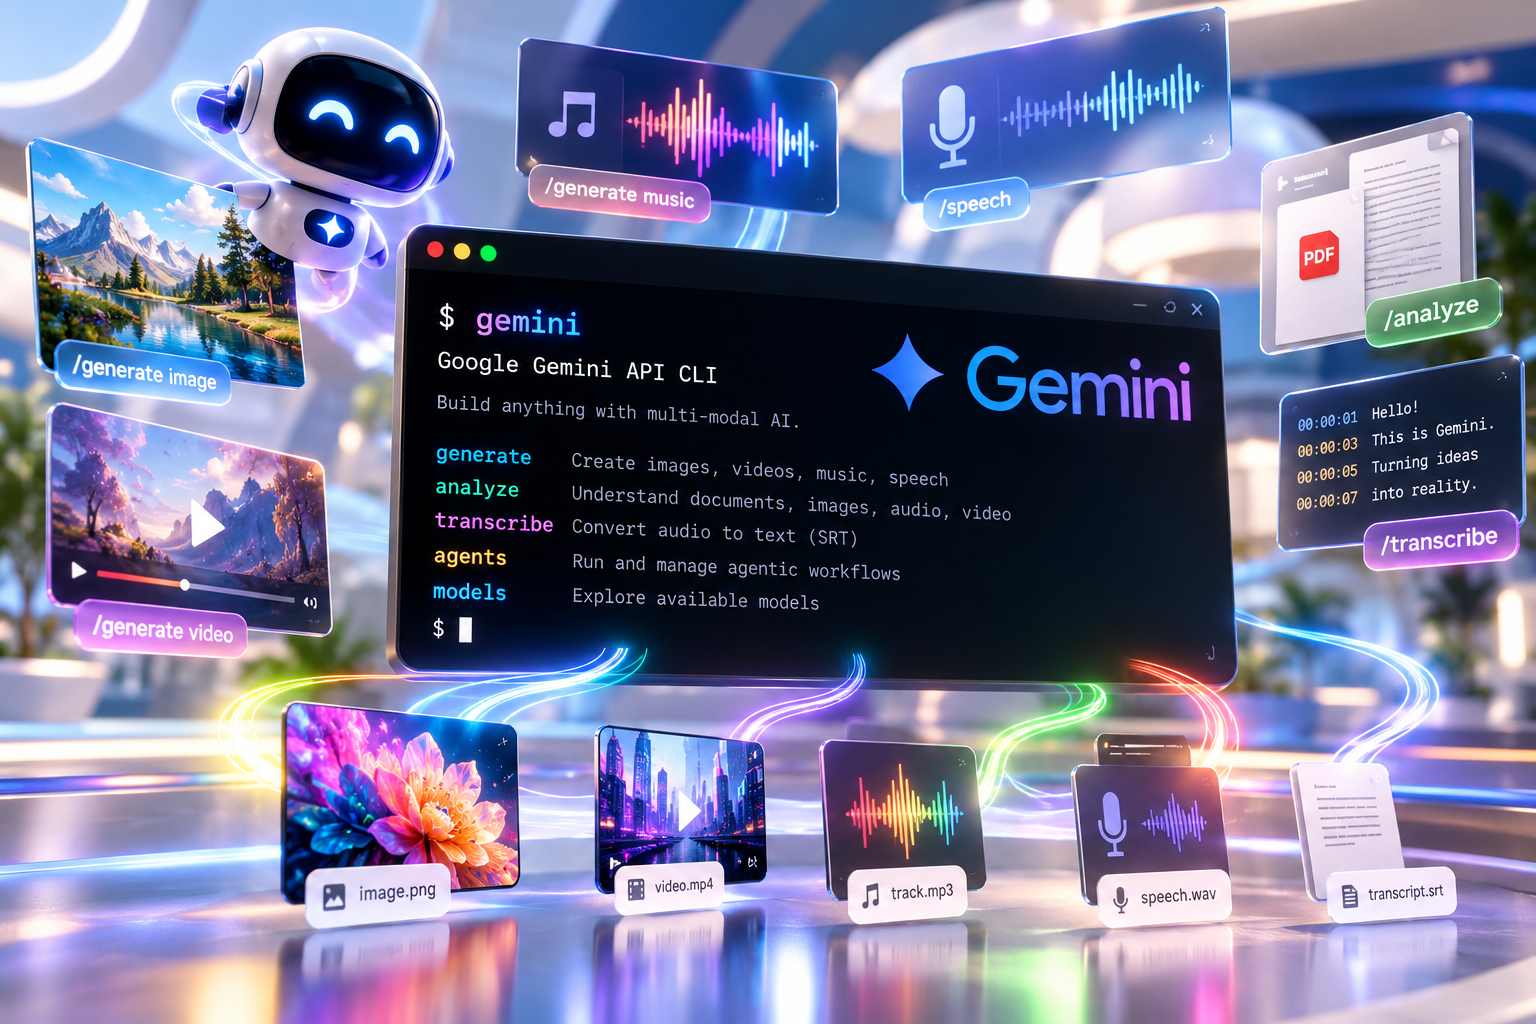
Google ha presentato Gemini API CLI, uno strumento a riga di comando progettato per rendere accessibili le funzionalità delle API Gemini direttamente dal terminale e dagli ambienti operativi utilizzati dagli agenti di intelligenza artificiale. Distribuito inizialmente come preview sperimentale della serie 0.4.x, il progetto consente di eseguire operazioni di generazione di immagini, video, musica e sintesi vocale, oltre ad analizzare documenti, trascrivere registrazioni audio e gestire processi agentici attraverso comandi di shell. L’interfaccia è disponibile per macOS, Linux e Windows mediante eseguibili binari utilizzabili senza installare preventivamente dipendenze aggiuntive, mentre gli sviluppatori possono scegliere anche un’installazione a partire dal codice sorgente. Lo strumento è pubblicato con licenza open source Apache 2.0 e viene distribuito attraverso GitHub, permettendo alla comunità degli sviluppatori di esaminare, modificare ed estendere le funzionalità disponibili. L’obiettivo tecnico consiste nel semplificare l’accesso ai servizi di intelligenza artificiale da parte dei programmi che operano attraverso il terminale, riducendo la necessità di scrivere script temporanei, utilizzare ripetutamente richieste HTTP tramite curl oppure individuare manualmente gli identificatori dei modelli necessari per ciascuna operazione.
Gemini API CLI si colloca all’interno di un ecosistema di sviluppo articolato su tre livelli distinti. Il primo è costituito dalle API Gemini, responsabili dell’accesso ai modelli di inferenza, elaborazione multimodale, generazione dei contenuti e gestione degli agenti. Il secondo comprende i Google Generative AI SDK, disponibili per Python, TypeScript, Go e Java, che forniscono librerie strutturate e interfacce tipizzate destinate soprattutto allo sviluppo di applicazioni, servizi backend e sistemi di produzione. Il terzo livello è rappresentato dalla nuova CLI, destinata agli sviluppatori che lavorano attraverso la shell e agli agenti autonomi in grado di invocare comandi di sistema. Rispetto agli SDK tradizionali, lo strumento privilegia un’interfaccia priva di stato persistente tra le invocazioni, con comandi riconoscibili e formati di input e output prevedibili, caratteristiche che permettono ai sistemi agentici di individuare le operazioni disponibili e utilizzarle all’interno di workflow automatizzati. Attraverso il terminale è quindi possibile esplorare i modelli disponibili, eseguire test sui prompt, inviare contenuti multimodali alle API e acquisire risultati che possono essere elaborati direttamente da ulteriori comandi o applicazioni. La CLI riduce inoltre la necessità di gestire le risposte multimediali attraverso lunghe rappresentazioni testuali dei dati codificati, restituendo riferimenti ai file prodotti e rendendoli immediatamente disponibili per le operazioni successive.
Le funzionalità di generazione multimediale comprendono l’integrazione con diversi modelli specializzati di Google. Per la produzione di immagini è previsto l’utilizzo di Nano Banana 2.1, mentre la generazione video è affidata a Gemini Omni 1.1 Flash. Le operazioni di composizione musicale possono essere eseguite attraverso Lyria 3.5, mentre Gemini 3.8 Flash TTS fornisce le funzionalità di sintesi vocale. Il sistema può produrre parlato articolato su più interlocutori, permettendo di realizzare tracce audio contenenti dialoghi tra diversi speaker, e generare composizioni strumentali utilizzabili come accompagnamento musicale. Quando viene richiesta la creazione di immagini o video, i risultati sono salvati come file e i relativi percorsi vengono restituiti nell’output del comando, consentendo agli agenti di accedere ai contenuti generati senza introdurre ulteriori passaggi di decodifica o conversione. La stessa interfaccia supporta attività di comprensione e analisi di contenuti già esistenti, tra cui documenti PDF, immagini e registrazioni audio. I file possono essere utilizzati come input per operazioni di sintesi, estrazione delle informazioni e conversione del parlato in testo. Per la trascrizione audio è prevista anche la generazione di file di sottotitoli SRT comprensivi di marcatori temporali, mentre le funzionalità di analisi comprendono anche contenuti video pubblicati su YouTube.
Uno degli aspetti principali del progetto è la possibilità di integrare queste capacità nei framework agentici già utilizzati dagli sviluppatori, senza vincolare l’esecuzione esclusivamente agli strumenti proprietari Google. Qualsiasi agente in grado di eseguire comandi di shell può potenzialmente invocare Gemini API CLI, e Google indica esplicitamente la compatibilità con ambienti quali Claude Code, Codex, OpenClaw, Hermes e Cursor. La CLI può inoltre essere utilizzata all’interno di Antigravity, l’ambiente di sviluppo agentico Google, consentendo a un agente di richiedere la generazione di immagini o video, effettuare analisi documentali e avviare operazioni audio, ricevendo in risposta i percorsi dei file generati o gli identificatori associati ai processi. In questo modo i risultati possono essere trasferiti alle fasi successive di una procedura automatizzata senza richiedere un intervento manuale per il recupero degli output. L’integrazione nativa con Antigravity è prevista per una fase successiva, mentre la modalità attualmente disponibile si basa sull’invocazione dello strumento attraverso l’ambiente operativo. La CLI permette anche di delegare attività di ricerca e programmazione articolate a Managed Agents eseguiti attraverso servizi dedicati. Per operazioni come Deep Research è possibile avviare un processo, acquisire l’identificatore dell’interazione e utilizzarlo successivamente per verificare lo stato di avanzamento e recuperare risultati strutturati, mantenendo separata l’invocazione iniziale dalla raccolta dell’elaborazione completata.
La progettazione della CLI comprende inoltre funzionalità destinate a rendere più prevedibile e verificabile l’automazione dei comandi. Gli sviluppatori e gli agenti possono consultare localmente l’elenco delle operazioni e delle opzioni disponibili, senza dover effettuare interrogazioni online per comprendere la struttura delle richieste. Il parametro –schema consente di esaminare il formato previsto per una determinata operazione, mentre –dry-run permette di verificare la validità di una richiesta senza inoltrarla alla rete, limitando il rischio di chiamate API errate o non intenzionali durante la preparazione dei workflow. Gli output possono essere restituiti in formato JSON oppure TOON, mentre l’opzione –jq consente di estrarre selettivamente i campi necessari e trasferirli ad altri processi. L’autenticazione viene configurata attraverso una chiave Gemini API memorizzata in una variabile d’ambiente, nel portachiavi del sistema operativo oppure in un file di configurazione, con la disponibilità anche di una procedura interattiva di impostazione iniziale. La versione sperimentale 0.4.x introduce quindi un’interfaccia attraverso la quale gli agenti possono utilizzare servizi multimodali e processi gestiti mediante comandi strutturati, senza dover implementare ogni volta un’applicazione dedicata per richiamare le API. Il progetto rimane in fase preview e Google prevede di svilupparne ulteriormente le capacità sulla base dei riscontri ricevuti dagli utilizzatori e dei contributi della comunità open source.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)