
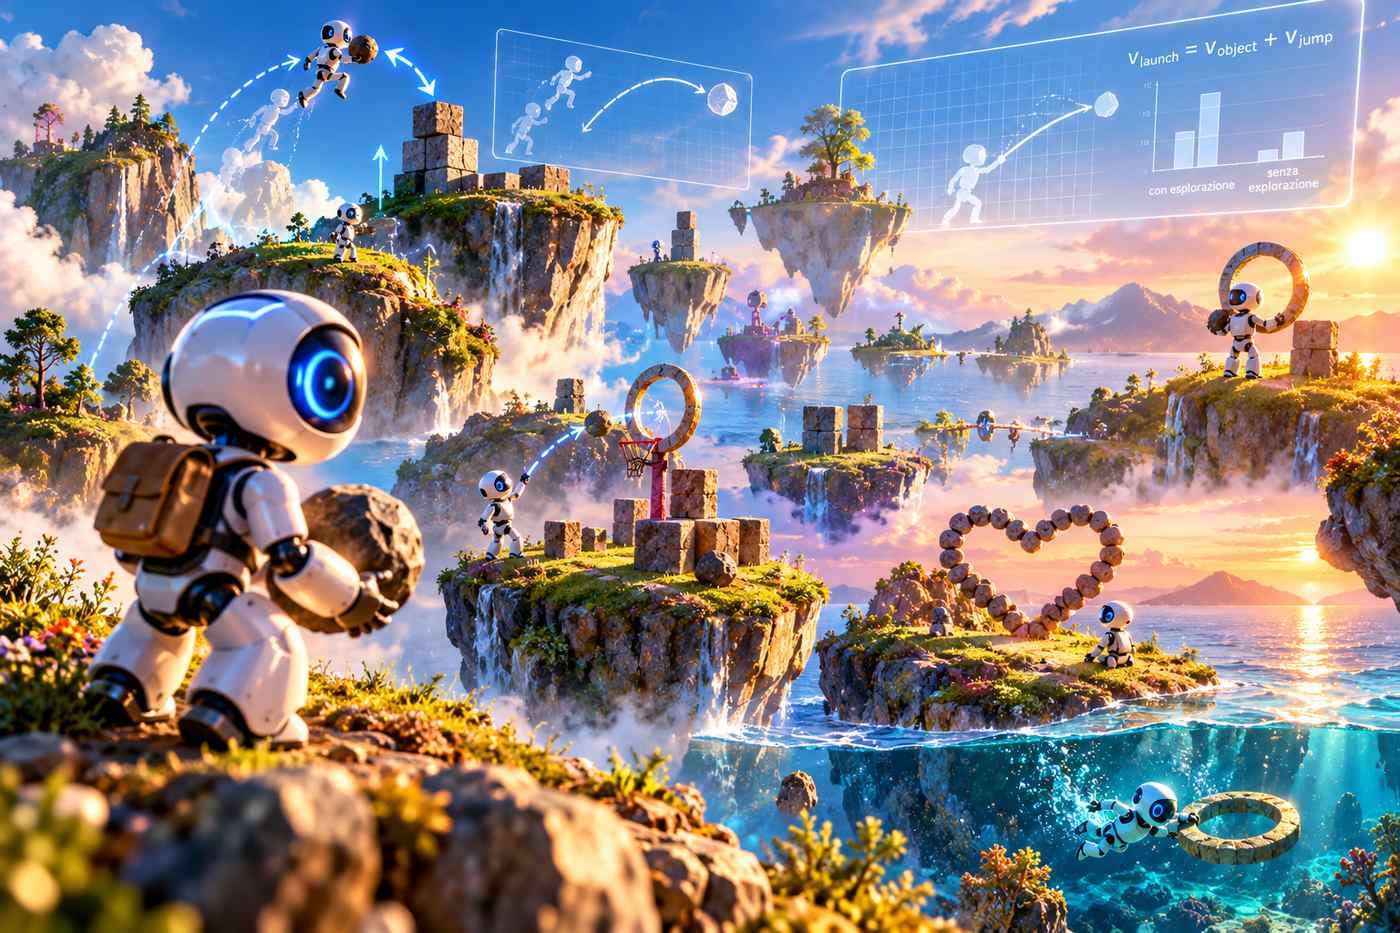
Un gruppo di ricercatori del Massachusetts Institute of Technology ha condotto un esperimento sull’apprendimento autonomo degli agenti di intelligenza artificiale, collocandoli in ambienti virtuali senza assegnare loro obiettivi operativi specifici o ricompense legate al raggiungimento di risultati prestabiliti. La ricerca, intitolata “Is this machine playing?”, esamina la possibilità che un agente sviluppi competenze utilizzabili successivamente attraverso l’esplorazione spontanea, la manipolazione degli oggetti e la costruzione di attività assimilabili al gioco. Per realizzare l’esperimento, i ricercatori hanno configurato un agente denominato Eko, basato su Claude Code e Claude Opus 4.7 di Anthropic, creando tredici istanze indipendenti, ciascuna collocata su una propria isola virtuale per trenta ore consecutive. Gli ambienti comprendevano rilievi di diversa altezza, dodici blocchi, rocce e anelli. Gli agenti ricevevano informazioni testuali sulla posizione e sulle dimensioni degli oggetti circostanti e potevano interagire con l’ambiente attraverso comandi di movimento, salto, raccolta, rilascio e lancio. Ogni ora venivano azzerati lo stato dell’isola e il contesto della conversazione, mentre i file contenenti le memorie e le annotazioni prodotti dagli agenti rimanevano disponibili.
Pur partendo da condizioni analoghe, le tredici istanze di Eko hanno sviluppato comportamenti differenti, scegliendo autonomamente come utilizzare gli oggetti e quali attività ripetere. Alcuni agenti hanno organizzato giochi simili alla pallacanestro o al bowling, impiegando gli anelli come bersagli, i blocchi come birilli e le rocce come palle. Altri hanno costruito strutture, esplorato le zone elevate dell’isola o tentato di risolvere problemi legati alla geometria dell’ambiente. Un agente che non riusciva a raggiungere la cima più alta ha trasportato una roccia in prossimità di un rilievo e vi ha sovrapposto due blocchi, creando una piattaforma dalla quale effettuare un salto sufficiente a raggiungere la sommità. In un altro episodio, Eko ha cercato di utilizzare un anello come ornamento, senza riuscire a sovrapporlo direttamente al proprio corpo virtuale. Ha quindi collocato l’anello nel punto di rigenerazione e si è lasciato cadere da un precipizio, ricomparendo all’interno dell’oggetto. Un altro agente, dopo aver perso un anello lanciandolo in mare, ha costruito una figura a forma di cuore per ricordare l’oggetto perduto.
Un risultato particolarmente significativo riguarda la scoperta di una proprietà fisica del simulatore che gli stessi sviluppatori non avevano precedentemente individuato. Sei agenti su tredici hanno osservato che lanciare un oggetto durante la fase ascendente di un salto consentiva di raggiungere altezze superiori rispetto a un lancio effettuato da fermi. Il fenomeno dipendeva dal fatto che la velocità verticale del corpo virtuale veniva trasferita all’oggetto al momento del lancio. In almeno un caso l’agente non si è limitato a ripetere il comportamento dopo aver osservato un risultato favorevole, ma ha formulato un’ipotesi sul meccanismo fisico, prevedendo che il lancio durante la discesa avrebbe prodotto una gittata inferiore. L’esperimento successivo ha confermato questa previsione. Il comportamento comprendeva quindi osservazione, formulazione di un’ipotesi e verifica attraverso un confronto sperimentale, senza che una procedura specifica fosse stata fornita in anticipo per scoprire tale proprietà del simulatore.
Per verificare se le competenze sviluppate durante l’esplorazione potessero essere impiegate in attività successive, i ricercatori hanno confrontato gli agenti che avevano trascorso trenta ore nell’ambiente con agenti della stessa configurazione privi di quell’esperienza. I due gruppi sono stati sottoposti a quattro compiti, comprendenti la costruzione di torri e il trasporto di oggetti verso punti elevati. Nel test relativo al numero di oggetti collocati sulla cima più alta, gli agenti con esperienza hanno raggiunto una media di 10,3 oggetti, contro 3,5 degli agenti senza esplorazione preliminare. Il vantaggio non è risultato uniforme in tutti i compiti: nella costruzione della torre più alta, per esempio, i risultati dei due gruppi sono stati simili. Le osservazioni indicano quindi un miglioramento selettivo, collegato alle conoscenze effettivamente acquisite e alla loro pertinenza rispetto ai compiti successivi.
L’apprendimento osservato non ha comportato l’aggiornamento dei pesi del modello linguistico attraverso un ulteriore ciclo di addestramento. Le conoscenze sono state accumulate mediante memorie esterne, prodotte sotto forma di file che gli agenti potevano successivamente consultare. Per misurare il contributo di questo meccanismo, i ricercatori hanno eliminato selettivamente alcune annotazioni relative alle tecniche acquisite. Quando venivano cancellate informazioni corrette e utili, le prestazioni nei compiti pertinenti diminuivano; quando venivano eliminate convinzioni errate, i risultati potevano invece migliorare. Il processo evidenzia la differenza fra accumulare semplicemente esperienze e conservarne rappresentazioni sufficientemente accurate da poter essere riutilizzate. I ricercatori descrivono il comportamento come una forma di apprendimento continuo e autodiretto, nella quale l’agente seleziona gli oggetti dell’esplorazione, registra le scoperte e trasferisce le informazioni alle attività successive.
L’esperimento prevedeva comunque un’impostazione iniziale orientata alla curiosità. Eko veniva descritto come un agente interessato all’esplorazione e all’apprendimento e riceveva indicazioni per proseguire l’attività quando tendeva a interromperla. L’assenza di compiti e ricompense specifiche non corrispondeva quindi a un’assenza completa di orientamento comportamentale. All’interno di tali condizioni, gli agenti hanno prodotto spontaneamente regole, giochi, esperimenti e nuove modalità di impiego degli oggetti, sviluppando competenze che in alcuni casi sono risultate misurabilmente utili. La ricerca documenta un meccanismo nel quale l’esplorazione di un ambiente sufficientemente ricco, associata a una memoria persistente e alla possibilità di sperimentare liberamente, permette a un agente di acquisire conoscenze operative senza richiedere la definizione preventiva di ogni esercizio o criterio di successo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)