
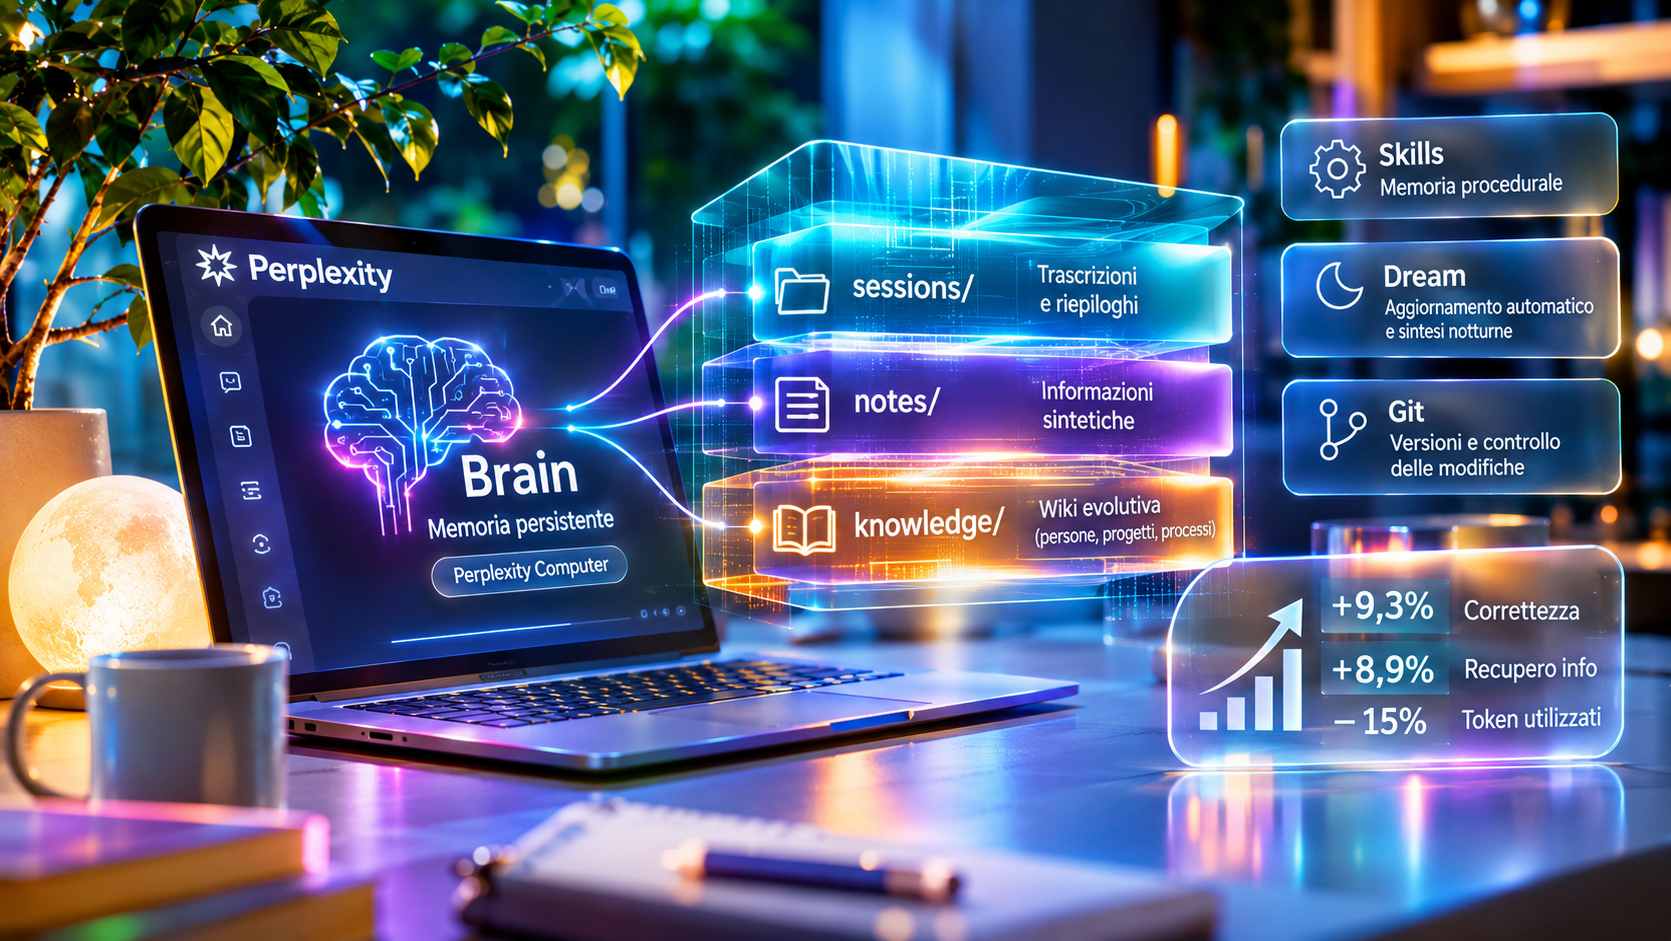
Perplexity ha reso disponibili nuovi dettagli tecnici sul funzionamento di Brain, il sistema di memoria persistente integrato in Perplexity Computer, e sulle modalità attraverso le quali gli sviluppatori possono costruire meccanismi analoghi utilizzando Agent API. Brain è progettato per trasformare le attività precedenti di un agente, le correzioni ricevute e le informazioni recuperate attraverso strumenti e documenti in una base di conoscenza progressivamente aggiornata. L’architettura non modifica direttamente i pesi del modello linguistico, ma utilizza informazioni conservate all’esterno del modello e recuperate quando risultano pertinenti alla richiesta corrente. Questo meccanismo, definito da Perplexity memoria a livello di token, consente di aggiornare le conoscenze operative dell’agente intervenendo sui contenuti memorizzati, senza effettuare un nuovo addestramento. La struttura principale è costituita da una raccolta di documenti interconnessi che assume la forma di una wiki evolutiva, nella quale possono essere registrati progetti, persone, procedure, decisioni, risultati di attività precedenti e modifiche intervenute nel tempo. L’obiettivo è rendere utilizzabile l’esperienza accumulata attraverso sessioni differenti, evitando che ogni nuovo incarico debba ricostruire da zero informazioni già acquisite e verificate.
Brain organizza le informazioni all’interno della sandbox dell’agente attraverso tre livelli distinti di archiviazione. La directory sessions/ conserva le trascrizioni originali delle sessioni e i relativi riepiloghi, costituendo la componente episodica della memoria, nella quale vengono registrate le attività effettivamente svolte. La directory notes/ raccoglie informazioni sintetizzate e organizzate per argomento, mentre knowledge/ contiene pagine Markdown collegate tra loro che descrivono persone, progetti, concetti e conoscenze consolidate, formando la memoria semantica. A queste componenti si aggiunge la memoria procedurale, rappresentata dalle Skills e dalle istruzioni salvate che definiscono come l’agente deve eseguire determinate operazioni. L’aggiornamento della base di conoscenza è affidato anche ad agenti automatici denominati Dream, che elaborano durante la notte i registri delle attività giornaliere, generano sintesi e propongono modifiche ai contenuti esistenti. Le variazioni vengono sottoposte a controlli prima della registrazione tramite Git, permettendo di conservarne il confronto con le versioni precedenti. Ogni informazione memorizzata mantiene inoltre un collegamento alla propria origine, così da consentire la verifica delle fonti. Il processo può confermare dati ancora validi, sostituire informazioni modificate o segnalare contenuti non più aggiornati.
Perplexity ha comunicato i risultati di una valutazione comparativa condotta nell’arco di trenta giorni, nella quale le sessioni che utilizzavano Brain hanno registrato un miglioramento di 9,3 punti percentuali nella correttezza delle risposte e di 8,9 punti percentuali nella capacità di recuperare informazioni rilevanti, accompagnato da una riduzione approssimativa del 15% dei token utilizzati. Un’ulteriore prova interna ha preso in esame 150 domande relative a documenti finanziari, confrontando un agente capace di esplorare i file attraverso strumenti ordinari con un sistema basato sulla ricerca semantica nello stesso insieme documentale. Il primo ha raggiunto un punteggio di risposta pari a 0,627, contro circa 0,37 ottenuto dalla ricerca semantica. I risultati sono stati presentati dalla società come evidenze dell’utilità di una memoria organizzata e della possibilità di esplorare direttamente i documenti, ma appartengono a valutazioni interne e non dimostrano che lo stesso vantaggio possa essere riprodotto in ogni ambiente applicativo o per tutte le tipologie di informazioni.
Per gli sviluppatori che utilizzano Agent API, Perplexity distingue esplicitamente gli strumenti disponibili dalla soluzione Brain integrata in Computer. L’API non comprende infatti un sistema di memoria autonomo capace di mantenersi e aggiornarsi senza interventi applicativi. Offre invece componenti per definire procedure versionate, conservare il contesto conversazionale e collegare l’agente a sistemi di archiviazione controllati dallo sviluppatore. Una Skill personalizzata può riunire istruzioni, procedure e file di supporto identificati da una specifica versione, mentre un Profile conserva sotto un identificativo versionato la configurazione complessiva dell’agente, comprendente modello, istruzioni, strumenti, Skills, connettori e parametri di esecuzione. Le Skills non apprendono automaticamente dall’esperienza, ma cambiano quando viene caricata una nuova versione delle istruzioni o dei materiali associati. Per mantenere il contesto tra richieste consecutive, l’applicazione può includere manualmente nell’array di input i messaggi precedenti ritenuti utili, eventualmente riassumendoli o eliminando informazioni non necessarie, oppure utilizzare il parametro previous_response_id, che consente al servizio di ricostruire lo stato della conversazione conservato sui server di Perplexity senza richiedere la ritrasmissione dell’intera cronologia. Le nuove istruzioni, le definizioni degli strumenti e le eventuali impostazioni del modello necessarie alla richiesta successiva devono comunque essere fornite.
La costruzione di una memoria episodica e semantica persistente rimane responsabilità dell’applicazione. Attraverso il function calling, lo sviluppatore può definire operazioni di lettura della memoria prima dell’esecuzione di un’attività e operazioni di scrittura al suo completamento, registrando non soltanto le informazioni recuperate, ma anche l’esito concreto dell’operazione, la fonte utilizzata e le eventuali correzioni successive. Un server remoto compatibile con il Model Context Protocol può esporre le stesse operazioni di memoria senza dover creare separatamente tutte le funzioni di collegamento. L’ecosistema comprende inoltre connettori gestiti per GitHub, Slack, Google Drive, Datadog, Linear e Notion, oltre alla possibilità di collegare sistemi aziendali attraverso connettori personalizzati. Perplexity propone di verificare l’effettiva persistenza delle conoscenze attraverso test avviati in sessioni nuove, senza riprodurre la cronologia precedente e senza utilizzare previous_response_id, ma mantenendo accessibile il medesimo archivio di memoria. In un esempio dedicato alla distribuzione del software, l’agente deve recuperare un comando di rollback precedentemente corretto, applicarlo soltanto al servizio interessato e adottare una nuova procedura quando questa viene aggiornata, mantenendo il collegamento alla fonte originale.
Per ottenere valutazioni comparabili, Perplexity raccomanda di mantenere invariati il modello, le versioni del Profile e delle Skills e lo stato iniziale della memoria, evitando che un’esecuzione precedente modifichi le condizioni del test successivo. Le prove devono misurare il completamento effettivo delle attività che richiedono informazioni memorizzate, includendo tempi di risposta e costi operativi, anziché limitarsi a verificare la capacità di ricordare singoli dati. In Perplexity Computer, Brain può utilizzare cronologie, file, risultati degli strumenti, artefatti e correzioni dell’utente; una vista dedicata permette di esaminare le informazioni memorizzate, risalire alle fonti e modificarle o eliminarle. Le sessioni in modalità incognito sono escluse dal sistema ed è disponibile un controllo separato per la sua attivazione. Tra gli esempi applicativi presentati figura Rho, un progetto di gestione della fatturazione nel quale Computer ha esaminato durante la notte le modifiche effettuate, individuato incongruenze e pubblicato un riepilogo mattutino su Slack. Secondo i dati comunicati dal progetto, il tempo settimanale dedicato alle riunioni è passato da due ore e mezza a quindici minuti, con un risparmio stimato di 120 ore lavorative nell’arco di dodici settimane. Perplexity precisa però che il beneficio deriva dall’insieme dei connettori, delle esecuzioni notturne e dei riepiloghi automatici, senza che sia stato possibile quantificare separatamente il contributo della memoria persistente.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)