
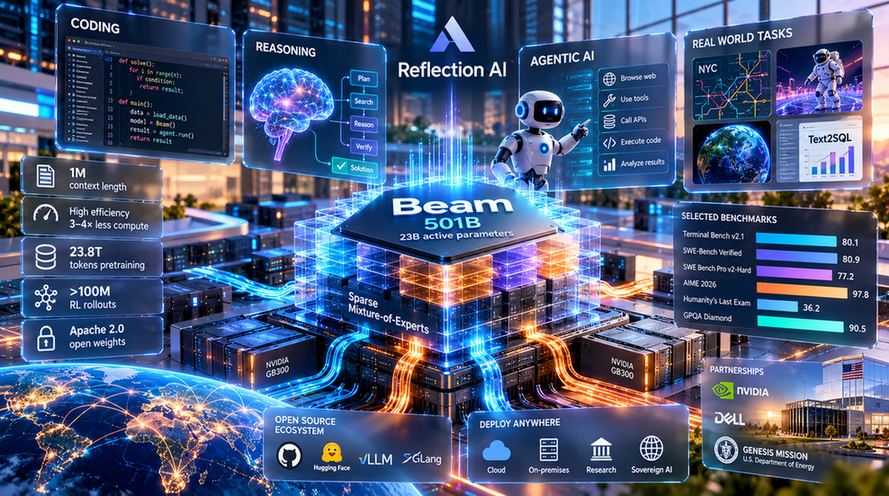
Reflection AI ha reso pubblici i pesi di Beam, il proprio primo modello linguistico open-weight, distribuito attraverso Hugging Face con licenza Apache 2.0 e accompagnato da un insieme di strumenti destinati all’inferenza, alla personalizzazione e allo sviluppo di agenti di intelligenza artificiale. Il rilascio completa il percorso avviato il 5 ottobre, quando l’azienda aveva presentato il modello rendendolo inizialmente accessibile a un gruppo selezionato di sviluppatori attraverso una lista d’attesa. Beam utilizza un’architettura sparse Mixture-of-Experts con 501 miliardi di parametri complessivi, dei quali 23 miliardi attivati durante l’elaborazione di ciascun token, ed è progettato per attività di programmazione, ragionamento avanzato e workflow agentici di lunga durata. Il sistema supporta una finestra contestuale fino a un milione di token e, nella versione attuale, elabora input testuali producendo risposte prevalentemente in inglese. La pubblicazione comprende i pesi del modello, il tokenizer, un’implementazione di riferimento, la model card con i risultati definitivi delle valutazioni e un rapporto tecnico dedicato alla sicurezza, mentre le capacità multilingue e multimodali sono previste per successive versioni della famiglia. La licenza Apache 2.0 permette agli sviluppatori e alle organizzazioni di scaricare, ospitare e modificare il modello, anche per applicazioni commerciali, nel rispetto delle condizioni previste dalla licenza.
La fase di preaddestramento di Beam ha utilizzato 23,8 trilioni di token provenienti da contenuti web selezionati e dataset proprietari concessi in licenza, con una successiva fase di reinforcement learning particolarmente estesa. Reflection ha dichiarato di aver eseguito oltre 100 milioni di rollout durante quattro settimane di addestramento su circa 10.500 GPU NVIDIA GB300, sviluppando procedure destinate a migliorare la capacità del modello di affrontare attività complesse che richiedono numerosi passaggi e l’utilizzo coordinato di strumenti esterni. L’addestramento è stato orientato non soltanto al completamento corretto dei compiti, ma anche alla riduzione delle risorse computazionali necessarie durante l’inferenza. Le procedure di reinforcement learning hanno impiegato sequenze operative di lunga durata per consentire al modello di sperimentare differenti strategie di risoluzione, mentre specifiche penalizzazioni associate alla lunghezza delle risposte hanno incoraggiato l’impiego di un numero inferiore di token. Gli utilizzatori possono inoltre modificare il parametro reasoning effort, scegliendo configurazioni più rapide e sintetiche oppure livelli di ragionamento più approfonditi per le attività che richiedono elaborazioni articolate. L’obiettivo tecnico consiste nel contenere il costo computazionale dei processi agentici, nei quali ogni passaggio di ragionamento, chiamata agli strumenti e verifica del risultato contribuisce al consumo complessivo di token.
I pesi sono disponibili in tre formati numerici, BF16, FP8 e NVFP4, che permettono di utilizzare differenti compromessi tra precisione numerica, occupazione della memoria e prestazioni dell’hardware. Reflection ha inoltre pubblicato un modello drafter basato su DFlash2, destinato alla speculative decoding, una tecnica che permette di proporre anticipatamente sequenze di token e sottoporle alla verifica del modello principale per accelerare la generazione. La preparazione delle configurazioni di inferenza è stata condotta insieme ai partner dell’ecosistema attraverso ottimizzazioni dei kernel, procedure di fusione delle operazioni e configurazioni specifiche per il serving distribuito. Il supporto nativo disponibile dal giorno del rilascio comprende Hugging Face Transformers, vLLM di Inferact, SGLang di RadixArk, Unsloth, Axolotl, TokenSpeed della LightSeek Foundation e NVIDIA Dynamo. Queste integrazioni consentono di utilizzare Beam negli ambienti di inferenza già adottati dagli sviluppatori, riducendo la necessità di realizzare componenti proprietari per il caricamento dei pesi, la gestione delle richieste e l’elaborazione delle risposte. Le configurazioni a precisione ridotta diminuiscono il fabbisogno di memoria rispetto alla distribuzione BF16, ma l’esecuzione completa di un modello con 501 miliardi di parametri richiede comunque infrastrutture hardware adeguate.
La disponibilità del modello viene accompagnata da un ecosistema di oltre 40 partner e integrazioni che Reflection definisce un sistema operativo aperto per gli agenti AI. Il progetto prevede che Beam costituisca il componente linguistico principale, mentre strumenti di esecuzione, ambienti di distribuzione, framework di valutazione, procedure di personalizzazione e integrazioni agentiche vengano resi disponibili attraverso componenti aperti o servizi interoperabili. Tra le piattaforme indicate figurano Amazon Web Services, Baseten, Cloudflare, CoreWeave, Databricks, Fireworks AI, Google Cloud, Microsoft Azure, Modal, Nebius, NVIDIA NIM, Ollama, OpenRouter, Oracle, Together AI, Vercel e Weights & Biases. Sono previste anche integrazioni con LM Studio, Hermes e OpenCode, mentre Dell e HPE supportano configurazioni destinate a infrastrutture aziendali locali, ambienti sovrani e sistemi isolati dalla rete pubblica. La distribuzione attraverso differenti fornitori permette alle organizzazioni di scegliere tra API gestite, endpoint dedicati e installazioni autonome, mantenendo il controllo sui dati e sulle modalità di esecuzione quando il modello viene ospitato all’interno della propria infrastruttura. Reflection ha inoltre aperto la beta pubblica della propria API, accessibile attraverso platform.reflection.ai, con possibilità di iniziare a utilizzare il servizio gratuitamente.
Baseten ha introdotto il supporto a Beam dal primo giorno del rilascio, rendendolo disponibile attraverso Model APIs e Dedicated Inference. La piattaforma descrive il modello come un Transformer autoregressivo esclusivamente testuale, con una finestra contestuale massima di un milione di token e capacità specificamente ottimizzate per programmazione e operazioni agentiche. La documentazione commerciale riporta una tariffazione per milione di token pari a 1,30 dollari per l’input, 4,30 dollari per la categoria cache input e 0,13 dollari per l’output, secondo le condizioni pubblicate dal fornitore. Le valutazioni rese disponibili da Reflection e riprese da Baseten indicano un punteggio del 90,5% su GPQA Diamond, dedicato al ragionamento scientifico avanzato, dell’80,9% su SWE-bench Verified, utilizzato per misurare la risoluzione di problemi software reali, e del 97,8% su AIME 2026, relativo alla matematica competitiva. Nei test agentici vengono riportati l’80,1% su Terminal-Bench 2.1, che valuta l’esecuzione di attività attraverso un ambiente a riga di comando, e il 78,7% su MCP Atlas, dedicato all’utilizzo di strumenti reali attraverso server Model Context Protocol. Questi risultati provengono dalle valutazioni comunicate nell’ambito del rilascio e devono essere considerati in relazione alle specifiche configurazioni sperimentali utilizzate.
Reflection ha pubblicato anche Mirror CLI, un ambiente agentico per terminale sviluppato congiuntamente a Beam e utilizzato durante le attività interne di addestramento e valutazione. Mirror presenta un’architettura composta da un frontend Python, responsabile della gestione dei prompt, delle istruzioni progettuali, delle skills e degli strumenti per gli sviluppatori, e da un nucleo agentico realizzato in Rust, che coordina direttamente le operazioni del modello attraverso una connessione locale. Il sistema supporta conversazioni riprendibili, agenti paralleli eseguiti in worktree separati, istruzioni specifiche del progetto, collegamenti MCP ed estensioni Python. Gli sviluppatori possono visualizzare le operazioni proposte dall’agente, approvare le chiamate agli strumenti e intervenire durante l’esecuzione. Reflection aveva inizialmente costruito Mirror per le attività dei propri ingegneri, introducendo workspace isolati, sessioni operative persistenti e collegamenti con Slack, Linear e GitHub. L’utilizzo interno ha riguardato anche la revisione del codice e l’esecuzione di attività software che richiedevano numerosi passaggi. Il rilascio open source consente ora di utilizzare Mirror con Beam oppure con altri checkpoint ed endpoint compatibili, mentre il modello è stato verificato anche attraverso gli ambienti Pi di Earendil, OpenCode di Anomaly ed Hermes di Nous Research per attività di consultazione dei repository, modifica dei file, esecuzione di comandi e sviluppo software.
La personalizzazione costituisce un altro elemento del rilascio. Reflection ha predisposto integrazioni con NVIDIA NeMo RL, AutoModel e Megatron, RadixArk Miles, Hugging Face TRL, Anyscale SkyRL e Axolotl, destinate a supportare fine-tuning e reinforcement learning su domini e procedure applicative specifiche. L’azienda ha inoltre documentato l’infrastruttura utilizzata nelle proprie attività di reinforcement learning, dichiarando circa 1,3 miliardi di sandbox eseguite complessivamente tra addestramento, valutazioni ed esperimenti di ablazione. Durante il picco operativo dell’ultima fase, la piattaforma ha raggiunto 883.006 CPU virtuali, pari all’83% della capacità allocabile, distribuite tra 23 cluster ospitati su Google Cloud Platform e Amazon Web Services. Reflection intende trasferire parte delle procedure sviluppate internamente nell’ecosistema open source, adottando OpenEnv come standard per gli ambienti di addestramento nelle future esecuzioni. Nei giorni successivi al rilascio è prevista inoltre la pubblicazione di ricette di self-distillation, attraverso le quali gli sviluppatori potranno generare tracce operative relative ai propri compiti, verificare i risultati e utilizzarli per addestrare adapter LoRA. Il procedimento potrà essere ripetuto per migliorare progressivamente la percentuale di completamento delle attività e ridurre i token necessari nei domini applicativi selezionati.
La documentazione tecnica di Beam comprende anche una model card aggiornata e un rapporto dedicato alle valutazioni di sicurezza, pubblicati insieme ai pesi. La diffusione del modello segue le verifiche finali di red-teaming annunciate all’inizio di ottobre e consente alle organizzazioni di esaminare direttamente le caratteristiche del sistema prima dell’integrazione nelle proprie applicazioni. Tra gli utilizzi sperimentali presentati figurano un ambiente tridimensionale sviluppato su CoreWeave, nel quale Beam risolve un escape room attraverso strumenti Python, e la generazione di applicazioni web mediante harness di programmazione. In un confronto dimostrativo condotto attraverso OpenCode, il modello ha completato la realizzazione di un gioco Snake per browser mobile in circa due minuti e venti secondi, rispetto ai quasi cinque minuti del sistema utilizzato come riferimento; un’altra dimostrazione ha riguardato la produzione di un giardino tridimensionale in stile voxel mediante una singola pagina HTML. Si tratta di esempi applicativi e non di benchmark standardizzati, ma mostrano il funzionamento del modello quando viene collegato a strumenti che permettono di leggere file, scrivere codice, eseguire programmi e verificare i risultati. Con il rilascio del 16 ottobre, Beam passa quindi dalla disponibilità limitata tramite API alla distribuzione pubblica dei pesi, degli strumenti di sviluppo e delle integrazioni, permettendo di realizzare installazioni autonome e configurazioni specializzate senza dipendere necessariamente dall’infrastruttura gestita direttamente da Reflection.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)