
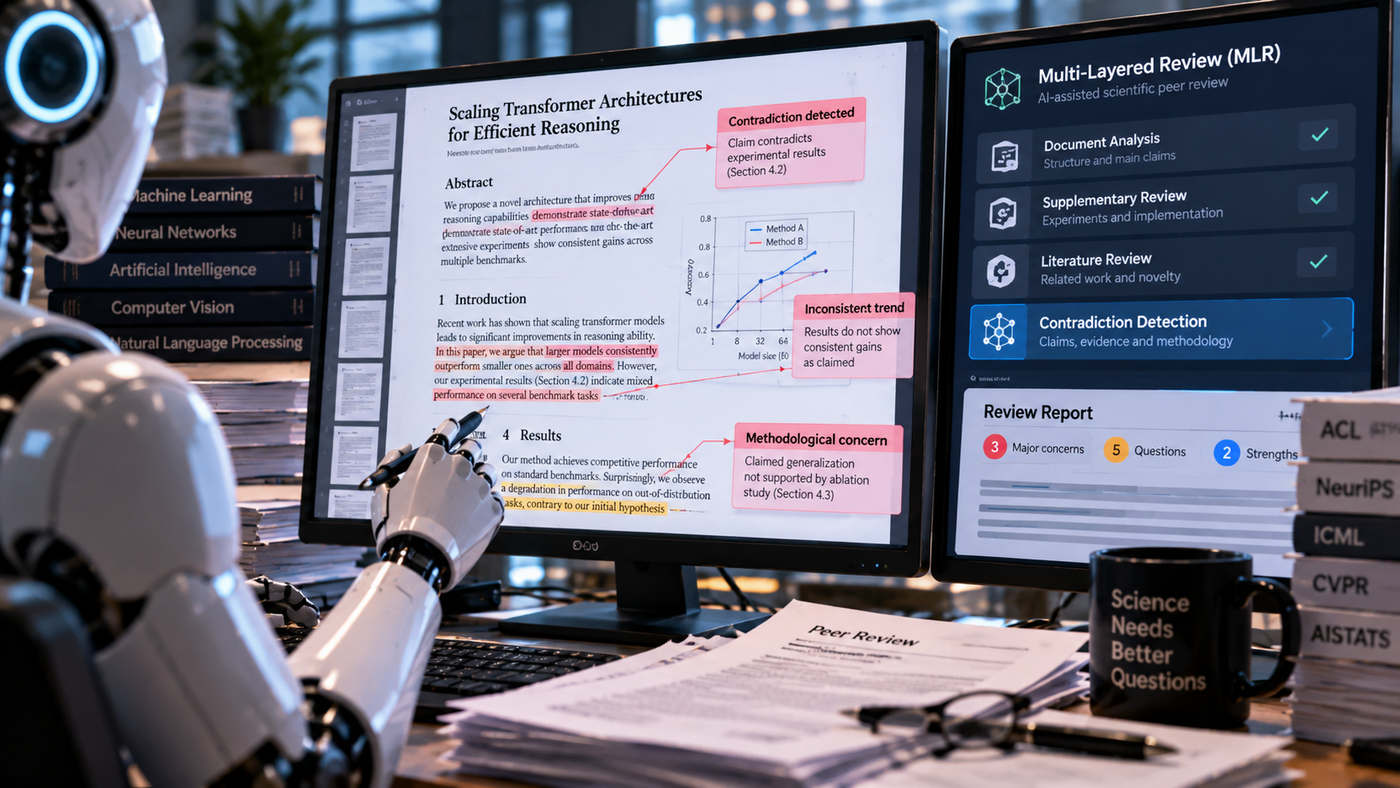
Sakana AI ha sviluppato Multi-Layered Review (MLR), un sistema di revisione scientifica assistita da modelli linguistici progettato per individuare contraddizioni, incongruenze metodologiche e debolezze nelle argomentazioni delle pubblicazioni accademiche. La ricerca introduce un criterio di valutazione differente rispetto ai sistemi che cercano principalmente di riprodurre i giudizi e i punteggi attribuiti dai revisori umani. MLR viene esaminato sulla capacità di riconoscere errori inseriti intenzionalmente nei lavori scientifici e di collegarli alle affermazioni, alle prove sperimentali e alle procedure descritte dagli autori. Nei test sul nuovo Contradiction Benchmark, una configurazione che aggrega quattro revisioni ha individuato il 73,43% delle contraddizioni introdotte nelle affermazioni principali dei lavori. Il risultato riguarda una categoria specifica di errori, quelli direttamente collegati al nucleo delle conclusioni scientifiche, e non rappresenta la percentuale complessiva di errori rilevati in tutte le sezioni dei documenti. Considerando l’intero insieme delle contraddizioni, comprese quelle più periferiche, il tasso di rilevamento riportato dai ricercatori è del 40,95%.
Il Contradiction Benchmark è stato costruito a partire da 257 pubblicazioni scientifiche selezionate fra ACL, AISTATS, CVPR e ICML del 2025 e NeurIPS del 2024. Il gruppo di ricerca ha generato complessivamente 1.164 versioni contenenti contraddizioni artificiali, utilizzando una procedura strutturata anziché modifiche casuali al testo. Per ciascun documento, Gemini 2.5 Pro è stato impiegato nella costruzione di un grafo della conoscenza che rappresenta le relazioni fra affermazioni principali, affermazioni secondarie, evidenze sperimentali, metodologia, dettagli implementativi e contenuti matematici. La distanza di ciascun nodo rispetto alle affermazioni centrali consente di classificare la rilevanza della contraddizione: una modifica che compromette direttamente la conclusione principale viene distinta da un’incongruenza relativa a un dettaglio secondario. GPT-4.1 è stato successivamente utilizzato per generare passaggi contraddittori nelle sezioni selezionate, ricompilando i documenti modificati in formato PDF. La disponibilità delle versioni originali permette di definire in anticipo quali errori il sistema di revisione dovrebbe identificare e di valutare separatamente le diverse categorie.
L’architettura MLR è organizzata intorno a tre ruoli agentici specializzati. L’Appendix Agent utilizza Claude Haiku 3.5 per esaminare il materiale supplementare, sintetizzando i dettagli relativi agli esperimenti, all’implementazione e alle configurazioni tecniche. Il Literature Review Agent, basato su Claude Sonnet 4, consulta la letteratura pertinente per valutare l’originalità delle proposte e individuare eventuali sovrapposizioni con lavori precedenti; questa componente può essere esclusa quando l’accesso a informazioni esterne rischia di compromettere la validità dell’esperimento. Il Review Agent, anch’esso basato su Claude Sonnet 4, esamina il documento principale attraverso tre passaggi successivi. Inizialmente ricostruisce l’organizzazione del lavoro e le idee fondamentali, poi analizza in dettaglio la corrispondenza fra le affermazioni e le prove fornite, infine combina le osservazioni con il materiale supplementare e le informazioni bibliografiche per produrre una revisione contenente punti di forza, criticità, domande e valutazioni. Il sistema utilizza direttamente i PDF, preservando per quanto possibile formule matematiche e figure, mentre l’analisi approfondita del testo principale è limitata a dieci pagine per contenere il carico contestuale e le difficoltà di comprensione dei modelli.
Nelle valutazioni dedicate alle contraddizioni presenti nelle affermazioni principali, una singola esecuzione di MLR ha raggiunto il 60,79% di rilevamento, mentre l’aggregazione di quattro revisioni ha portato il risultato al 73,43%. Nello stesso benchmark, AgentReview, il sistema di confronto più efficace nella specifica categoria delle affermazioni principali, ha registrato il 14,81%. La differenza riguarda pertanto una metodologia di rilevamento mirata alle contraddizioni e non una superiorità generalizzata su tutte le funzioni della peer review. Per gli errori più lontani dalle conclusioni principali le prestazioni di MLR diminuiscono sensibilmente: l’aggregazione di quattro revisioni raggiunge il 47,17% per le contraddizioni a distanza uno nel grafo, il 31,67% a distanza due e valori inferiori per diverse categorie successive. Il sistema mostra quindi una capacità significativamente maggiore di individuare problemi direttamente collegati alle affermazioni centrali rispetto alle incongruenze collocate in porzioni marginali della documentazione. La valutazione automatica è stata eseguita utilizzando il modello o3 come giudice delle revisioni, ripetendo le decisioni dieci volte e calcolandone la media, una metodologia che introduce un’ulteriore componente modellistica nella misurazione dei risultati.
Il gruppo di ricerca ha esaminato anche la natura artificiale degli errori introdotti nel benchmark. Durante una verifica manuale su 50 contraddizioni, il 34% è stato giudicato carente nella coerenza fra frasi adiacenti, mentre l’8% presentava caratteristiche riconoscibili come testo generato artificialmente. Alcune anomalie potrebbero pertanto risultare più semplici da individuare rispetto agli errori autentici che emergono durante una ricerca scientifica, nei quali l’incongruenza può essere nascosta in scelte metodologiche, ipotesi non dichiarate o interpretazioni errate dei risultati. Gli stessi ricercatori segnalano prestazioni inferiori dei sistemi esaminati quando vengono valutati su errori reali anziché sulle contraddizioni sintetiche. Il dato del 73,43% non deve quindi essere interpretato come una probabilità generale di scoprire quasi tre quarti degli errori presenti in un qualsiasi lavoro accademico.
MLR è stato costruito utilizzando modelli commerciali accessibili tramite API, senza necessità di addestrare ulteriormente i pesi delle reti neurali. Il costo operativo stimato dai ricercatori è di circa 0,47 dollari per revisione nella configurazione che esclude la ricerca bibliografica aggiuntiva, valore dipendente dalle tariffe dei modelli e dalla dimensione dei documenti analizzati. Il sistema può produrre osservazioni strutturate per aiutare il revisore a esaminare le ipotesi, la coerenza degli esperimenti e la solidità delle conclusioni, ma i risultati non attestano la capacità di sostituire completamente il controllo scientifico umano. La sperimentazione individua piuttosto un ambito operativo verificabile per l’assistenza automatizzata: utilizzare una sequenza di lettura, confronto e verifica delle evidenze per far emergere possibili contraddizioni che richiedono successivamente un esame critico da parte dei ricercatori e dei revisori responsabili.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)