
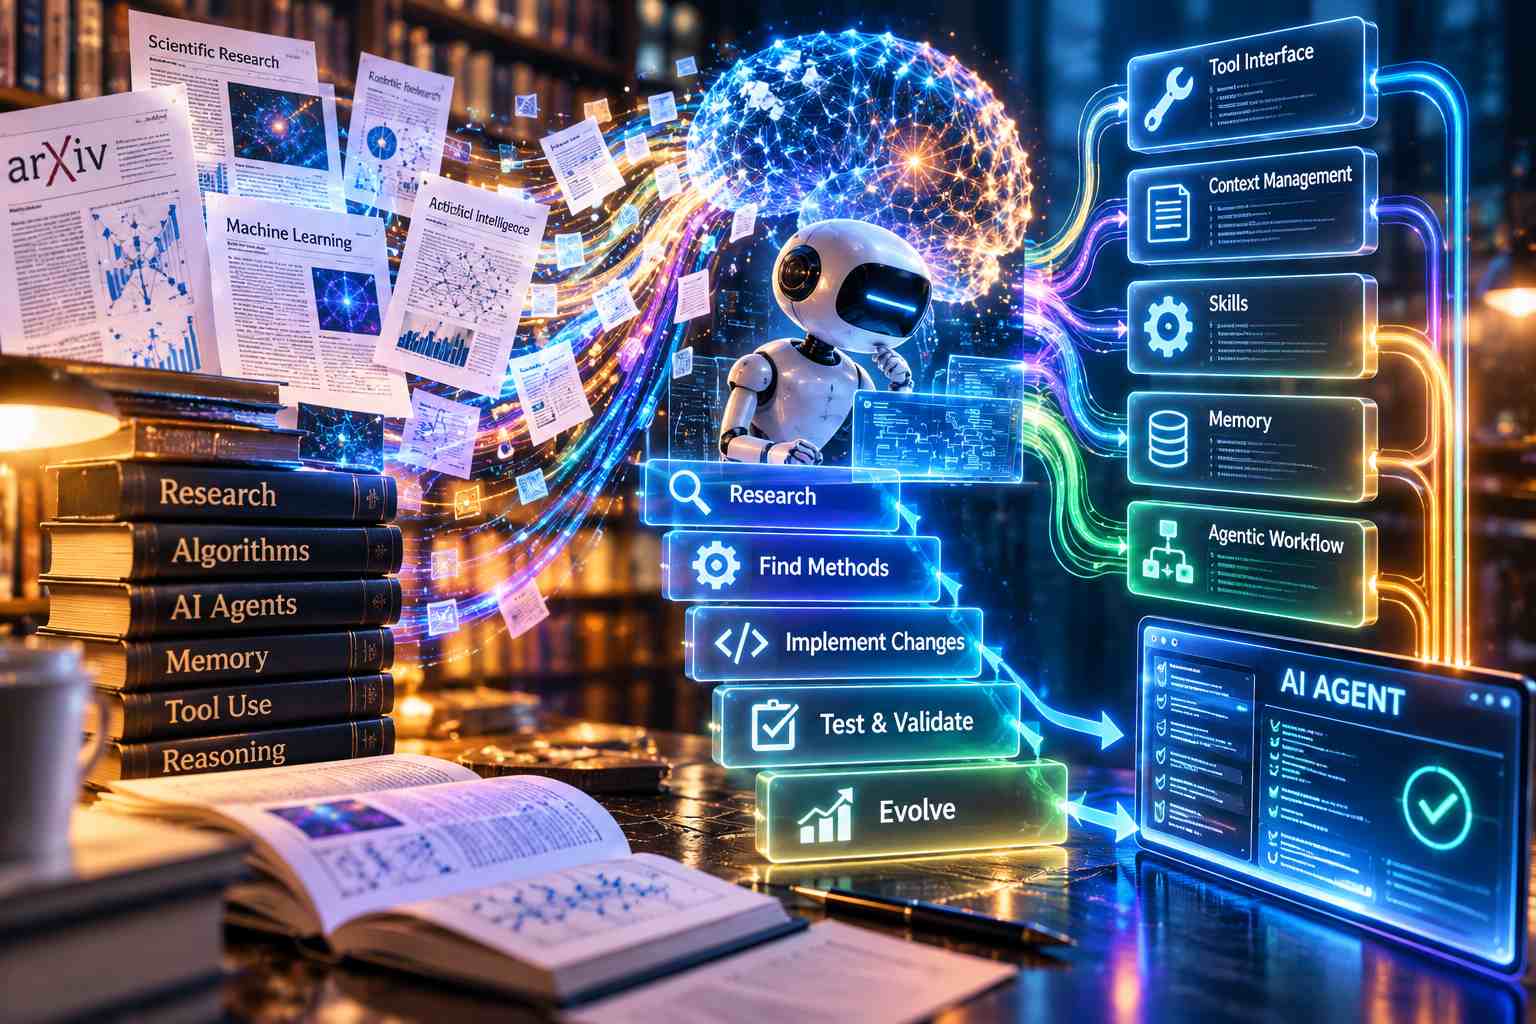
Un gruppo di ricercatori della University of California, Santa Barbara, e di Microsoft ha sviluppato ScholarEvolve, un framework che utilizza la letteratura scientifica per individuare, implementare e verificare miglioramenti nell’infrastruttura operativa degli agenti di intelligenza artificiale. Il sistema interviene sull’harness, ossia sull’insieme dei componenti software che regolano l’utilizzo degli strumenti, la gestione del contesto, la memoria, le competenze e i flussi di lavoro di un agente, mantenendo invariati i pesi del modello linguistico sottostante. Nei test effettuati sul benchmark AppWorld Normal, ScholarEvolve ha portato il tasso di completamento dei compiti del modello open-weight Qwen3.5-27B dal 69,0% all’81,4%, con un miglioramento di 12,4 punti percentuali. Secondo i risultati sperimentali, questo incremento ha permesso di colmare circa il 74% del divario prestazionale rispetto a GPT-5.4 senza eseguire alcun riaddestramento. Il framework affronta un limite delle tecniche di ottimizzazione automatica degli agenti che utilizzano esclusivamente le esperienze pregresse e gli errori registrati durante l’esecuzione: la difficoltà di introdurre soluzioni tecniche non già presenti nelle conoscenze del modello o nelle strategie che il sistema ha esplorato autonomamente.
I metodi precedenti di ottimizzazione dell’harness seguono principalmente due approcci. Alcuni intervengono su componenti specifici, come le librerie di competenze o i sistemi di memoria, analizzando le traiettorie operative degli agenti per individuare comportamenti da correggere. Fra gli esempi figurano WikiSkill di Google, SkillOpt di Microsoft e Memento-Skills. Altri sistemi, come DarwinX di Salesforce, HarnessX di Xiaomi, Self-Harness e Meta-Harness di Stanford, utilizzano un meta-agente di programmazione per esaminare gli errori di esecuzione e riscrivere parti dell’infrastruttura complessiva. Questi procedimenti possono produrre miglioramenti significativi, ma rimangono prevalentemente vincolati alle informazioni già possedute dal modello e ai problemi che si sono effettivamente verificati. La semplice osservazione di un errore non fornisce necessariamente gli elementi necessari per individuare una soluzione nuova. Un meta-agente che rilevi ripetuti problemi nelle chiamate agli strumenti potrebbe, per esempio, introdurre un verificatore supplementare che intercetta le richieste scorrette ma finisce anche per bloccare operazioni legittime, riducendo la capacità dell’agente di completare i compiti.
ScholarEvolve introduce una procedura nella quale gli errori osservati vengono utilizzati per formulare domande di ricerca, anziché rappresentare l’unica fonte da cui derivare le correzioni. Un modello incaricato dell’audit esamina le attività non completate e identifica carenze ricorrenti, come la perdita di informazioni durante conversazioni lunghe, la generazione di chiamate API non valide o l’incapacità di recuperare un’esecuzione dopo un errore di sintassi. Il sistema costruisce quindi interrogazioni destinate alla ricerca di pubblicazioni scientifiche pertinenti, recuperando studi e abstract da arXiv. Per evitare che le ricerche si concentrino ripetutamente su soluzioni simili, ScholarEvolve impiega TopicGPT per raggruppare le pubblicazioni in famiglie di meccanismi tecnici. Il procedimento favorisce l’esplorazione di approcci differenti, fornendo agli agenti di programmazione una selezione diversificata di strategie da tradurre in codice funzionante.
L’architettura dell’harness viene suddivisa in cinque moduli distinti, con interfacce di ingresso e uscita rigorosamente definite. La separazione riguarda l’interfaccia con gli strumenti, la gestione del contesto, le competenze, la memoria e i flussi di lavoro agentici. Per ogni pubblicazione selezionata, un agente di ricerca esamina il testo completo e l’eventuale implementazione ufficiale, producendo un progetto di modifica che specifica il meccanismo da introdurre. Un agente di programmazione realizza quindi l’implementazione Python intervenendo su un solo modulo alla volta e mantenendo invariati gli altri quattro. Prima delle valutazioni complete, il codice viene sottoposto a controlli automatici che verificano la corretta importazione dei moduli, il rispetto delle interfacce, la validità degli artefatti generati e la conformità delle azioni ai formati richiesti. Le modifiche vengono successivamente valutate mediante un insieme di compiti di validazione e quelle con risultati migliori entrano in un procedimento di ricombinazione genetica, attraverso il quale vengono costruite nuove configurazioni dell’harness. Ogni combinazione viene sottoposta a test di regressione congiunti e a verifiche statistiche prima di sostituire la configurazione migliore disponibile.
Fra i miglioramenti introdotti negli esperimenti con Qwen3.5-27B figura una modifica dell’interfaccia degli strumenti basata sulle tecniche descritte in ToolACE-R. Il sistema originale tendeva a produrre sintassi Python non valide o a formulare chiamate API ipotizzando parametri senza verificarne la documentazione. La nuova implementazione introduce un controllo mediante abstract syntax tree, che analizza la struttura delle chiamate prima della loro esecuzione, insieme a un meccanismo capace di espandersi in codice Python per recuperare dinamicamente la documentazione delle API. Un secondo intervento riguarda la gestione del contesto: durante le interazioni prolungate, l’agente poteva superare i limiti disponibili oppure perdere informazioni importanti contenute nei passaggi precedenti. Il modulo sviluppato da ScholarEvolve adotta una strategia di distribuzione del budget contestuale che conserva inalterate le istruzioni di sistema, valuta la rilevanza e la recenza delle informazioni e assegna lo spazio disponibile mantenendo l’ordine cronologico delle osservazioni. Una terza modifica interessa le competenze operative e deriva dalla tecnica Skill-as-Pseudocode, che individua sequenze ricorrenti di chiamate API nelle esecuzioni riuscite e le trasforma in modelli riutilizzabili di pseudocodice tipizzato, evitando che l’agente debba ricostruire ogni volta procedure già sperimentate con successo.
I ricercatori hanno verificato ScholarEvolve su due benchmark interattivi che riproducono aspetti delle attività aziendali. AppWorld richiede agli agenti di utilizzare codice e API per completare operazioni distribuite fra più applicazioni, mentre tau-Bench Telecom simula interazioni di assistenza relative a servizi telefonici, dati mobili e messaggistica. Le configurazioni sono state sviluppate utilizzando Qwen3.5-27B e GPT-5.4-mini e successivamente confrontate con i rispettivi harness iniziali, Meta-Harness e diversi modelli avanzati. Su AppWorld, Qwen3.5-27B ha registrato un aumento di 12,4 punti percentuali nel completamento degli obiettivi dei singoli compiti e di 20,2 punti nel completamento degli scenari, una misura che richiede di riuscire in tre varianti dello stesso caso operativo. Nel benchmark Telecom, GPT-5.4-mini è passato dal 72,7% all’81,9%. I miglioramenti sono stati osservati su tutte le metriche considerate, evidenziando l’effetto delle modifiche infrastrutturali sulle capacità effettivamente disponibili per il modello durante l’esecuzione.
Una verifica specifica ha riguardato la generalizzazione verso applicazioni e API non presenti nei dati utilizzati durante l’ottimizzazione. Nel benchmark AppWorld Challenge, che comprende interazioni con API di Amazon e Gmail sconosciute all’harness durante lo sviluppo, Qwen3.5-27B è passato dal 49,6% al 63,6% di completamento dei compiti, guadagnando 14 punti percentuali e superando Meta-Harness di 9 punti. Gli esperimenti hanno inoltre dimostrato che le prestazioni di un singolo modulo non sono sufficienti per determinare quale combinazione complessiva produca l’agente migliore. In una prova, un modulo di competenze raggiungeva autonomamente il 75,4%, mentre quello basato su Skill-as-Pseudocode si fermava al 73,7%. Quando però i due moduli venivano valutati separatamente all’interno di configurazioni complete comprendenti gli altri componenti evoluti, la soluzione inizialmente meno performante contribuiva a raggiungere l’84,8% di completamento, contro l’80,7% dell’alternativa. Il risultato evidenzia l’importanza delle interazioni fra interfaccia degli strumenti, memoria, gestione del contesto e procedure operative.
Un ulteriore miglioramento riguarda la capacità di recuperare gli errori durante l’esecuzione. Nei compiti AppWorld Challenge caratterizzati da un errore Python intermedio, l’harness evoluto di Qwen3.5-27B è riuscito a completare l’attività nel 59,9% dei casi, rispetto al 44,9% della configurazione iniziale. Il risultato dipende dalla maggiore capacità di utilizzare le informazioni restituite dall’errore per correggere le azioni successive, senza trattare un singolo fallimento operativo come conclusivo per l’intero compito. Poiché ScholarEvolve non modifica i pesi dei modelli, l’adozione delle tecniche non richiede la gestione di checkpoint personalizzati o nuove procedure di addestramento del modello di base. Al momento della presentazione dei risultati, il repository GitHub collegato alla ricerca risultava ancora vuoto, mentre le appendici del lavoro scientifico contenevano estratti del codice dei cinque moduli selezionati. Rimane inoltre un aspetto da considerare nelle implementazioni operative: i controlli automatici documentati verificano compatibilità, correttezza strutturale ed eseguibilità dei moduli, ma non descrivono una specifica procedura di scansione di sicurezza delle pubblicazioni e del codice di terze parti recuperato, con particolare riferimento a dipendenze malevole, istruzioni manipolate e rischi di prompt injection. ScholarEvolve dimostra quindi, attraverso risultati sperimentali misurabili, che la qualità delle procedure software che circondano un modello può incidere in misura significativa sulle prestazioni degli agenti, anche mantenendo completamente invariato il modello linguistico.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)