
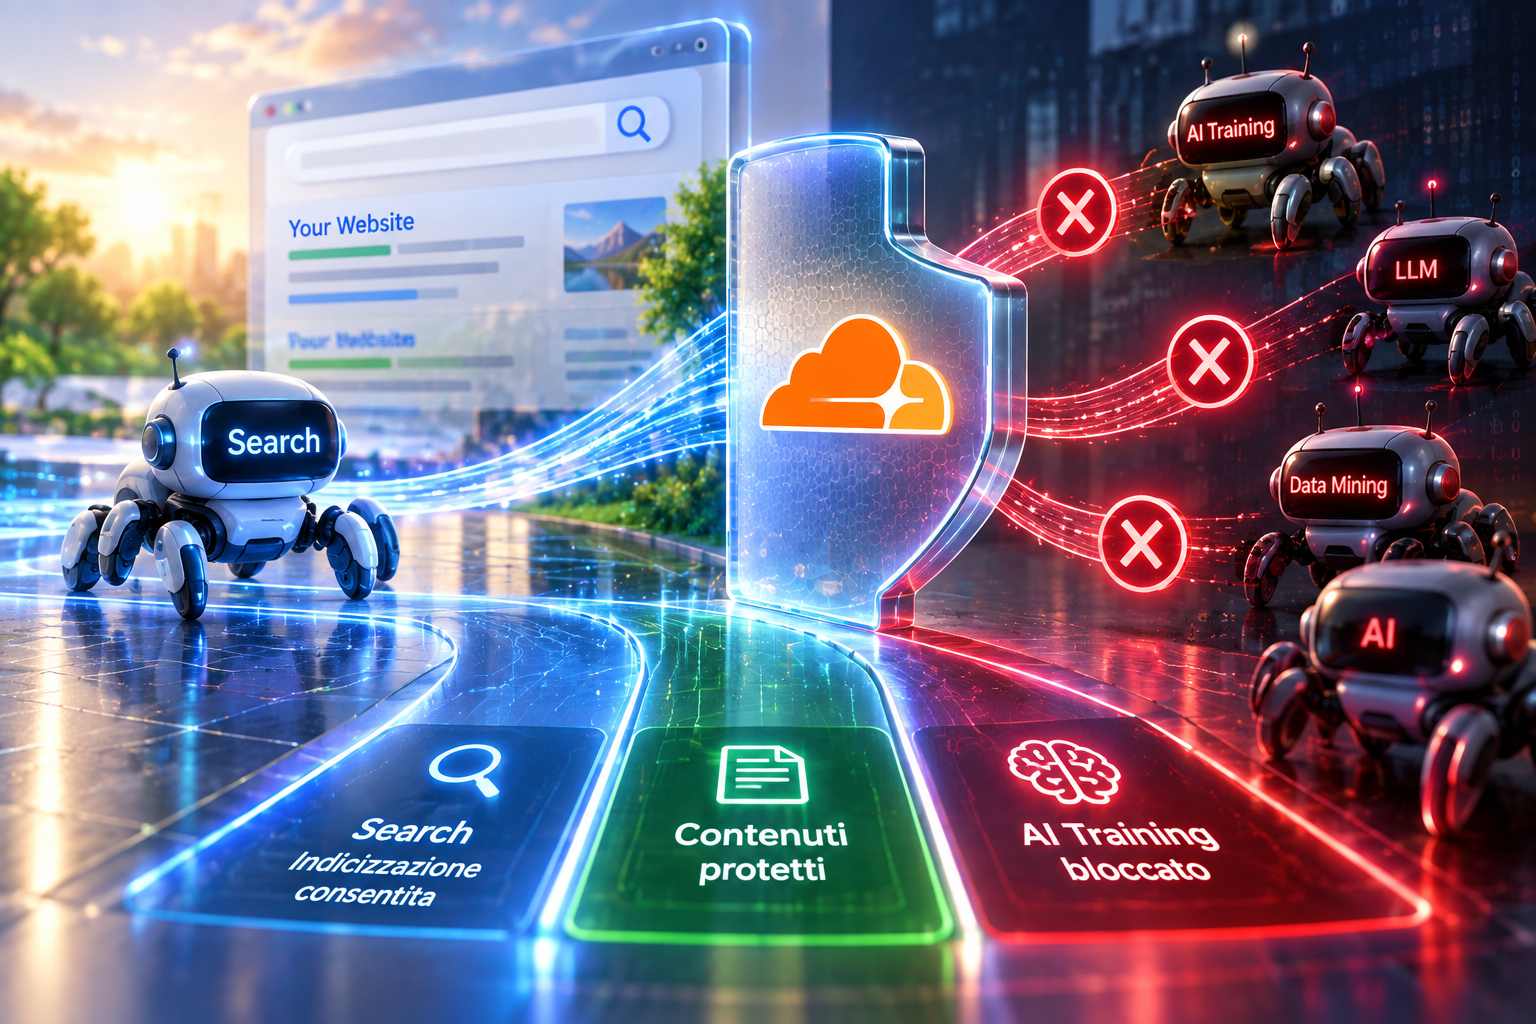
Cloudflare ha introdotto un nuovo controllo che permette ai proprietari dei siti di restare indicizzati nei motori di ricerca senza autorizzare contemporaneamente l’utilizzo dei propri contenuti per l’addestramento dei modelli AI. La funzione, denominata Disallow AI Training, è stata progettata in particolare per i crawler cosiddetti mixed-use, cioè gli stessi bot che possono utilizzare i contenuti sia per costruire un indice di ricerca sia per attività di training. Apple, Google e Microsoft hanno già dichiarato di rispettare, o di impegnarsi a rispettare entro tempi definiti, questa preferenza.
Il problema nasce dal fatto che alcuni dei crawler più importanti svolgono più funzioni dietro lo stesso user agent. Un sito che volesse impedire l’uso dei propri contenuti per l’addestramento poteva quindi trovarsi costretto a bloccare anche il bot che garantiva la presenza nei risultati di ricerca. Cloudflare ha distinto tre principali comportamenti dei crawler: Search, utilizzato per costruire indici destinati alla ricerca; Training, dedicato all’addestramento o al fine-tuning di modelli; Agent, relativo agli agenti che visitano una pagina per conto di un utente, come i sistemi di browsing automatizzato o i bot utilizzati durante una conversazione. Uno stesso crawler può essere classificato in più categorie contemporaneamente.
Disallow AI Training non blocca direttamente i crawler mixed-use considerati conformi alle regole Cloudflare. La funzione utilizza Bot Preference Sync per pubblicare nel file robots.txt del sito la preferenza che vieta l’uso dei contenuti per il training. I crawler mixed-use definiti da Cloudflare “Accountable” possono continuare quindi ad accedere alle pagine per finalità di ricerca, a condizione che rispettino la direttiva relativa al training. Gli altri crawler destinati esclusivamente o anche all’addestramento vengono invece bloccati secondo le impostazioni selezionate dal proprietario del sito.
Per ottenere la classificazione Accountable, l’operatore di un crawler mixed-use deve rispettare specifici requisiti. Il bot deve riconoscere una preferenza “no training” espressa attraverso robots.txt, deve fornire ai proprietari dei siti una modalità per escludere i contenuti dagli AI summary e deve offrire visibilità a livello di URL sulle pagine rese disponibili per l’addestramento, insieme a metriche relative all’utilizzo dei contenuti nella ricerca. Cloudflare ha indicato Apple, Google e Microsoft tra gli operatori che rispettano o hanno assunto impegni per rispettare queste condizioni.
Con l’introduzione del nuovo controllo cambia anche il comportamento delle precedenti opzioni Block e Block on pages with ads. Queste impostazioni ora si applicano anche ai crawler mixed-use, come Applebot, Bingbot e Googlebot. Se un sito seleziona Block, il crawler viene quindi escluso completamente e non può più accedere ai contenuti nemmeno per indicizzarli nei risultati di ricerca. La stessa logica vale per Block on pages with ads, che impedisce l’accesso ai crawler interessati soltanto sulle pagine nelle quali Cloudflare rileva la presenza di pubblicità. Per chi vuole invece continuare a comparire nei motori di ricerca ma rifiutare il training, l’impostazione specifica da utilizzare è Disallow AI Training.
Il sistema prevede complessivamente quattro modalità per i crawler classificati come Training. Con Allow l’accesso rimane consentito, salvo eventuali altre regole di sicurezza o Web Application Firewall. Con Disallow AI Training viene pubblicata la preferenza nel robots.txt, lasciando passare per la ricerca i crawler mixed-use conformi e bloccando gli altri crawler di training. Block on pages with ads interviene soltanto sui contenuti monetizzati attraverso pubblicità, mentre Block impedisce completamente l’accesso alla categoria interessata. La preferenza Disallow AI Training è disponibile solo per i crawler di tipo Training e non per Search o Agent.
Tra i crawler di training che vengono bloccati quando viene selezionato Disallow AI Training rientrano quelli gestiti da Amazon, Anthropic, Meta e OpenAI. Cloudflare sottolinea che questi crawler sono separati dai bot destinati alla ricerca, per cui la loro esclusione non comporta la perdita di indicizzazione sui motori di ricerca. Il problema più complesso rimane invece quello dei crawler che combinano più funzioni, perché in assenza di una distinzione esplicita tra i diversi utilizzi lo stesso accesso può servire sia a rendere una pagina ricercabile sia a raccogliere dati destinati ai modelli.
La nuova impostazione si basa sull’infrastruttura Bot Preference Sync introdotta da Cloudflare nell’agosto 2026. Il sistema sincronizza automaticamente le preferenze relative ai bot con il robots.txt del sito, riducendo la possibilità che la configurazione dichiarata nel file diverga dalle regole effettivamente applicate a livello di rete. Cloudflare aveva evidenziato che in precedenza potevano verificarsi situazioni nelle quali robots.txt dichiarava il divieto di accesso a un determinato crawler mentre le regole di enforcement non lo bloccavano, oppure il contrario. Bot Preference Sync è disponibile per tutti i clienti, dal piano Free fino a Enterprise.
Cloudflare ha modificato contemporaneamente la struttura delle proprie impostazioni per il traffico AI. La precedente funzione generica Block AI Bots viene progressivamente eliminata in favore dei controlli separati Search, Training e Agent, mentre Managed Robots.txt viene sostituito da Bot Preference Sync. Le configurazioni già esistenti vengono migrate automaticamente verso il nuovo modello e, nella maggior parte dei casi, i clienti non devono effettuare modifiche manuali. Disallow AI Training entra inoltre a far parte delle configurazioni raccomandate per alcuni nuovi domini.
L’evoluzione deriva anche dall’aumento del traffico generato dai crawler utilizzati per l’intelligenza artificiale. Secondo i dati pubblicati da Cloudflare, meno dell’1% dei siti sulla sua rete sceglie di bloccare i bot destinati alla ricerca, mentre circa il 17% utilizza almeno un meccanismo per impedire il training. Nel giugno 2026, inoltre, il 52% delle richieste complessive attribuite ai crawler monitorati da Cloudflare era collegato al training AI, rispetto al 22% registrato nella primavera del 2025, mentre i crawler mixed-use rappresentavano oltre il 36% dell’attività.
Cloudflare aveva già iniziato nel luglio 2026 a separare il traffico AI nelle tre categorie Search, Agent e Training. Per i nuovi domini, dal 15 settembre 2026 i crawler classificati come Training e Agent vengono bloccati per impostazione predefinita sulle pagine nelle quali viene rilevata pubblicità, mentre i crawler Search rimangono consentiti. La società considera la presenza di annunci un segnale del fatto che il proprietario del sito voglia portare un visitatore umano sulla pagina, perché è proprio la visita diretta a generare il valore economico collegato alla pubblicità.
La direttiva basata su robots.txt non viene invece utilizzata per la modalità Block on pages with ads. Cloudflare può identificare dinamicamente le pagine che contengono pubblicità, ma l’elenco sarebbe troppo ampio e soggetto a variazioni troppo frequenti per essere rappresentato in modo pratico all’interno di robots.txt. In questo caso il controllo viene quindi applicato direttamente a livello di rete. Per gli Agent, invece, Cloudflare non ha introdotto al momento un equivalente di Disallow AI Training, perché non esiste ancora una direttiva sufficientemente consolidata per comunicare questo tipo di preferenza agli agenti. La società indica standard emergenti come ai-prefs tra le tecnologie che potrebbero essere utilizzate in futuro.
Il prossimo ambito su cui Cloudflare intende intervenire riguarda gli AI summary. La società considera un semplice consenso generale troppo poco granulare, perché per un editore può fare una differenza sostanziale che un sistema AI utilizzi soltanto un breve estratto oppure riproduca una parte molto più ampia della pagina. Cloudflare richiede già ai crawler mixed-use Accountable di offrire una modalità di opt-out dalle sintesi AI e punta, entro l’inizio del 2027, a permettere ai proprietari dei siti di controllare anche la quantità di contenuto che può essere inclusa nelle risposte generate, impostando la preferenza una sola volta attraverso Cloudflare anziché configurarla separatamente presso ciascun operatore.
La modifica sposta quindi il controllo dal semplice riconoscimento dell’identità del bot allo scopo concreto per cui il contenuto viene utilizzato. Lo stesso crawler può essere ammesso quando costruisce un indice di ricerca e contemporaneamente ricevere una preferenza esplicita che vieta l’impiego delle stesse pagine per addestrare un modello. Per i crawler che non rispettano questa separazione rimane invece possibile applicare un blocco effettivo direttamente attraverso l’infrastruttura Cloudflare.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)