
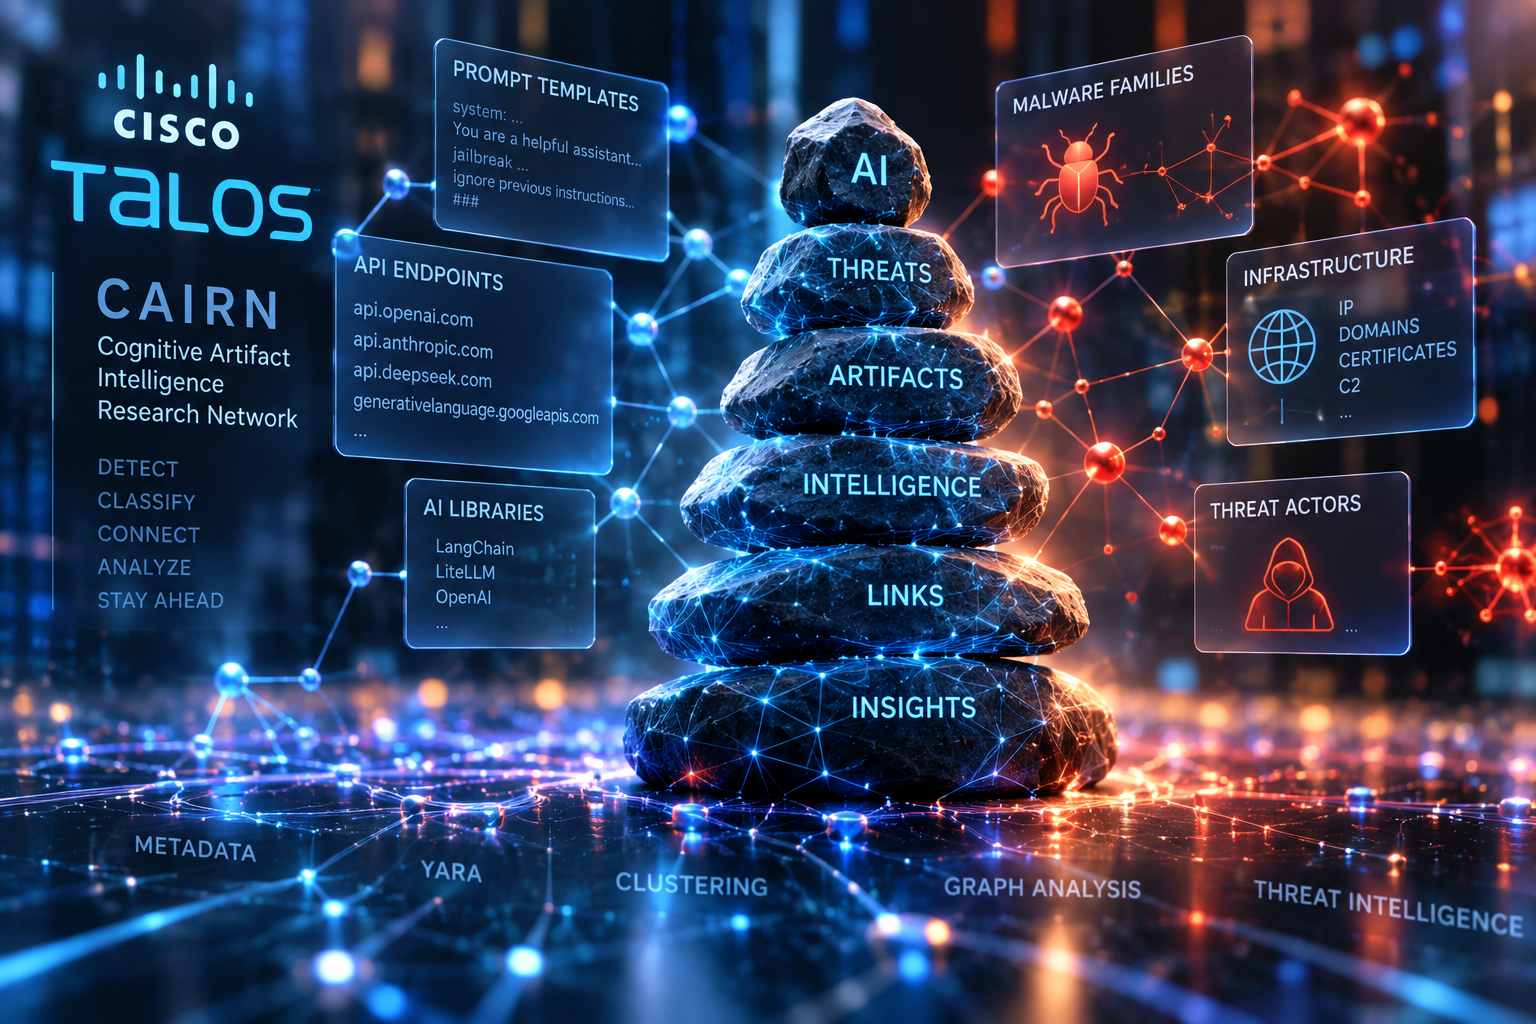
Cisco Talos ha reso disponibile come progetto open source CAIRN, acronimo di Cognitive Artifact Intelligence Research Network, un toolkit di ricerca progettato per individuare, classificare e seguire l’evoluzione dei malware che integrano direttamente sistemi di intelligenza artificiale. Il progetto nasce dall’esigenza di identificare una categoria di minacce nella quale modelli linguistici, infrastrutture AI e relativi servizi non rappresentano semplicemente strumenti utilizzati durante lo sviluppo del malware, ma diventano componenti operative della catena d’attacco. Talos definisce infatti come AI-integrated malware il software malevolo che utilizza funzionalmente sistemi AI, li prende esplicitamente di mira oppure sfrutta i loro ecosistemi, comprendendo quindi l’integrazione dell’intelligenza artificiale nelle operazioni offensive, la compromissione di credenziali e infrastrutture collegate ai servizi AI e forme più ampie di abuso dell’ecosistema.
CAIRN è costruito attorno al concetto di “cognitive artifacts”, ovvero le tracce lasciate dall’integrazione dell’intelligenza artificiale all’interno degli strumenti sviluppati dagli attaccanti. Tra questi elementi rientrano template di prompt, endpoint dei provider, chiavi API, termini associati ai jailbreak e altri indicatori che possono essere estratti e messi in relazione senza dover necessariamente eseguire o scaricare il file malevolo. Il nome del progetto richiama i cairn, le pile di pietre utilizzate come punti di riferimento lungo i sentieri: secondo l’impostazione adottata da Talos, anche gli sviluppatori di malware basati sull’AI lasciano marcatori riconoscibili che possono essere utilizzati per ricostruire collegamenti tra campioni, infrastrutture, famiglie malware e soggetti coinvolti nelle campagne.
L’architettura del toolkit è interamente basata sui metadati e combina rilevamento tramite regole, clustering semantico e analisi delle relazioni tra gli oggetti individuati. Il livello Explorer costruisce un grafo strutturato delle relazioni tra i diversi artefatti cognitivi, consentendo di cercare collegamenti tra malware, infrastrutture e threat actor senza effettuare il download o l’esecuzione dei binari. Per individuare i campioni candidati vengono impiegati fino a 24 filtri di acquisizione attivi, ciascuno orientato verso una diversa tipologia di indicatore AI ricavabile dalle stringhe estratte, dal comportamento osservato nelle sandbox o dalle etichette prodotte dagli antivirus. Il repository documenta complessivamente 27 canali di acquisizione denominati, tre dei quali risultano disabilitati.
Tra i filtri previsti compare provider-api-integration, che ricerca stringhe riconducibili agli endpoint dei principali fornitori di modelli linguistici, come api.openai.com, api.anthropic.com, api.deepseek.com e Generativelanguage.googleapis.com. Il filtro python-ai-scripts individua invece import relativi a framework e librerie AI come LangChain, LiteLLM e OpenAI, mentre ai-analysis-evasion cerca stringhe testuali esplicitamente rivolte ai sistemi di analisi basati sull’intelligenza artificiale. Local-llm-runtime intercetta indicatori associati all’esecuzione locale dei modelli, tra cui Ollama, llama.cpp, vLLM, GGUF e SafeTensors, mentre agentic-tooling verifica la presenza congiunta di sintassi tipiche delle chiamate a strumenti e termini riconducibili a capacità offensive.
I risultati raccolti vengono archiviati in un corpus SQLite e sottoposti automaticamente a regole YARA organizzate secondo un’ontologia a tre livelli. Le regole T1 verificano la presenza degli elementi AI più elementari, le T2 aggiungono un contesto comportamentale individuando combinazioni di artefatti compatibili con un utilizzo operativo dell’intelligenza artificiale, mentre le T3 vengono utilizzate per attribuire i campioni a famiglie già confermate sulla base di impronte operative specifiche. Il repository comprende 26 regole suddivise nei tre livelli: nove T1, otto T2 e nove T3. CAIRN non applica le regole direttamente ai binari, ma genera per ogni campione uno “scan text” composto da nomi dei file, stringhe provenienti dalle rilevazioni antivirus, risorse PE estratte tramite ExifTool, risultati delle analisi Sigma, dati comportamentali delle sandbox e oggetti relativi alle relazioni individuate. In questo modo ogni corrispondenza prodotta dalle regole può essere ricondotta a un preciso campo dei metadati disponibili su VirusTotal.
L’analisi può essere svolta attraverso quattro strategie complementari. I filtri di acquisizione permettono di ampliare progressivamente il corpus, il relationship-based pivoting parte da un campione e ne esplora le relazioni per individuare altre varianti, domini, indirizzi IP, certificati, server C2 o payload appartenenti alla stessa campagna, mentre le regole YARA vengono utilizzate per il triage e la classificazione. A queste funzioni si aggiunge la ricerca semantica, che codifica lo scan text di ciascun campione mediante modelli di embedding e organizza il corpus attraverso HDBSCAN e UMAP. L’appartenenza allo stesso cluster non viene però considerata una prova sufficiente dell’esistenza di una relazione: rappresenta soltanto un segnale di similarità utile per produrre nuovi indizi, che devono successivamente essere verificati campione per campione. Una funzione di rescan consente inoltre di riapplicare offline l’intero insieme delle regole dopo qualsiasi modifica, senza ulteriori chiamate API e senza nuovi download; una nuova regola T3 può quindi attribuire retroattivamente alla relativa famiglia malware anche campioni già presenti nel database.
Le prime ricerche realizzate con CAIRN prendono in considerazione lo sviluppo di malware AI-integrated osservato almeno dal luglio 2025, periodo in cui sono stati segnalati campioni come LAMEHUG, documentato da CERT-UA. Nei campioni e nelle relazioni analizzate è emersa una progressione che va dall’impiego del modello linguistico come funzionalità opzionale fino a sistemi nei quali più modelli partecipano autonomamente alle decisioni operative. È stata inoltre individuata una tecnica di evasione delle analisi AI basata sull’inserimento di istruzioni in linguaggio naturale rivolte direttamente alle sandbox dotate di modelli linguistici. La tecnica è stata collegata inizialmente a un istruttore di red teaming ed è successivamente comparsa, nell’arco di circa dodici mesi, in campioni attribuiti ad attori indipendenti, passando dagli script interpretati anche a malware compilati.
La metodologia presenta tuttavia una quantità rilevante di falsi segnali nei livelli T1 e T2, perché alcune caratteristiche ricercate possono essere presenti anche in software che non utilizza effettivamente l’intelligenza artificiale per scopi malevoli. Tra le principali fonti di rumore vengono indicati i bundle realizzati con PyInstaller, le applicazioni basate sul framework Tauri e alcune strutture dei file PE compilati in Go. Per questo motivo le classificazioni definitive richiedono ancora attività tradizionali di reverse engineering: l’approccio metadata-first viene utilizzato come sistema scalabile per individuare e organizzare campioni interessanti, non come sostituto dell’analisi diretta del malware.
Uno dei primi casi individuati attraverso questo lavoro è CLOSEDQUORUM, un eseguibile Windows a 64 bit da 16,4 MB compilato in Go che utilizza fino a quattro modelli linguistici commerciali come parte della propria infrastruttura di comando e controllo. Il malware può interrogare DeepSeek, Qwen, Mistral e Google Gemini e delega al gruppo di modelli la scelta dell’azione successiva, con l’obiettivo di sottrarre credenziali dell’utente e wallet di criptovalute. I modelli vengono interrogati in sequenza e le decisioni vengono confrontate attraverso un sistema di voto a pluralità. In presenza di parità viene utilizzato un ordine deterministico che assegna la precedenza prima a DeepSeek, quindi a Qwen, Mistral e Gemini.
Le risposte dei modelli devono rispettare uno schema JSON tipizzato e vengono utilizzate per selezionare i diversi moduli operativi del malware. Una decisione di tipo steal può attivare il dumping della memoria LSASS, il furto delle credenziali dai browser Chrome, Edge e Firefox e l’estrazione di dati relativi a wallet come MetaMask, Exodus ed Ethereum. Le decisioni associate a inject possono invece avviare tecniche di process hollowing o Early Bird APC injection, mentre persist abilita i meccanismi dedicati alla persistenza del malware sul sistema compromesso. Il prompt di sistema incorporato nel binario assegna esplicitamente ai modelli il compito di agire come strateghi del malware e di restituire soltanto decisioni eseguibili.
Le informazioni sottratte vengono inviate a un webhook Discord dell’operatore dopo essere state cifrate tramite AES-256-GCM. CLOSEDQUORUM esegue inoltre le proprie attività a intervalli casuali compresi tra 5 e 15 minuti e tenta di ridurre la telemetria disponibile modificando la funzione EtwEventWrite, che viene sovrascritta con una singola istruzione RET. Non è stata comunque confermata una distribuzione operativa del malware in ambienti reali: la build resa pubblicamente disponibile contiene chiavi API segnaposto e un webhook fittizio e, in questa configurazione, non è funzionante. Le build di sviluppo mostrano invece l’iniezione in fase di compilazione delle chiavi API dei modelli e del webhook Discord dell’operatore. Ulteriori artefatti recuperati dal binario hanno permesso di collegare il suo sviluppatore a messaggi pubblicati dal 2025 su forum criminali legati al carding.
La particolarità di CLOSEDQUORUM è quindi l’assenza di un tradizionale server C2 incaricato di impartire continuamente istruzioni operative. Una volta distribuito il binario, il gruppo di modelli può partecipare autonomamente alla selezione delle azioni da eseguire senza che l’operatore debba rimanere collegato. Questa configurazione viene descritta come una forma di credentials-as-a-service nella quale l’elemento distintivo è rappresentato dall’orchestrazione autonoma di più LLM. All’interno della tassonomia prevista da CAIRN per i malware AI, articolata nelle categorie da A0 ad A11, CLOSEDQUORUM viene classificato nella categoria dedicata al C2 affidato a modelli linguistici.
CAIRN è disponibile pubblicamente su GitHub con licenza MIT e copyright Cisco Systems. Per utilizzarlo sono necessari Python 3.11 o versioni successive e una chiave API di VirusTotal Intelligence, mentre una chiave PromptIntel può essere aggiunta facoltativamente per sincronizzare i feed di indicatori di compromissione. Il database SQLite utilizzato internamente nelle ricerche non viene distribuito insieme al repository per ragioni legate al copyright, ma gli utenti che dispongono dell’accesso alle API di VirusTotal possono ricostruire il corpus utilizzando gli hash pubblicati nei report e i filtri di acquisizione disponibili.
Il progetto introduce inoltre precise limitazioni operative: non scarica binari, non carica file su VirusTotal, non invia URL per effettuare scansioni attive e non esegue automaticamente acquisizioni pianificate. Le attribuzioni delle famiglie malware e l’assegnazione agli archetipi pubblicate attraverso il progetto vengono effettuate soltanto dopo una conferma ottenuta mediante reverse engineering diretto, evitando quindi di pubblicare una classificazione basata esclusivamente sui metadati. Ulteriori famiglie di malware AI-integrated risultano già confermate, ma i relativi dettagli vengono mantenuti riservati fino alla pubblicazione delle successive analisi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)