
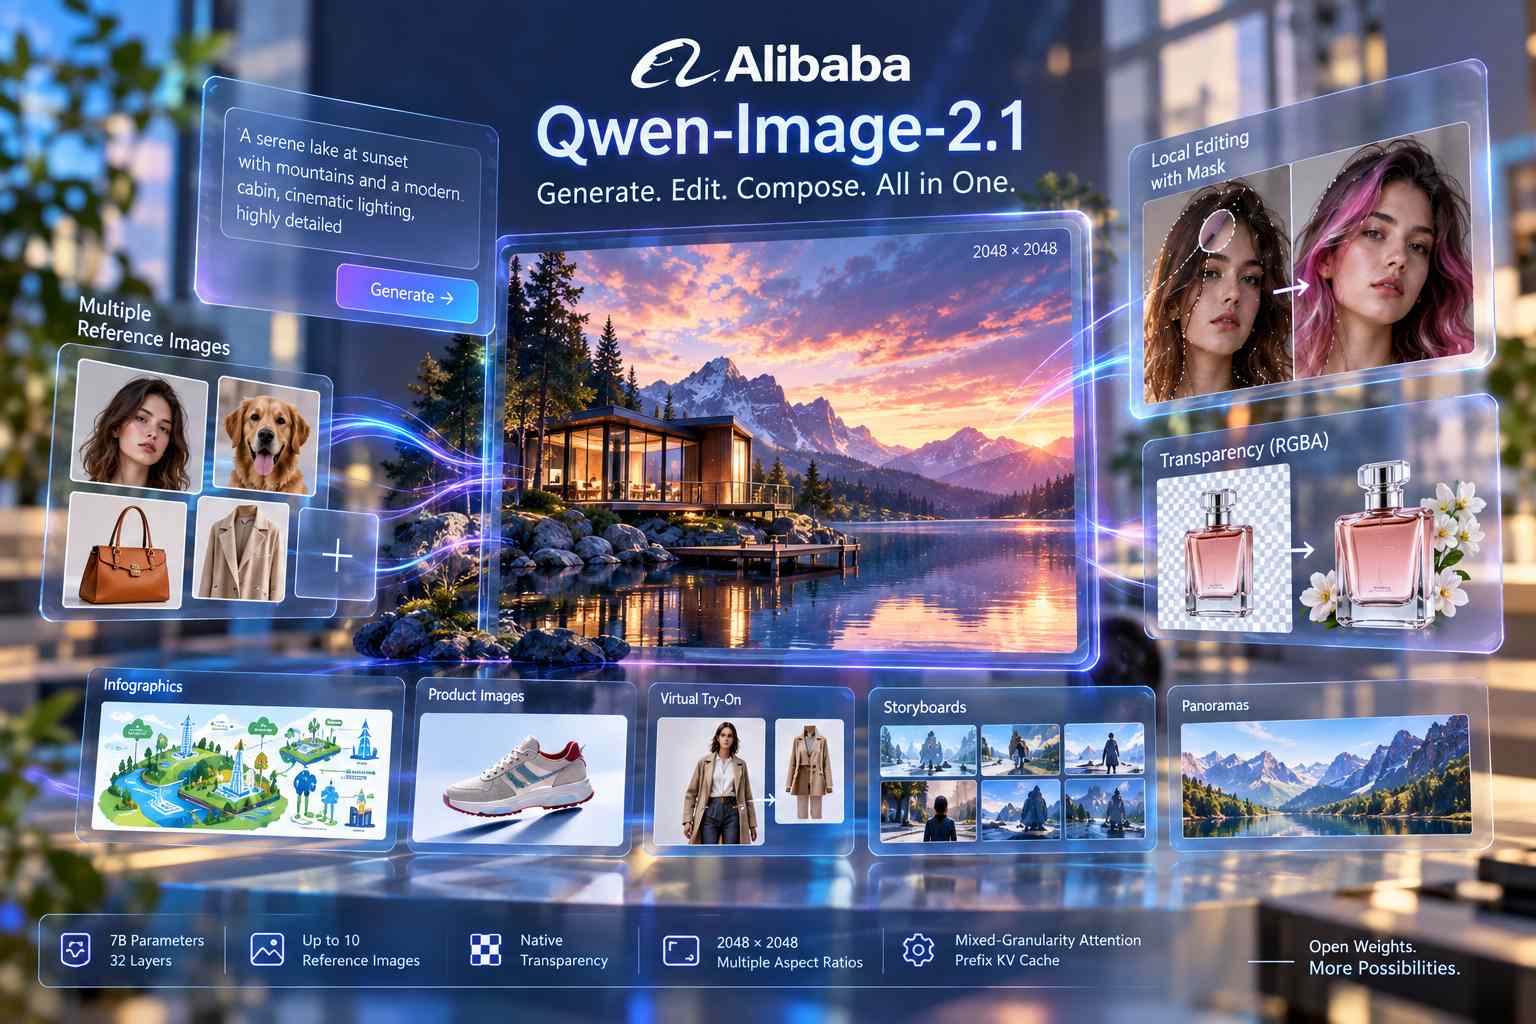
Alibaba ha presentato Qwen-Image-2.1, un modello a pesi aperti progettato per riunire generazione e modifica delle immagini all’interno della stessa architettura multimodale. La componente dedicata alla generazione visiva utilizza 7 miliardi di parametri distribuiti su 32 layer Single-Stream DiT, con una struttura relativamente compatta rispetto a numerosi modelli concorrenti e pensata per combinare qualità dell’output ed efficienza di inferenza. Qwen-Image-2.1 può generare immagini direttamente da istruzioni testuali e intervenire su immagini esistenti senza passare attraverso modelli separati, supportando inoltre fino a 10 immagini di riferimento contemporaneamente. Questi input possono essere utilizzati per combinare in una stessa composizione persone, prodotti, capi di abbigliamento e altri elementi mantenendone per quanto possibile identità e caratteristiche visive. Le modifiche possono inoltre essere localizzate attraverso maschere, annotazioni disegnate o indicatori circolari, consentendo per esempio di cambiare soltanto l’acconciatura, l’abbigliamento o una determinata area della scena senza dover rigenerare intenzionalmente l’intera immagine.
Una delle funzioni integrate riguarda la gestione nativa della trasparenza. Qwen-Image-2.1 può generare direttamente immagini RGBA dotate di canale alfa, creare contenuti su sfondo trasparente oppure modificare elementi che dispongono già di trasparenza, evitando quindi il tradizionale passaggio aggiuntivo di rimozione dello sfondo attraverso un modello o un software separato. La stessa architettura permette di estrarre un soggetto da una fotografia e trasformarlo in un elemento isolato su livello trasparente, rendendolo immediatamente utilizzabile in composizioni successive. Questa capacità viene affiancata da funzioni dedicate alla produzione di infografiche, panorami, storyboard, immagini di prodotto e simulazioni di virtual try-on, mentre Alibaba dichiara miglioramenti anche nella resa tipografica, nel posizionamento del testo all’interno delle immagini, nell’illuminazione dei ritratti e nella rappresentazione dei dettagli più fini. Il modello supporta nativamente immagini fino a 2048×2048 pixel e diversi rapporti d’aspetto, mantenendo quindi la generazione 2K come uno degli elementi centrali del flusso di lavoro.
Sul piano dell’efficienza, Qwen-Image-2.1 utilizza un meccanismo di mixed-granularity attention, o attenzione a granularità mista, nel quale le diverse componenti dell’input vengono trattate con granularità differenti. Il testo, comprendente il prefisso di sistema e le istruzioni di editing, utilizza una maschera causale a livello di token, mentre la parte relativa alle immagini opera con maschere a livello di blocchi. A questo sistema viene associato il riutilizzo della prefix KV cache: immagini di riferimento e istruzioni di modifica vengono elaborate e memorizzate nella fase iniziale, permettendo di riutilizzarne le rappresentazioni durante i successivi passaggi di generazione invece di calcolarle nuovamente a ogni iterazione. L’obiettivo è ridurre sia il carico computazionale sia l’occupazione di memoria, con benefici particolarmente rilevanti quando vengono utilizzate contemporaneamente più immagini di riferimento. La struttura consente quindi di aumentare il numero degli input visivi senza far crescere proporzionalmente il costo di elaborazione durante tutte le fasi del processo generativo.
Nel benchmark interno Qwen-Image-Bench, Qwen-Image-2.1 ha ottenuto un punteggio complessivo di 60,28, collocandosi al vertice tra i modelli a pesi aperti presenti nella valutazione e superando diversi sistemi proprietari inclusi nel confronto. Il dato deve comunque essere interpretato considerando che Qwen-Image-Bench è una suite sviluppata dallo stesso team Qwen e non costituisce quindi una valutazione indipendente; nel medesimo confronto sono inoltre presenti modelli proprietari che raggiungono risultati superiori. Le osservazioni critiche rivolte al rilascio riguardano anche il fatto che diverse funzioni presentate come parte dell’architettura unificata, tra cui editing locale, utilizzo di riferimenti multipli ed estrazione dei soggetti, sono già disponibili in altri sistemi di generazione delle immagini. L’elemento distintivo risiede quindi soprattutto nella concentrazione di queste capacità in un modello relativamente compatto, a pesi accessibili e integrabile direttamente in differenti stack software, più che nell’introduzione ex novo di ciascuna singola funzione.
Un ulteriore elemento riguarda la qualità degli output e il regime di distribuzione. Tra le criticità segnalate nei test esterni rientrano ancora possibili deformazioni nei dettagli anatomici e alterazioni cromatiche, problemi ricondotti anche all’impiego consistente di dati sintetici nel processo di addestramento. La differenza più rilevante rispetto alla generazione precedente è però rappresentata dalla licenza: Qwen-Image-2.1 viene distribuito attraverso la Qwen Research License Agreement, che consente utilizzo, modifica e ridistribuzione per finalità non commerciali, mentre qualsiasi impiego commerciale richiede una licenza separata rilasciata da Alibaba. Il precedente Qwen-Image era invece pubblicato sotto licenza Apache 2.0, quindi con condizioni sensibilmente più permissive per l’impiego commerciale.
Qwen-Image-2.1 è disponibile attraverso Hugging Face e ModelScope ed è già supportato da diversi strumenti e framework per l’esecuzione locale e server-side. Diffusers integra il modello attraverso QwenImage21Pipeline, ComfyUI dispone del supporto nativo e di workflow dedicati alla generazione e all’editing, mentre vLLM-Omni introduce funzionalità come prefix KV caching, CUDA Graph, quantizzazione FP8 e differenti forme di parallelismo. Anche SGLang offre supporto nativo con sistemi di caching, CUDA Graph e distribuzione dei componenti, mentre ulteriori soluzioni come LightX2V permettono di accelerarne l’inferenza. La disponibilità dei pesi consente quindi di eseguire e integrare Qwen-Image-2.1 in differenti ambienti hardware e software, fermo restando che l’utilizzo commerciale del modello e dei relativi materiali rimane subordinato all’ottenimento di una licenza specifica.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)