
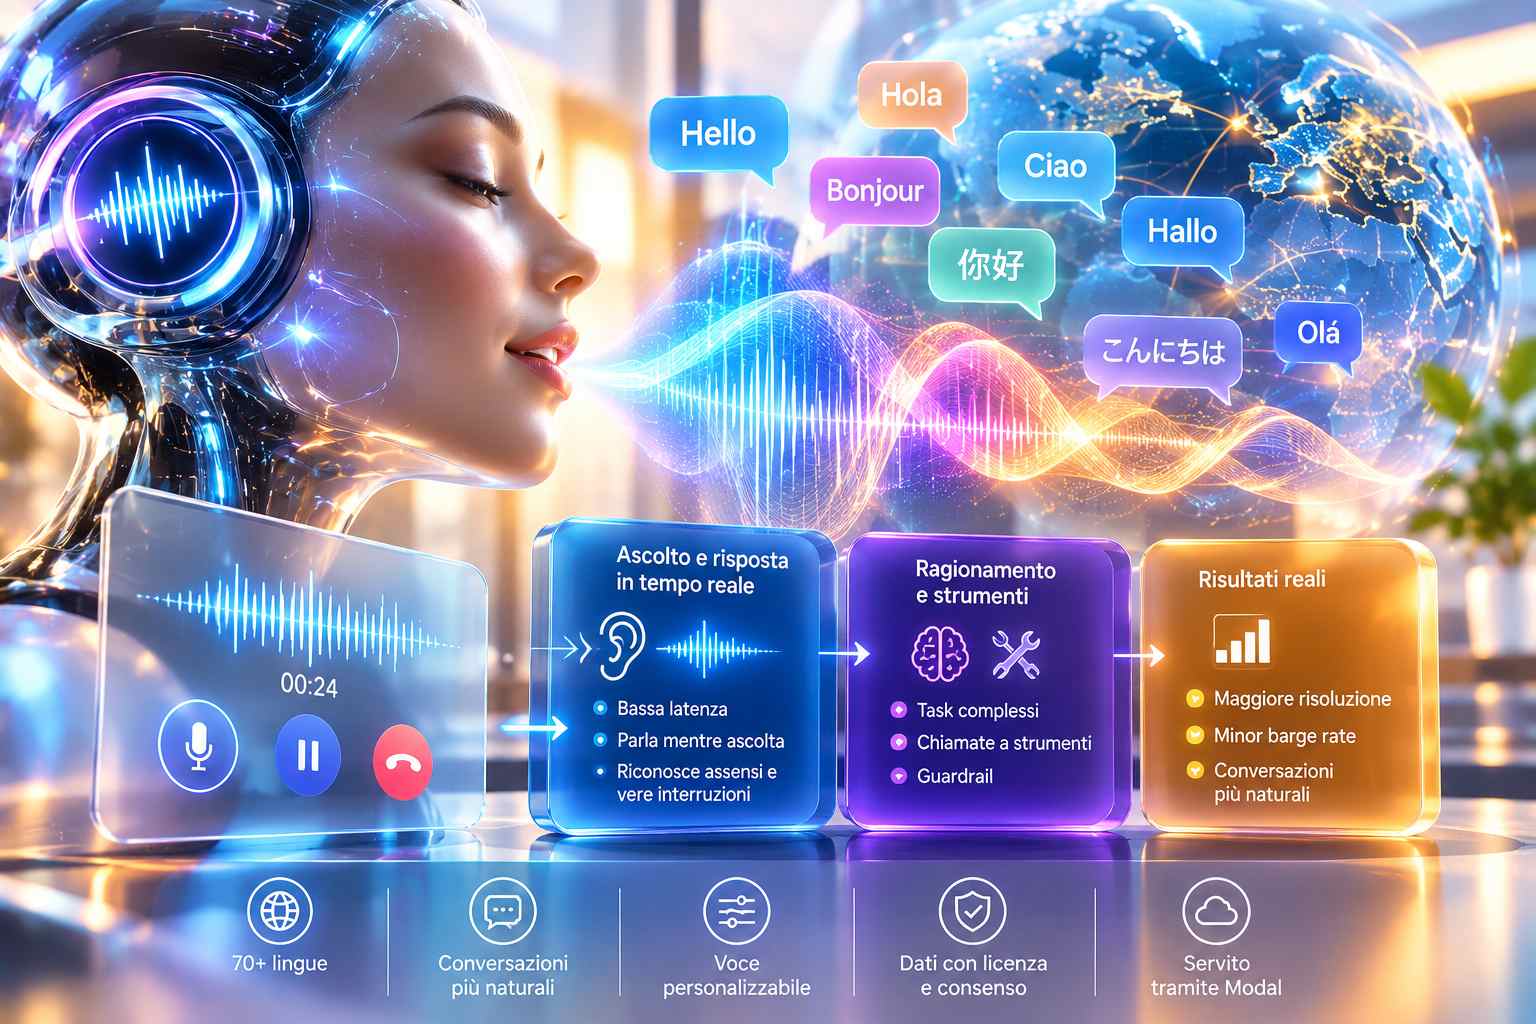
Decagon ha presentato Voice 3, la nuova generazione del proprio agente vocale per il customer service, insieme a Chord, il primo modello speech sviluppato da Decagon Labs. Voice 3 supporta oltre 70 lingue e utilizza un’architettura duplex progettata per rendere più naturale il dialogo telefonico, superando la classica pipeline composta da speech-to-text, modello linguistico e text-to-speech eseguiti in sequenza. Il sistema separa invece il lavoro tra due livelli che operano in parallelo: un modello conversazionale a bassa latenza gestisce ascolto, risposta e aggiornamenti vocali immediati, mentre un modello più potente si occupa in background di ragionamento, chiamate a strumenti e applicazione delle guardrail. In questo modo l’agente può continuare ad ascoltare anche mentre parla, distinguere semplici segnali di assenso come “mhm” da vere interruzioni, raccontare all’utente cosa sta facendo durante operazioni lunghe e rispondere a domande successive senza interrompere il task già in corso.
Chord è stato addestrato specificamente sulle conversazioni di customer experience anziché su casi d’uso generalisti come audiolibri o doppiaggio, e modula frase per frase ritmo, enfasi e velocità: può rallentare, ad esempio, durante la lettura di un codice di conferma o di un numero telefonico e tornare subito dopo a un’andatura più naturale. Il modello conserva anche i controlli già disponibili sulla personalizzazione della voce, sulla pronuncia di termini specifici dell’azienda e sullo stile di erogazione, mentre Voice 3 rileva automaticamente la lingua utilizzata dal chiamante e può cambiarla anche nel mezzo della stessa frase. Le voci vengono adattate ai diversi mercati e validate da parlanti madrelingua; Decagon specifica inoltre che Chord è stato addestrato su dati concessi in licenza e su voci registrate con consenso, senza utilizzare dati appartenenti ai clienti.
La pipeline di addestramento è stata costruita per mantenere elementi tipici della conversazione reale che molti sistemi tendono invece a eliminare, come cambi di ritmo, pause, enfasi e filler. Decagon utilizza una trascrizione verbatim che conserva anche disfluenze e caratteristiche prosodiche e un metodo di registrazione che combina il contenuto di un copione con una resa più vicina al parlato spontaneo. Alla base di Chord c’è inoltre un diffusion model privo di tokenizer: secondo Decagon, evitare la discretizzazione dell’audio in token consente di conservare più informazioni acustiche e rende il modello maggiormente controllabile sul piano di emozione, velocità ed enfasi. In produzione Chord viene servito attraverso Modal.
Nei test riportati dall’azienda su clienti dei settori telecomunicazioni, servizi finanziari e travel, il passaggio da una voce standard a Chord avrebbe aumentato il tasso di risoluzione rispettivamente di 6,1, 7,1 e 2,6 punti percentuali, riducendo al tempo stesso di 14,5, 6,1 e 5,3 punti il cosiddetto barge rate, cioè la quota di chiamate in cui l’utente cerca soltanto di raggiungere un operatore umano. In un blind test in cui la stessa registrazione veniva proposta sia con Chord sia con il doppiatore umano utilizzato come riferimento, il 45,7% degli ascoltatori ha scambiato la voce reale per quella artificiale; in un secondo confronto con altri tre modelli speech, condotto su 185 partecipanti, Chord ha ottenuto complessivamente il 36,2% delle preferenze, arrivando fino al 48,4% in singoli round. Decagon considera comunque il comportamento della voce durante conversazioni lunghe e imprevedibili un problema più rilevante della sola somiglianza acustica con un essere umano, e utilizza Chord come esempio della propria strategia di sviluppare modelli fortemente specializzati per le interazioni con i clienti anziché affidarsi esclusivamente a modelli general purpose.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)