
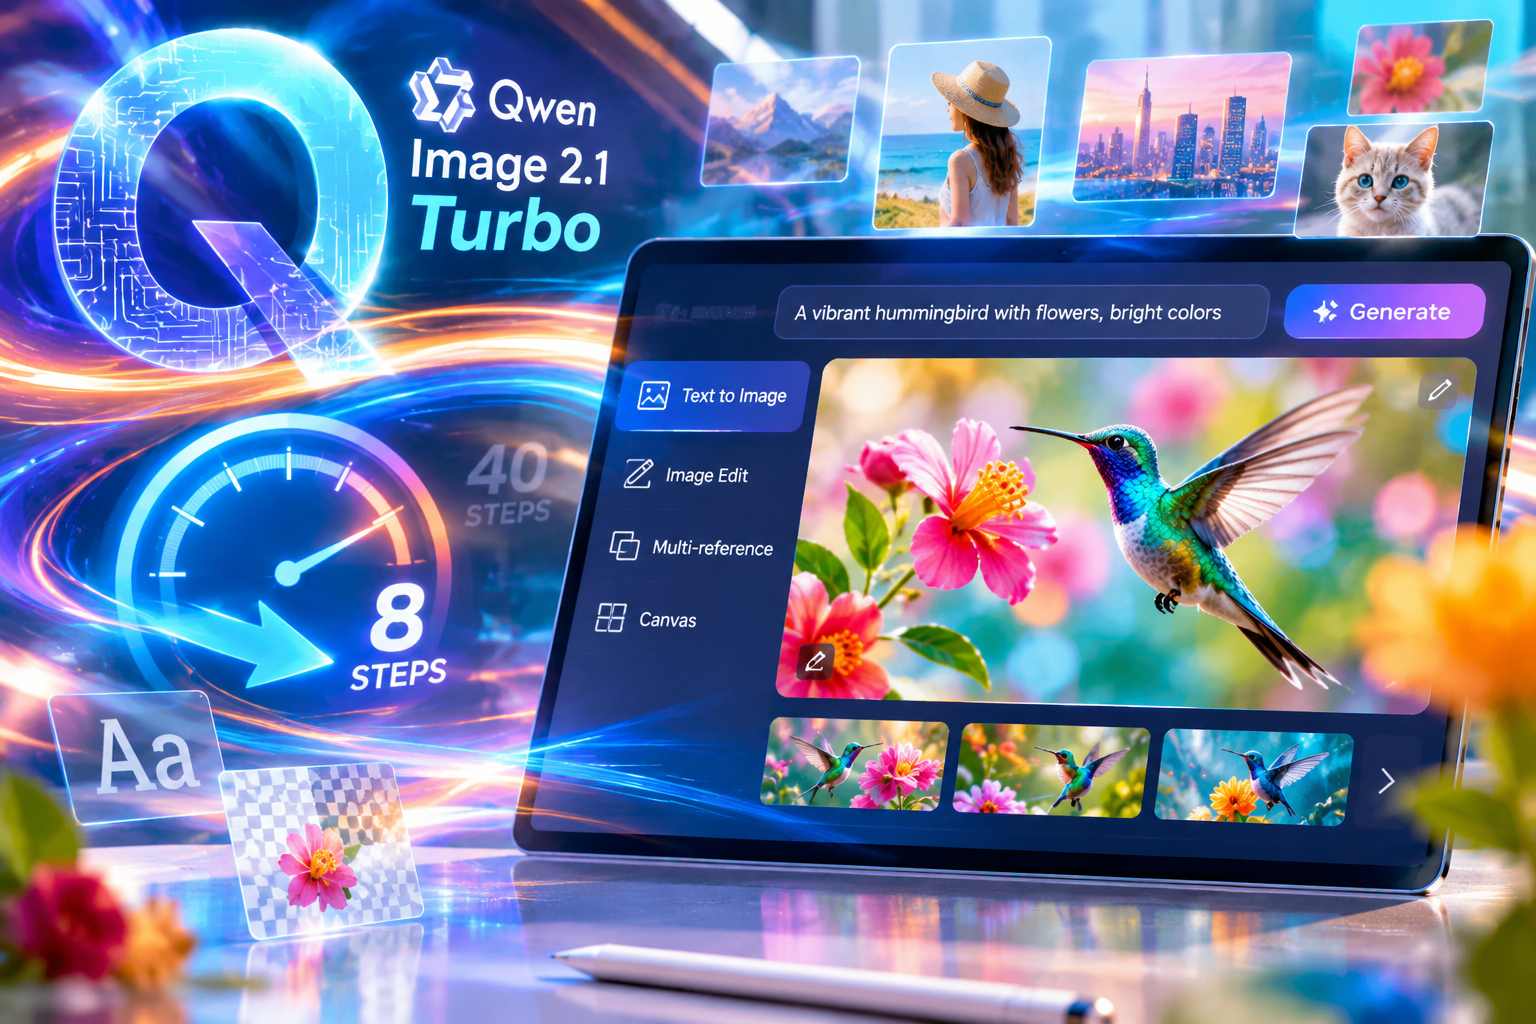
Alibaba, attraverso il team Qwen, ha rilasciato Qwen-Image 2.1 Turbo, una versione accelerata del proprio modello di intelligenza artificiale dedicato alla generazione e alla modifica delle immagini, progettata per ridurre sensibilmente il numero di operazioni necessarie alla produzione dei risultati visivi. Il nuovo checkpoint, pubblicato il 9 ottobre 2026 su Hugging Face, mantiene l’architettura di generazione da 7 miliardi di parametri di Qwen-Image 2.1, ma introduce una procedura di campionamento che permette di completare la generazione attraverso otto passaggi di denoising, rispetto ai quaranta normalmente utilizzati dalla versione originale. La riduzione riguarda quindi il numero di iterazioni attraverso le quali il modello trasforma progressivamente una rappresentazione rumorosa in un’immagine, conservando le principali capacità già disponibili nella famiglia Qwen-Image 2.1. Il checkpoint Turbo supporta la creazione di immagini a partire da descrizioni testuali, la modifica di contenuti visivi esistenti, l’utilizzo di riferimenti multipli e la produzione di composizioni articolate che comprendono elementi tipografici, interfacce e soggetti differenti. Il modello viene distribuito come componente utilizzabile attraverso la libreria Diffusers e altri ambienti compatibili, consentendo agli sviluppatori di integrarlo in applicazioni locali e workflow di produzione senza dipendere necessariamente da un’interfaccia proprietaria. La principale innovazione non consiste nell’introduzione di una nuova famiglia architetturale, ma nell’ottimizzazione del processo inferenziale applicato a un modello già addestrato, così da ridurre il costo computazionale associato alla generazione e rendere più praticabili le elaborazioni iterative.
Il funzionamento di Qwen-Image 2.1 Turbo si basa sull’impiego di uno specifico checkpoint accelerato, associato a una sequenza di campionamento raccomandata che viene caricata automaticamente insieme ai pesi del modello. Nei sistemi generativi basati sulla diffusione, il risultato viene costruito attraverso una serie di trasformazioni successive che riducono progressivamente il rumore presente nella rappresentazione iniziale, fino a ottenere un’immagine coerente con le istruzioni fornite. Il numero di passaggi influisce direttamente sulla quantità di elaborazione necessaria, poiché ciascuna iterazione richiede l’esecuzione delle componenti neurali incaricate di prevedere e applicare la trasformazione successiva. Ridurre le iterazioni da quaranta a otto significa diminuire di cinque volte il numero dei passaggi di denoising, ma non implica automaticamente una riduzione identica del tempo complessivo di generazione. La durata effettiva dipende infatti dalla risoluzione, dalle caratteristiche dell’hardware, dalla preparazione degli input, dall’elaborazione delle immagini di riferimento e dalle operazioni necessarie a ricostruire il risultato finale. La versione Turbo è stata ottimizzata per operare con una scala di classifier-free guidance, indicata come CFG, pari a 1, valore che differisce dalle configurazioni normalmente utilizzate da altri modelli di diffusione. Le impostazioni del campionamento sono conservate nel checkpoint e vengono applicate direttamente dalla pipeline, evitando che l’utilizzatore debba ricostruire manualmente la sequenza delle intensità di rumore prevista dal sistema. Il semplice cambiamento del parametro num_inference_steps non sostituisce inoltre il programma di campionamento incorporato, mentre una configurazione esplicita dei valori sigma permette di sovrascriverlo per esigenze sperimentali, senza che Qwen garantisca risultati equivalenti con sequenze non precedentemente valutate.
Un ulteriore elemento dell’ottimizzazione riguarda il prefix KV caching, un meccanismo che consente di riutilizzare rappresentazioni intermedie relative alle informazioni di condizionamento durante i successivi passaggi di generazione. Il modello deve infatti interpretare il prompt e, nelle modalità di modifica, le immagini di riferimento, per mantenere una relazione coerente tra il contenuto richiesto e il risultato visivo prodotto. Quando alcune informazioni rimangono invariate durante il denoising, una parte delle rappresentazioni calcolate dalle componenti di attenzione può essere conservata e riutilizzata invece di essere elaborata nuovamente a ogni iterazione. Qwen-Image 2.1 Turbo integra questo principio nella gestione del contesto testuale e delle immagini di riferimento, riducendo le operazioni ripetitive durante la generazione. La tecnica agisce su una componente differente rispetto alla riduzione dei passaggi: il campionamento accelerato diminuisce il numero di iterazioni complessive, mentre il caching cerca di limitare il lavoro ridondante all’interno delle iterazioni effettivamente eseguite. I benefici dipendono dalla struttura della pipeline, dalle caratteristiche degli input e dalla gestione della memoria disponibile. Il modello conserva quindi la capacità di interpretare istruzioni testuali complesse e informazioni visive, ma utilizza una procedura inferenziale progettata specificamente per eseguire tali operazioni in maniera più efficiente.
La nuova versione mantiene le principali funzionalità di generazione visiva introdotte da Qwen-Image 2.1, comprese la produzione di immagini fotografiche, la rappresentazione di figure umane in movimento, la composizione di poster e materiali grafici e la realizzazione di schermate con elementi strutturati. Particolare attenzione viene dedicata alla resa dei testi incorporati nelle immagini, una capacità importante quando il risultato deve comprendere titoli, etichette, diagrammi, impaginazioni o elementi appartenenti a un’interfaccia utente. Il checkpoint supporta anche immagini con canale alfa, permettendo la produzione di contenuti RGBA con trasparenza, utilizzabili per elementi grafici da sovrapporre ad altre composizioni. Questa funzionalità è distinta dalla semplice generazione di un soggetto sopra uno sfondo uniforme, poiché il canale alfa permette di rappresentare separatamente le informazioni relative al colore e quelle relative all’opacità. Tra gli esempi di utilizzo presentati dal team Qwen figurano immagini fotorealistiche di persone, scene con posture e movimenti articolati, poster illustrati, layout informativi, interfacce visive e soggetti isolati su sfondo trasparente. La disponibilità di una medesima architettura per attività creative differenti consente di utilizzare il checkpoint in procedure di produzione che richiedono sia la generazione iniziale sia successive trasformazioni, evitando necessariamente di passare a un modello completamente diverso per ogni tipologia di elaborazione.
Le capacità di editing permettono di utilizzare un’immagine preesistente come riferimento e di modificarne il contenuto sulla base di nuove istruzioni formulate in linguaggio naturale. La pipeline può ricevere, per esempio, uno schizzo di un oggetto e trasformarlo in una rappresentazione fotorealistica, mantenendo gli elementi strutturali descritti nell’input. Le dimostrazioni comprendono la trasformazione di uno schizzo nautico in una fotografia realistica di uno yacht, con indicazioni relative alla geometria dello scafo, alla disposizione delle sovrastrutture, alle aperture, alle caratteristiche cromatiche e alle condizioni di illuminazione. Questo tipo di attività richiede al modello di combinare la rappresentazione visiva di partenza con istruzioni che specificano quali caratteristiche debbano essere conservate e quali trasformate. Qwen-Image 2.1 Turbo supporta inoltre composizioni costruite utilizzando più immagini di riferimento, permettendo di integrare soggetti, ambienti e oggetti all’interno di una nuova scena. La raccolta di esempi diffusa con il checkpoint comprende elaborazioni basate su quattro riferimenti visivi per la composizione di ambienti interni, oltre a trasformazioni di singole immagini e combinazioni più articolate. La maggiore velocità del campionamento può risultare particolarmente utile in queste attività, nelle quali ottenere un risultato utilizzabile richiede spesso di confrontare varianti successive, correggere dettagli e adattare il prompt sulla base delle immagini precedentemente prodotte.
Il modello supporta diversi rapporti d’aspetto e risoluzioni elevate, utilizzando le impostazioni previste dalla famiglia Qwen-Image 2.1. Tra le configurazioni documentate figurano il formato quadrato da 2048 × 2048 pixel, quello orizzontale 4:3 da 2400 × 1792 pixel e il formato verticale 3:4 da 1792 × 2400 pixel. Sono inoltre disponibili il formato 3:2 da 2528 × 1696 pixel, il corrispondente verticale 2:3 da 1696 × 2528 pixel e le configurazioni panoramiche 16:9 da 2752 × 1536 pixel e 9:16 da 1536 × 2752 pixel. La disponibilità di questi preset permette di utilizzare il checkpoint per differenti destinazioni editoriali, comprese immagini orizzontali per articoli, composizioni verticali, materiali per social network e grafiche quadrate. La risoluzione influisce tuttavia sul fabbisogno di memoria e sui tempi di esecuzione, poiché l’elaborazione deve gestire rappresentazioni visive di dimensioni differenti. Il checkpoint viene distribuito con pesi BF16 e conserva una dotazione complessiva di file che comprende componenti per la codifica testuale, il Transformer, il VAE e la configurazione del campionamento. La struttura rimane quella di una pipeline di generazione multimodale composta da più elementi e non deve essere confusa con un singolo file contenente esclusivamente i pesi del generatore visivo.
La distribuzione ufficiale avviene attraverso il repository Qwen/Qwen-Image-2.1-Turbo su Hugging Face, con supporto alla classe QwenImage21Pipeline della libreria Diffusers. Per l’installazione, il team Qwen indica l’utilizzo di PyTorch compatibile con CUDA e delle dipendenze Transformers, Accelerate e Pillow. È richiesta inoltre una versione di Diffusers che supporti le configurazioni dei sigma incorporate nella pipeline, funzionalità aggiunta attraverso una modifica specifica al progetto. Gli sviluppatori possono caricare il checkpoint in memoria, impostare il dispositivo di elaborazione, fornire istruzioni testuali e ottenere le immagini prodotte attraverso le normali interfacce della libreria. Le funzionalità di editing utilizzano la stessa famiglia di componenti, aggiungendo gli input visivi necessari alla trasformazione. L’ecosistema ComfyUI dispone inoltre di adattamenti e pacchetti destinati a rendere il checkpoint utilizzabile attraverso workflow grafici a nodi, consentendo di combinare generazione, riferimenti visivi e successive trasformazioni. La disponibilità dei pesi permette di sperimentare configurazioni locali e procedure automatizzate, ma non elimina i requisiti hardware associati a un modello multimodale da 7 miliardi di parametri e alle risoluzioni elevate supportate. Il rilascio avviene sotto Qwen Research License, una licenza che non equivale a una concessione commerciale indiscriminata: gli sviluppatori interessati alla distribuzione di servizi o prodotti devono verificare preventivamente le condizioni applicabili. Qwen-Image 2.1 Turbo viene quindi proposto come checkpoint specializzato nell’accelerazione del processo generativo, mantenendo la varietà delle funzioni disponibili nella versione originale e introducendo una configurazione inferenziale destinata a rendere più efficienti le operazioni di produzione e modifica delle immagini.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)