
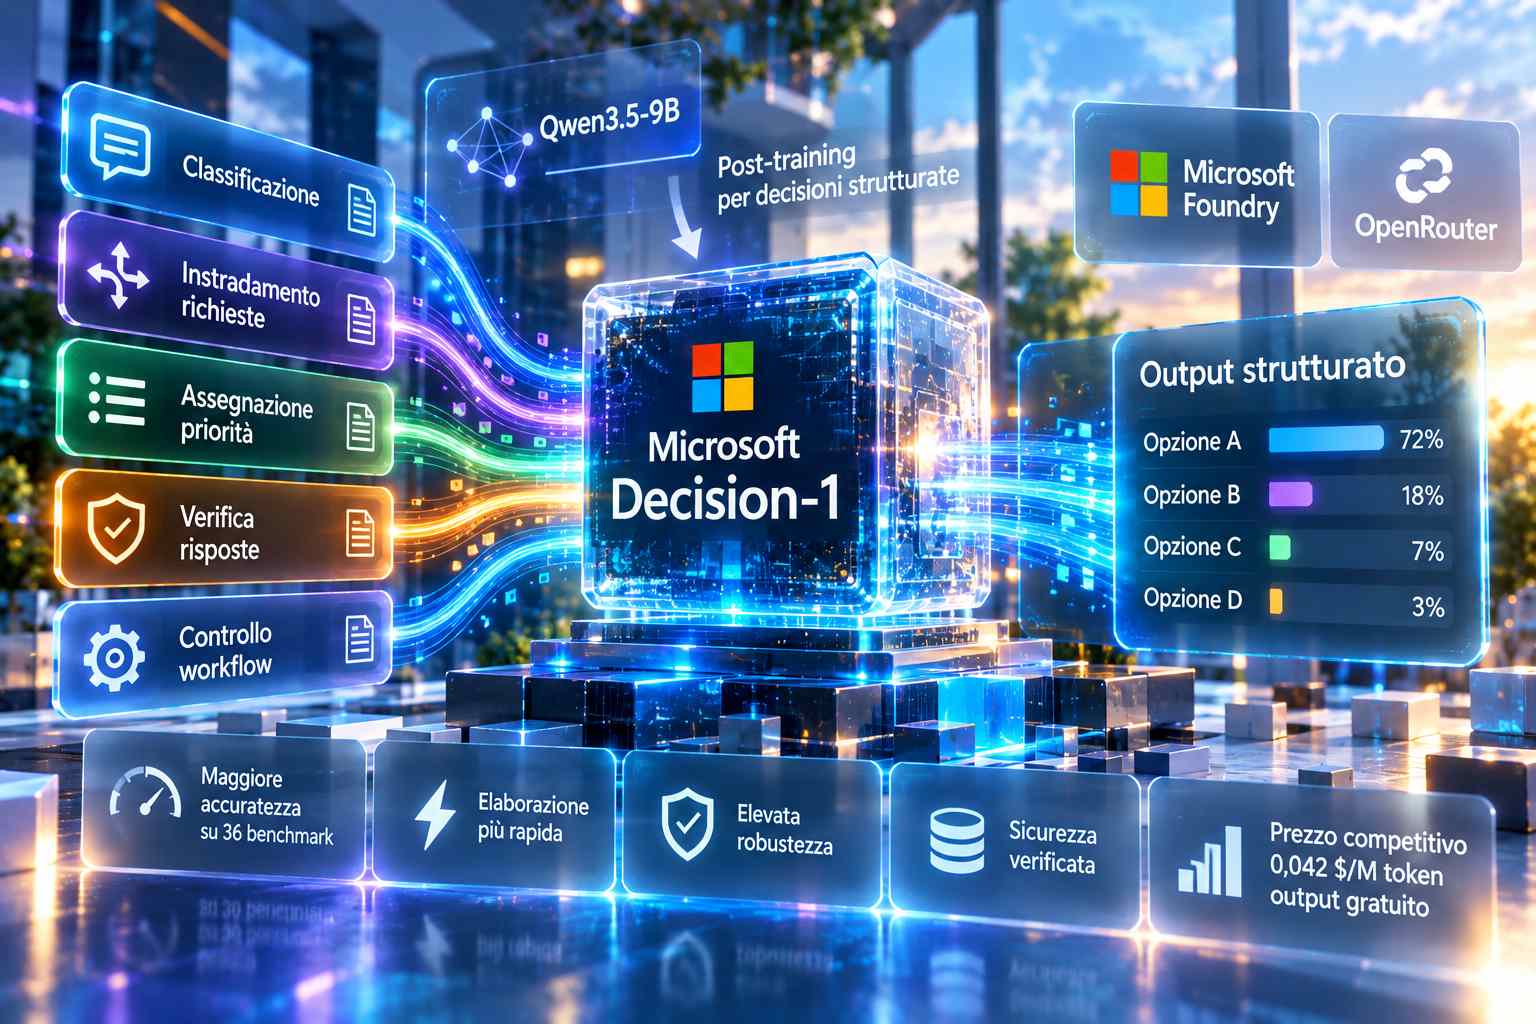
Microsoft ha presentato Microsoft-Decision-1, un modello di intelligenza artificiale specializzato nell’elaborazione rapida di decisioni strutturate che possono essere utilizzate direttamente da applicazioni software, sistemi agentici e processi automatizzati. Annunciato il 9 ottobre 2026, il modello è disponibile attraverso Microsoft Foundry e OpenRouter ed è progettato per operazioni di classificazione, instradamento delle richieste, assegnazione delle priorità, verifica delle risposte e controllo dei flussi di lavoro. La sua architettura deriva da Qwen3.5-9B, modello open-weight di Alibaba sul quale Microsoft ha eseguito un addestramento successivo specificamente orientato alla valutazione delle alternative e alla produzione di punteggi probabilistici. Diversamente dai modelli linguistici generalisti, Decision-1 non deve costruire una risposta testuale articolata per esprimere una scelta, ma restituisce direttamente valori strutturati associati alle opzioni disponibili. Secondo le valutazioni pubblicate dall’azienda, il modello ha ottenuto la maggiore accuratezza media in un confronto comprendente 36 benchmark e quasi 150.000 quesiti, registrando anche tempi di elaborazione inferiori rispetto ai modelli di riferimento nelle condizioni sperimentali dichiarate.
Decision-1 appartiene alla categoria dei decision-scoring model, sistemi progettati per valutare un insieme definito di possibilità anziché produrre liberamente contenuti in linguaggio naturale. L’applicazione trasmette una situazione da analizzare e una domanda associata a un numero prestabilito di risposte ammissibili; il modello elabora l’input in un singolo passaggio e assegna una probabilità calibrata a ciascuna alternativa. Sono supportate domande binarie, selezioni multiple, classificazioni per categoria, scale di valutazione e rubriche che specificano i criteri con i quali giudicare una risposta o un’azione proposta da un agente. Una procedura di assistenza clienti può quindi utilizzare il modello per distinguere una richiesta commerciale da un problema tecnico, mentre un sistema di controllo può assegnare a un evento un livello di priorità oppure scegliere se inoltrare un risultato a un operatore umano. Il formato strutturato elimina la necessità di interpretare una risposta discorsiva per estrarre l’etichetta corretta, riducendo le elaborazioni aggiuntive che normalmente accompagnano l’impiego degli LLM nei workflow applicativi.
Il modello è stato ottenuto attraverso il post-training di Qwen3.5-9B, mantenendo una logica di inferenza single-pass orientata alla produzione diretta dei punteggi. Microsoft ha dichiarato di voler estendere successivamente questa impostazione ad altre basi modellistiche, comprese le famiglie Microsoft AI e OpenAI. La documentazione del catalogo Microsoft Foundry specifica che i dati impiegati nell’addestramento comprendono dataset pubblicamente disponibili sottoposti al processo di valutazione Open Data di Microsoft e dati sintetici prodotti dal gruppo di sviluppo. Il sistema permette di associare probabilità alle alternative in maniera tale che il software chiamante possa applicare proprie soglie decisionali. Quando il valore di confidenza supera il limite stabilito dall’applicazione, la scelta può essere eseguita automaticamente; negli altri casi, il processo può richiedere una nuova valutazione oppure trasferire l’operazione a un modello più avanzato o a una persona. La calibrazione rappresenta quindi una caratteristica funzionale del modello, perché una probabilità del 90% dovrebbe corrispondere, su casi rappresentativi, a una frequenza di decisioni corrette prossima a nove su dieci.
Microsoft ha valutato Decision-1 su un insieme di 36 benchmark contenenti complessivamente circa 147.137 quesiti, selezionati per verificare la capacità di generalizzare oltre le specifiche attività di addestramento. Il confronto ha incluso classificazione, routing, ranking, elaborazione di contesti lunghi, richieste multilingue, situazioni fuori distribuzione, ragionamento e sicurezza. Sono stati considerati anche modelli specializzati presenti nelle classifiche pubbliche dedicate alle decisioni strutturate, tra cui Jev e altri sistemi concorrenti. Microsoft afferma che Decision-1 ha raggiunto la migliore accuratezza media sul complesso delle prove, ma tale affermazione si riferisce alla metodologia e al gruppo di modelli scelti dall’azienda. Le misurazioni della latenza pubblicate nella versione aggiornata della documentazione indicano prestazioni 2,5 volte più rapide rispetto a H2O-Lightning-4B v1.1 e circa 35 volte più rapide rispetto a GPT-6 Sol. I rapporti di velocità sono dunque risultati di benchmark specifici e non garantiscono un’accelerazione identica in ogni applicazione o infrastruttura di esecuzione.
La valutazione della robustezza ha analizzato la capacità del modello di mantenere decisioni coerenti quando una richiesta viene modificata nella forma senza alterarne il significato sostanziale. Microsoft ha applicato otto tipologie di perturbazioni, comprendenti riformulazioni delle istruzioni, modifiche descrittive alle opzioni disponibili, variazioni dell’ordine delle risposte e cambiamenti nella struttura degli input. In media, Decision-1 ha modificato la propria scelta nell’1,3% dei casi sottoposti a queste trasformazioni. Nei test relativi alla parafrasi delle descrizioni delle opzioni e all’inversione o al rimescolamento del loro ordine, l’azienda non ha registrato cambiamenti della decisione. Per gli utilizzi applicativi questo parametro assume rilievo quando lo stesso processo deve trattare input generati da sistemi differenti o contenenti variazioni linguistiche e formali, perché una classificazione dipendente dalla disposizione delle alternative potrebbe produrre comportamenti incoerenti in un sistema automatizzato. Le misurazioni restano comunque limitate alle perturbazioni previste nel protocollo sperimentale.
Le verifiche di sicurezza sono state effettuate utilizzando 5.250 richieste distribuite su undici benchmark relativi a contenuti dannosi, tentativi di jailbreak e prompt injection. Microsoft ha dichiarato che Decision-1 ha dimostrato la capacità di rifiutare comportamenti dannosi, conservando contemporaneamente un’elevata utilità nelle richieste legittime. La documentazione disponibile non consente tuttavia di equiparare questo risultato all’assenza di vulnerabilità in qualunque applicazione. La valutazione della sicurezza assume particolare rilievo quando un modello viene impiegato per autorizzare o bloccare operazioni proposte da altri agenti, perché l’errore non si traduce soltanto in una risposta inaccurata, ma può comportare l’esecuzione o il rifiuto di un’azione all’interno di un sistema informatico. La sperimentazione interna ha coinvolto differenti gruppi Microsoft. Xbox Research ha utilizzato Decision-1 per classificare oltre 10.000 feedback e recensioni a risposta aperta provenienti da indagini, Steam e Twitter/X, assegnandoli a categorie tematiche definite dai ricercatori. In questa attività il modello ha mostrato, secondo Microsoft, una qualità competitiva rispetto a GPT-6 Sol, con una velocità superiore di oltre quattordici volte e un costo inferiore di circa duecento volte. Il team Copilot ha invece sperimentato il modello per la valutazione della qualità delle risposte conversazionali e delle attività agentiche, dichiarando prestazioni competitive con GPT-5.6 Luna e un’elaborazione cento volte più rapida. Un ulteriore impiego riguarda la gestione degli incidenti informatici, dove gli ingegneri reperiscono informazioni attraverso registri, ticket, chiamate, messaggi e documentazione tecnica: nei test aziendali, Decision-1 ha ottenuto risultati migliori e più rapidi rispetto al modello linguistico utilizzato come riferimento per il recupero delle informazioni.
Nel progetto Microsoft Discovery, dedicato all’utilizzo dell’intelligenza artificiale nei processi di ricerca scientifica, il modello è stato integrato in un meccanismo di pianificazione adattiva. Un agente valuta i risultati di un esperimento, assegna punteggi sulla base di criteri prestabiliti, modifica il proprio approccio e ripete il procedimento fino al raggiungimento degli obiettivi. In questo contesto Decision-1 ha prodotto, secondo le misurazioni interne, punteggi quarantasei volte più consistenti rispetto al sistema di valutazione basato su un LLM, operando a una velocità tripla. L’integrazione ha portato a un’accelerazione prossima a quattro volte della procedura di ripianificazione adattiva. Il miglioramento non riguarda quindi soltanto il tempo necessario a classificare un singolo input, ma anche la riduzione del ritardo introdotto dalle decisioni ripetute all’interno di un workflow composto da numerosi passaggi consecutivi.
Microsoft-Decision-1 viene distribuito con un prezzo dichiarato di 0,042 dollari per milione di token in ingresso e senza addebito per i token in uscita. Questa struttura tariffaria è coerente con la quantità limitata di output richiesta dai modelli decisionali, nei quali il risultato consiste in un insieme di alternative e probabilità anziché in una lunga sequenza testuale. Il servizio è accessibile tramite Microsoft Foundry, mentre la distribuzione attraverso i provider compatibili permette di inserirlo in applicazioni che utilizzano interfacce standardizzate per l’inferenza. Decision-1 non sostituisce un modello generativo nelle attività che richiedono produzione di contenuti, ragionamento aperto o generazione di codice, ma può essere utilizzato per assegnare a questi sistemi i compiti più appropriati, controllarne i risultati e determinare i successivi passaggi di elaborazione. La disponibilità del modello rappresenta quindi l’introduzione di un componente specializzato destinato a essere richiamato ripetutamente all’interno di applicazioni e agenti software.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)