
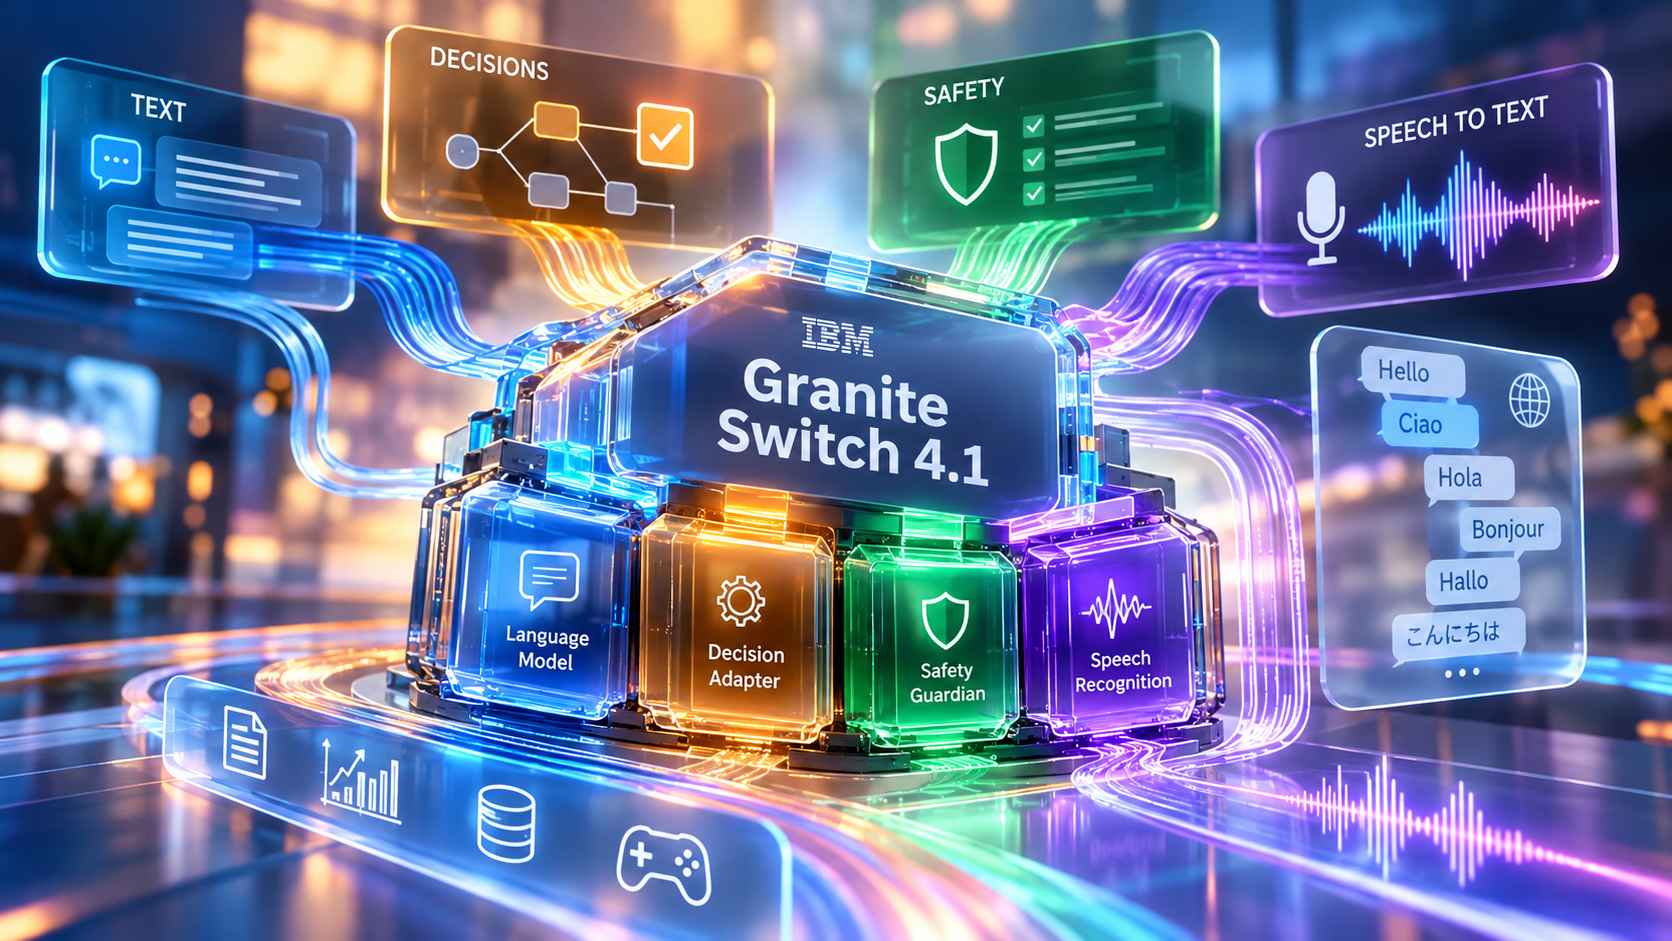
IBM ha rilasciato Granite Switch 4.1, una famiglia di modelli linguistici modulari composta dalle versioni Granite-Switch-4.1-8B e Granite-Switch-4.1-30B, rispettivamente da 8 e 30 miliardi di parametri. I modelli combinano un’architettura linguistica di base con componenti specializzati per il processo decisionale, la valutazione della sicurezza e la trascrizione vocale, riuniti in un unico endpoint di inferenza. Le schede tecniche, che riportano come data di rilascio il 14 ottobre, indicano una finestra contestuale di 128.000 token, una licenza Apache 2.0 e la compatibilità con Hugging Face Transformers e vLLM. L’implementazione utilizza la tecnologia Activated LoRA, denominata aLoRA, per attivare dinamicamente gli adapter specializzati durante l’elaborazione, evitando di mantenere in memoria più modelli completi. Secondo IBM, la combinazione del modello di base, degli adapter e del componente vocale richiede una quantità di memoria GPU approssimativamente equivalente a quella necessaria per il solo modello linguistico principale.
La configurazione integra un decision adapter generalista, un adapter guardian-core appartenente alla famiglia IBM Guardian e il modello Granite Speech 5.0 TurboCTC, un encoder vocale da 470 milioni di parametri basato su un’architettura Conformer non autoregressiva con Connectionist Temporal Classification. Guardian-core è progettato per individuare contenuti potenzialmente dannosi, tentativi di jailbreak, linguaggio offensivo, violenza, contenuti sessuali, pregiudizi sociali e comportamenti considerati non etici. Il modulo vocale opera in lingua inglese e permette di convertire l’audio in testo all’interno della medesima infrastruttura utilizzata per conversazione e classificazione. IBM descrive TurboCTC come il modello di riconoscimento automatico del parlato più veloce nella graduatoria OpenASR considerata al momento del rilascio. Sono inoltre disponibili varianti preview prive del componente audio, comprese configurazioni da 3, 8 e 30 miliardi di parametri, che integrano gli adapter delle Granite Libraries.
Il funzionamento di Granite Switch si basa su un meccanismo di coarse-grained expert switching: un adapter rimane attivo per una sequenza contigua di token attraverso tutti i livelli del decoder, mentre specifici token di controllo inseriti nel template della conversazione determinano la selezione della componente da utilizzare. Un livello di commutazione basato sull’attenzione identifica tali istruzioni e assegna gli indici degli adapter alle posizioni della sequenza, permettendo ai diversi strati del modello di applicare i pesi LoRA corrispondenti. Ogni adapter utilizza la cache key-value del modello di base senza accedere allo stato interno degli altri adapter, può essere addestrato e verificato indipendentemente e non richiede un addestramento congiunto con gli altri moduli. La struttura consente inoltre di riutilizzare la cache generata dal modello principale durante le successive elaborazioni specialistiche. Il decision adapter riceve uno stato, una domanda e un insieme di opzioni etichettate, restituendo in un singolo passaggio di inferenza una distribuzione di probabilità softmax sulle alternative; nel caso di input vocale, il testo prodotto dall’encoder sostituisce l’audio nel contesto della conversazione, senza richiedere un server di trascrizione separato.
IBM ha presentato anche un ambiente dimostrativo Speech-to-Decisions, nel quale il modello da 8 miliardi di parametri trascrive il parlato, genera riepiloghi, verifica contenuti potenzialmente dannosi e valuta quindici ulteriori condizioni definite dall’utente, utilizzando lo stesso endpoint. Le prove pubblicate comprendono confronti con modelli decisionali generalisti e misurazioni sul Decision Index. Nel sottoinsieme pubblico rapido, composto da 1.068 elementi, Granite Switch 4.1-8B ha ottenuto un punteggio complessivo di 42,9, con risultati di 29,1 per Knowledge, 48,9 per Language, 49,8 per Retrieval, 59,8 per Tools e 18,0 per Arts. La versione da 30 miliardi ha raggiunto 50,1 punti complessivi, con 32,4 per Knowledge, 58,6 per Language, 49,8 per Retrieval, 76,5 per Tools e 26,4 per Arts. IBM indica differenze di circa 0,6 punti tra le esecuzioni locali e quelle effettuate mediante endpoint vLLM ospitati.
Nei confronti pubblicati, IBM attribuisce a guardian-core prestazioni mediamente superiori a Jev 1.13, Microsoft-Decision-1, GPT-Luna-Decisions e Clef-Flash nelle attività decisionali riguardanti la sicurezza. Gli adapter specializzati delle Granite Libraries mostrano vantaggi dichiarati di 2,3 punti su OOD Safety, 17,0 su IFEval, 11,0 su BIO F1 e 11,8 su RAGTruth, mentre risultano inferiori rispettivamente di 2,6, 3,2 e 0,8 punti su LM-AggreFact, InfoBench-GPT4 e InfoBench-Human. Un’ulteriore dimostrazione riguarda un workflow RAG articolato in cinque passaggi, eseguito più rapidamente con un modello Granite Switch da 30 miliardi e quattro adapter rispetto alla configurazione di confronto Jev-27B. In un test basato sul videogioco Doom, un modello personalizzato da 3 miliardi di parametri ha raggiunto tra 60 e 100 decisioni al secondo, contro le 10 attribuite al sistema comparato, mantenendo anche capacità conversazionali durante l’esecuzione del gioco. Queste misurazioni sono presentate da IBM e dipendono dalle configurazioni e dai benchmark utilizzati.
I checkpoint sono distribuiti con requisiti dichiarati comprendenti Python 3.9 o successivo, PyTorch dalla versione 2.11.0, Transformers tra 5.16 e 5.17.0 e, facoltativamente, vLLM dalla versione 0.26.0 fino alle release precedenti alla 0.28.0. L’architettura decoder-only utilizza grouped-query attention, RoPE, SwiGLU e RMSNorm e supporta, tra le altre, inglese, italiano, tedesco, spagnolo, francese, giapponese, portoghese, arabo, ceco, coreano, olandese e cinese. Gli sviluppatori possono comporre configurazioni personalizzate combinando adapter del catalogo IBM attraverso gli strumenti dedicati, mentre Mellea viene indicato come livello applicativo di riferimento per le integrazioni future. IBM prevede anche un Adapter SDK per l’addestramento di componenti personalizzati. Tra le limitazioni documentate figurano il supporto esclusivo all’inglese della trascrizione vocale, la produzione di trascrizioni in minuscolo senza punteggiatura, la possibilità che errori di riconoscimento alterino le decisioni successive e il limite di vLLM nella gestione delle probabilità per oltre 128 token identificativi delle opzioni. Gli adapter di sicurezza non sostituiscono inoltre le verifiche applicative e le probabilità decisionali non costituiscono classificazioni certificate per ambiti esterni ai dati di addestramento.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)