
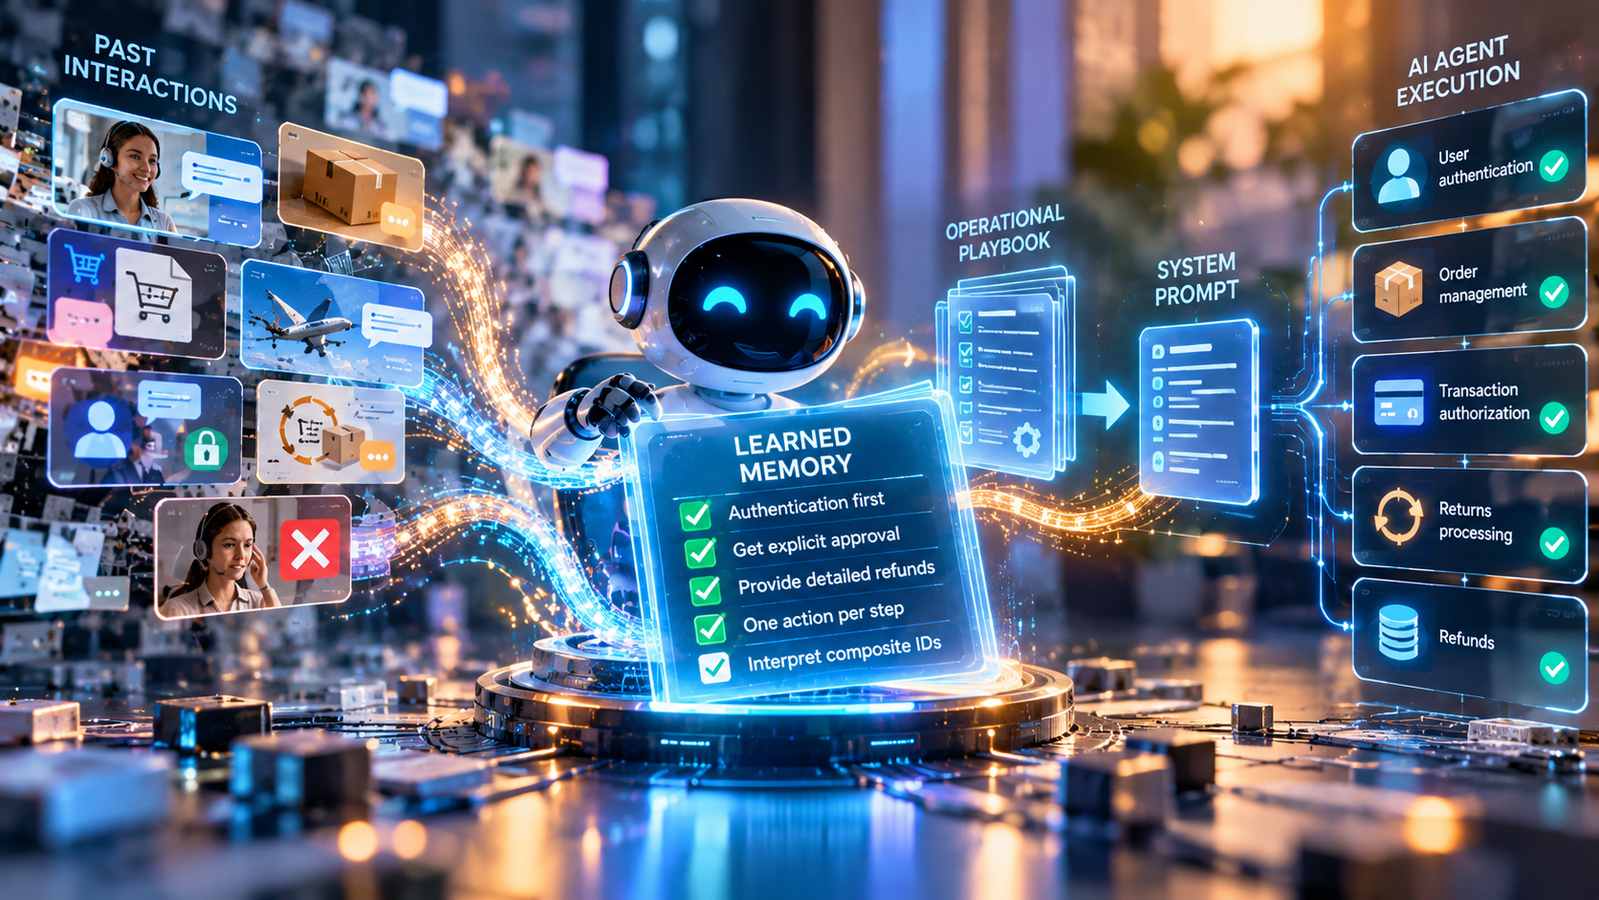
IBM Research ha presentato oggi, 20 ottobre 2026, i risultati di ALTK-Evolve, un metodo per migliorare le prestazioni degli agenti di intelligenza artificiale attraverso una memoria operativa costituita da istruzioni apprese automaticamente durante l’esecuzione di attività precedenti. La tecnica non richiede aggiornamenti dei pesi del modello, procedure di fine-tuning o annotazioni manuali, ma analizza le traiettorie generate dagli agenti durante l’addestramento e utilizza lo stesso modello linguistico per ricavare regole comportamentali dai successi e dagli errori osservati. Le istruzioni vengono raccolte in un playbook e aggiunte al system prompt dell’agente, rendendo disponibili indicazioni operative specifiche per il dominio applicativo. IBM aveva precedentemente sperimentato questo approccio con agenti per la programmazione software e lo ha successivamente esteso al servizio clienti, attraverso attività che comprendono autenticazione degli utenti, gestione degli ordini, autorizzazione delle transazioni, elaborazione dei resi e procedure di rimborso. Alla ricerca hanno contribuito undici autori di IBM Research, tra cui Ashwath Vaithinathan Aravindan, Vatche Isahagian e Vinod Muthusamy.
La valutazione è stata condotta attraverso τ²-bench, un ambiente di simulazione sviluppato da Sierra Research per verificare il comportamento degli agenti nei servizi di assistenza. Il benchmark definisce, per ciascun dominio, politiche operative, strumenti utilizzabili e attività da completare, riproducendo interazioni nelle quali un cliente simulato e un agente possono influire sull’evoluzione della procedura. IBM ha utilizzato i domini retail e airline, nei quali l’agente deve interagire con un cliente simulato da un modello linguistico e utilizzare strumenti collegati a uno stato applicativo. Un’attività viene considerata completata soltanto quando lo stato finale del database corrisponde a quello atteso, secondo un criterio binario che non assegna risultati parziali. L’architettura sperimentale impiega un agente ReAct con ciclo THINK→ACT, GPT-4.1 come modello agente e GPT-5.5 come simulatore del cliente, ripetendo quattro volte ciascun compito. L’unica modifica introdotta nell’agente rispetto alla configurazione di riferimento consiste nell’aggiunta al system prompt, dopo le politiche del dominio, di un elenco Markdown di regole apprese. Gli esempi includono l’obbligo di autenticare il cliente prima di operare sugli ordini, richiedere un’approvazione esplicita prima di aggiornare il database, presentare rimborsi dettagliati, eseguire una sola azione per passaggio e interpretare correttamente identificativi che combinano nomi e altri riferimenti.
L’estrazione delle regole è stata effettuata esclusivamente sulle traiettorie del gruppo di addestramento, senza utilizzare le attività riservate alla verifica finale. A ciascuna istruzione è attribuito un support count, corrispondente al numero di attività distinte dalle quali è stata ricavata. IBM ha confrontato l’agente privo di istruzioni aggiuntive con due configurazioni: sup3, contenente soltanto regole individuate in almeno tre attività, e lossless, che conserva l’intero insieme delle istruzioni selezionate. Nel dominio retail, la configurazione sup3 comprende 31 regole contro le 292 della configurazione lossless; nel dominio airline i rispettivi valori sono 14 e 101. Le prestazioni sono state misurate attraverso la Mean Accuracy, ossia la percentuale media di esecuzioni completate correttamente, e Pass^4, che indica la percentuale di attività concluse con successo in tutte e quattro le ripetizioni. La seconda misura permette di distinguere un agente che riesce occasionalmente a completare un compito da uno capace di riprodurre stabilmente lo stesso risultato.
Sulle 40 attività retail del test separato dall’addestramento, GPT-4.1 senza regole aggiuntive ha raggiunto una Mean Accuracy del 78,1% e un Pass^4 del 57,5%. L’introduzione delle 31 istruzioni sup3 ha portato i risultati rispettivamente al 78,8% e al 60%, mentre le 292 istruzioni lossless hanno consentito di raggiungere l’82,5% e il 67,5%, con incrementi di 4,4 punti percentuali nella precisione media e di 10 punti nella ripetibilità rispetto alla configurazione iniziale. Nel dominio airline, valutato su 20 attività, il modello di riferimento ha ottenuto il 57,5% di Mean Accuracy e il 35% di Pass^4. La versione sup3 ha raggiunto il 60% e il 45%, mentre quella lossless ha conseguito il 65% e il 40%. La differenza dimostra che l’aumento delle istruzioni non produce necessariamente un miglioramento uniforme: per il settore retail l’insieme completo ha fornito i risultati migliori, mentre nell’assistenza aerea il gruppo ristretto di regole ha garantito maggiore affidabilità nelle ripetizioni.
L’aggiunta delle istruzioni comporta un incremento dei token elaborati e dei relativi costi. Sull’insieme completo delle attività, il costo medio per conversazione retail è passato da 0,084 dollari nella configurazione iniziale a 0,139 dollari con lossless, equivalente a un aumento del 65%, mentre nel dominio airline è cresciuto da 0,081 a 0,107 dollari, con un incremento del 32%. Le configurazioni sup3 hanno registrato rispettivamente 0,095 e 0,097 dollari per conversazione. Nelle attività risolte correttamente da entrambe le configurazioni confrontate, l’utilizzo delle istruzioni ha tuttavia ridotto lievemente il numero dei turni conversazionali: nel retail da 10,59 a 10,16 e nell’airline da 9,15 a 8,82. IBM segnala inoltre che il blocco di regole, essendo identico nelle chiamate successive, può beneficiare del prompt caching, limitando in produzione il sovraccosto associato alla ripetizione delle istruzioni.
Una seconda sperimentazione ha impiegato GPT-5.5 sia come agente sia come modello incaricato di estrarre le regole, rigenerando il playbook a partire dalle sue traiettorie nel dominio airline. Nessuna delle istruzioni individuate ha raggiunto un support count di tre, per cui IBM ha adottato una configurazione sup2 di 103 regole e una lossless di 146. Nel test separato, GPT-5.5 senza istruzioni ha ottenuto il 72,5% di Mean Accuracy e il 55% di Pass^4; la versione sup2 è salita all’80% e al 70%, mentre quella lossless ha raggiunto l’82,5% e il 70%. Il miglioramento rispetto alla configurazione iniziale è risultato quindi pari a 10 punti nella precisione media e 15 punti nel Pass^4, con riproduzione degli stessi risultati lossless in esecuzioni successive.
Nelle classifiche τ²-bench considerate da IBM al 12 ottobre 2026, valutate sull’insieme base comprendente attività di addestramento e verifica e pertanto non direttamente confrontabili con i soli risultati held-out, l’agente retail ha raggiunto un Pass^4 del 67,5%, superiore al 61,4% di RAFT-30B-A3B, modello sottoposto a fine-tuning su dati sintetici del dominio. Nel settore airline, la configurazione basata su GPT-5.5 ha registrato l’82%, mentre la variante GPT-4.1 sup3 ha ottenuto il 44%, collocandosi all’ottavo posto nella graduatoria considerata. La candidatura retail, presentata su GitHub il 14 settembre 2026, riporta un Pass^1 dell’81,14% e un Pass^4 del 67,54% su 114 attività, con un costo medio di 0,1084 dollari per conversazione; quella airline, presentata il 21 settembre, registra valori rispettivamente dell’88,50% e dell’82% su 50 attività, con un costo medio di 0,1690 dollari. Entrambe le candidature dichiarano l’utilizzo di prompt modificati, risultano ancora aperte e prevedono la classificazione Unverified. Per il retail viene inoltre esplicitato che le regole sono state apprese da una porzione di addestramento inclusa nell’insieme base utilizzato dalla classifica. ALTK-Evolve dimostra così, nelle condizioni sperimentali descritte, come una memoria procedurale generata automaticamente possa modificare affidabilità e prestazioni degli agenti senza alterare i parametri dei modelli sottostanti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)