
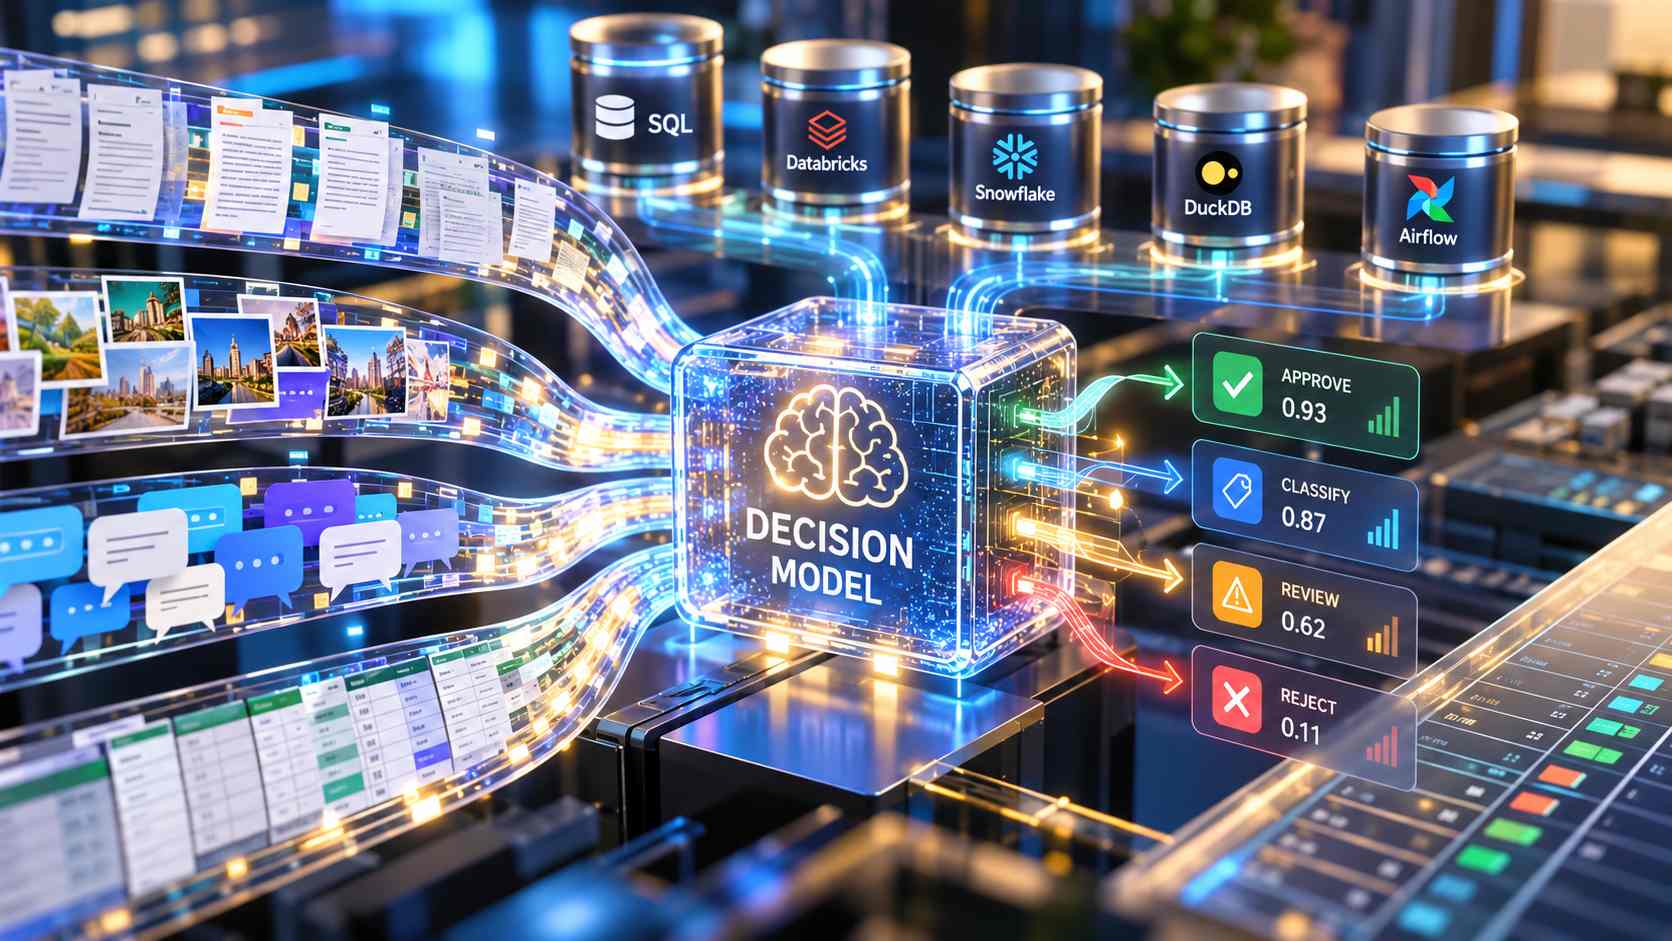
I modelli decisionali come Jev, sviluppato da TypeSafe, stanno entrando negli strumenti di elaborazione dei dati aziendali attraverso integrazioni con piattaforme SQL, sistemi di orchestrazione e infrastrutture di machine learning. A differenza dei tradizionali modelli linguistici generativi, che restituiscono risposte testuali potenzialmente articolate, un modello decisionale produce valori appartenenti a un insieme predefinito di opzioni, punteggi su una scala stabilita oppure probabilità associate a risposte binarie. Il risultato è direttamente utilizzabile all’interno di una tabella, senza dover interpretare un testo generato per ricavarne l’informazione necessaria. Questa caratteristica permette di applicare giudizi probabilistici a grandi quantità di record, mantenendo una struttura compatibile con operazioni SQL come selezioni, filtri, aggregazioni e join. Secondo Michael Leone di Moor Insights & Strategy, la differenza riguarda soprattutto la forma dell’output: anziché ottenere un paragrafo da analizzare ulteriormente, il sistema restituisce un’etichetta e una probabilità che possono essere memorizzate e trattate come normali dati del warehouse.
L’impiego dei modelli decisionali non sostituisce necessariamente SQL o i modelli linguistici generalisti. Le condizioni deterministiche, come il superamento di una soglia numerica o la corrispondenza esatta con una parola, rimangono più convenienti da elaborare attraverso regole SQL tradizionali. Quando invece occorre interpretare il significato di una comunicazione, riconoscere l’intenzione di un cliente, classificare una richiesta o scegliere tra categorie che non possono essere determinate con regole rigide, un modello come Jev può assegnare un’etichetta accompagnata da una misura di confidenza. I casi che richiedono una sintesi discorsiva, un’estrazione aperta o un ragionamento complesso articolato in più passaggi possono essere indirizzati a un modello linguistico di maggiori dimensioni. Pavan Pothukuchi, responsabile della piattaforma AI di Snowflake, descrive quindi pipeline ibride nelle quali SQL svolge il filtraggio deterministico, il modello decisionale gestisce le valutazioni ripetitive su grandi volumi di dati e un LLM interviene soltanto sui record particolarmente complessi.
Le integrazioni annunciate coinvolgono diversi fornitori. Databricks supporta l’utilizzo del progetto open-weight SemIf-OpenJev mediante GPU serverless e chiamate dalla funzione SQL ai_query, oltre ad aver introdotto in versione beta ai_decide, una funzione alimentata da un modello decisionale compatibile con l’interfaccia API di TypeSafe. Snowflake ha avviato la preview privata di Snowflake Decision, accessibile attraverso AI_COMPLETE nelle Cortex AI Functions e operante all’interno del perimetro di sicurezza e governance della piattaforma. Sono inoltre previsti Snowflake Decision Fast, orientato alla riduzione della latenza, e l’accesso ai modelli decisionali attraverso le API REST di Cortex, senza una tempistica pubblica definita. MotherDuck ha integrato la funzione SQL prompt_jev() nei propri piani a pagamento, mentre estensioni dedicate permettono di utilizzare funzioni jev e jev_choice in DuckDB e PostgreSQL. Astronomer ha annunciato l’integrazione di Jev in una futura versione del pacchetto common AI provider di Apache Airflow, consentendo di instradare i workflow sulla base delle risposte del modello e di sospendere le elaborazioni con confidenza insufficiente per sottoporle a revisione umana.
I primi casi applicativi riguardano principalmente l’analisi del sentiment, la classificazione di documenti e ticket di assistenza, l’instradamento degli agenti AI, la corrispondenza tra record provenienti da sistemi differenti e la valutazione di rischi o condizioni operative. Astronomer utilizza un processo produttivo per classificare circa 250.000 titoli professionali secondo profilo e funzione aziendale. In una prova condotta su 4.000 titoli, Jev avrebbe completato il lavoro in 66 secondi con un costo di 16 centesimi di dollaro, contro una stima compresa tra 11 e 21 dollari utilizzando la funzione AI_CLASSIFY ai prezzi di listino. MotherDuck ha comunicato risultati su un insieme di 100.000 notizie distribuite in quattro categorie: Jev avrebbe completato la classificazione in 40 secondi, spendendo 50 centesimi e raggiungendo un’accuratezza dell’89%, mentre un modello OpenAI preso come termine di confronto avrebbe richiesto quasi 32 minuti, con una spesa di 37,58 dollari e un’accuratezza dell’88%. Southbridge AI ha invece utilizzato Jev nella riconciliazione di nominativi di donatori e comitati presenti nei registri di finanziamento elettorale dell’Ohio, combinando il modello con una seconda verifica sui casi incerti e dichiarando una riduzione del 99,56% dei costi di inferenza rispetto a una soluzione basata su un modello di frontiera.
La gestione della confidenza costituisce un requisito centrale per l’impiego operativo. Ogni risposta di Jev è associata a una probabilità utilizzabile per determinare se un record debba essere elaborato automaticamente, verificato da un secondo modello oppure trasferito a un operatore. In Airflow, questa impostazione può essere applicata anche alla diagnosi dei fallimenti di processo: un errore relativo ai permessi può determinare l’interruzione immediata, mentre una condizione temporanea di rete può attivare un tentativo successivo. L’adozione deve tuttavia essere valutata confrontando i modelli decisionali non soltanto con LLM costosi, ma anche con classificatori tradizionali di machine learning e sistemi basati su regole. Accuratezza, soglie di confidenza, manutenzione, costo complessivo e facilità di integrazione rimangono gli elementi necessari per determinare quale tecnologia sia più appropriata per una specifica pipeline.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)