
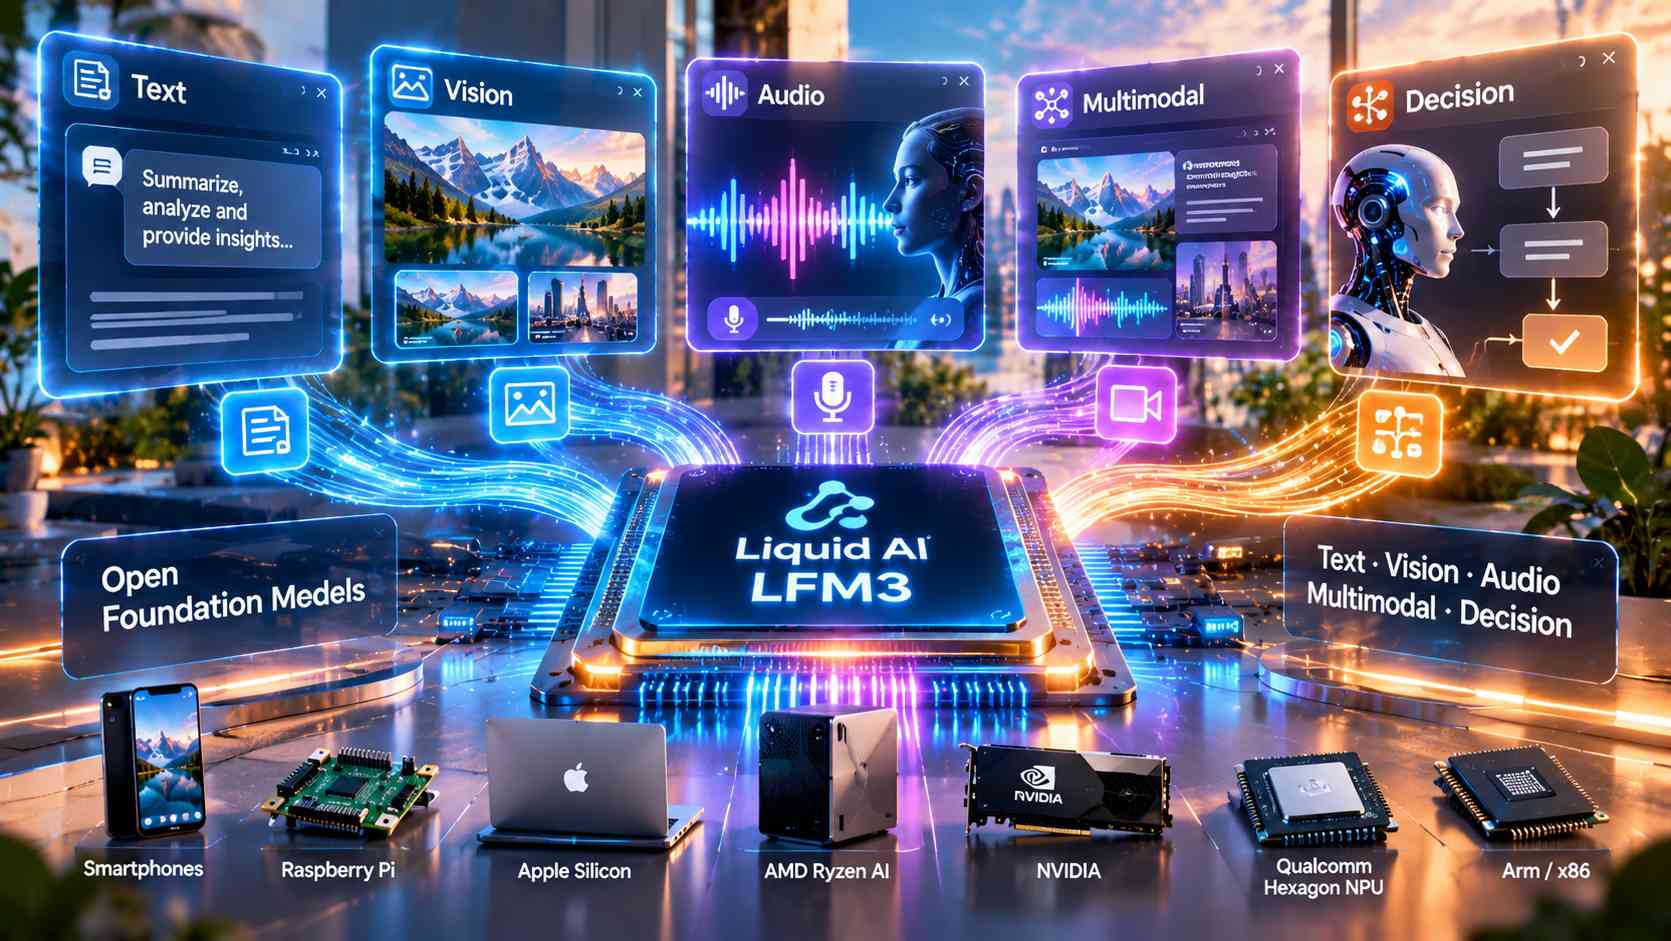
Liquid AI ha annunciato LFM3, una nuova generazione di Liquid Foundation Models a pesi aperti progettata per supportare attività testuali, visive, vocali, multimodali e decisionali attraverso una base architetturale condivisa. La famiglia iniziale comprende sei modelli con dimensioni nell’ordine di due miliardi di parametri, tutti derivati da LFM3-1.7B-Base. LFM3-1.7B è dedicato all’elaborazione testuale, LFM3-VL-2B accetta testo, immagini e video producendo risposte testuali, mentre LFM3-Audio-2B gestisce input vocali e testuali con capacità di generazione di testo e parlato. LFM3-Omni-2B riunisce testo, immagini, video e audio in un unico modello capace di produrre risposte testuali e vocali. La famiglia comprende inoltre d1-2B e d1-omni-2B, due modelli specializzati nella produzione di risposte decisionali calibrate anziché nella normale generazione di testo.
Il modello testuale LFM3-1.7B comprende circa 1,73 miliardi di parametri, una finestra di contesto di 256.000 token, un vocabolario di 128.000 token e il supporto a 16 lingue. L’architettura utilizza 24 livelli che combinano 13 convoluzioni brevi con gating, cinque livelli di attenzione a finestra mobile da 256 token e sei livelli di attenzione globale. Le convoluzioni adottano un kernel di dimensione sette, contro tre nella precedente generazione LFM2. Il nuovo backbone introduce inoltre meccanismi head-wise gated attention, che regolano l’uscita delle singole teste di attenzione e riducono gli effetti delle attivazioni anomale durante la quantizzazione, e partial RoPE, che applica le rotazioni posizionali soltanto a una parte delle componenti nei livelli di attenzione globale. Una configurazione sandwich norm normalizza gli input e gli output dei blocchi, contribuendo alla stabilità dell’elaborazione.
Lo sviluppo dell’architettura è stato condotto attraverso una procedura di ricerca hardware-in-the-loop che valuta le prestazioni direttamente sulle piattaforme di esecuzione previste. Liquid AI ha esteso le prove a 14 combinazioni di dispositivi e backend, includendo smartphone Samsung Galaxy S26 Ultra e OnePlus 15, Raspberry Pi 5, sistemi Apple M4 Max e AMD Ryzen AI, CPU Arm e x86, GPU e unità Qualcomm Hexagon NPU. Il preaddestramento di LFM3-1.7B-Base ha utilizzato 22.000 miliardi di token, con una fase intermedia sugli ultimi 3.500 miliardi caratterizzata da dati selezionati e una maggiore presenza di tracce agentiche e chiamate a strumenti. L’addestramento successivo ha incluso supervised fine-tuning su 1.750 miliardi di token, apprendimento per rinforzo, distillazione da sei modelli specialistici e ulteriori attività di reinforcement learning in ambienti agentici.
Secondo i benchmark pubblicati dalla società, LFM3-1.7B supera il precedente LFM2.5-2.6B pur utilizzando il 35% di parametri in meno, mentre rispetto a LFM2-1.2B raggiunge una velocità superiore di circa il 25% in determinati scenari con 8.000 token di contesto. La variante quantizzata a quattro bit occupa circa 1 GB di memoria. Nel benchmark WebArena-Verified il nuovo modello ottiene un punteggio dichiarato di 38,42 contro 3,02 del predecessore, sebbene la documentazione tecnica sconsigli di utilizzarlo per programmazione agentica complessa e ragionamenti articolati su numerosi passaggi. LFM3-VL-2B supporta per la prima volta nella famiglia Liquid anche input video e raggiunge, secondo le valutazioni aziendali, una media di 71,4 su 62 benchmark visivi, rispetto a 57,6 del precedente LFM2.5-VL-3B, utilizzando circa 1,9 miliardi di parametri contro 3,1 miliardi.
I modelli sono distribuiti attraverso Hugging Face, Liquid AI Playground e Liquid AI API secondo la licenza LFM Open License v1.0. Tra i partner tecnologici indicati al lancio figurano Ambarella, AMD, Arm, Intel attraverso OpenVINO, NVIDIA, OpenRouter, Qualcomm e Vercel, mentre Mercedes-Benz e Shopify hanno partecipato alle attività preliminari di valutazione. La distribuzione a pesi aperti permette di esaminare e implementare i modelli nei limiti stabiliti dalla licenza, senza implicare automaticamente l’assenza di restrizioni commerciali.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).