
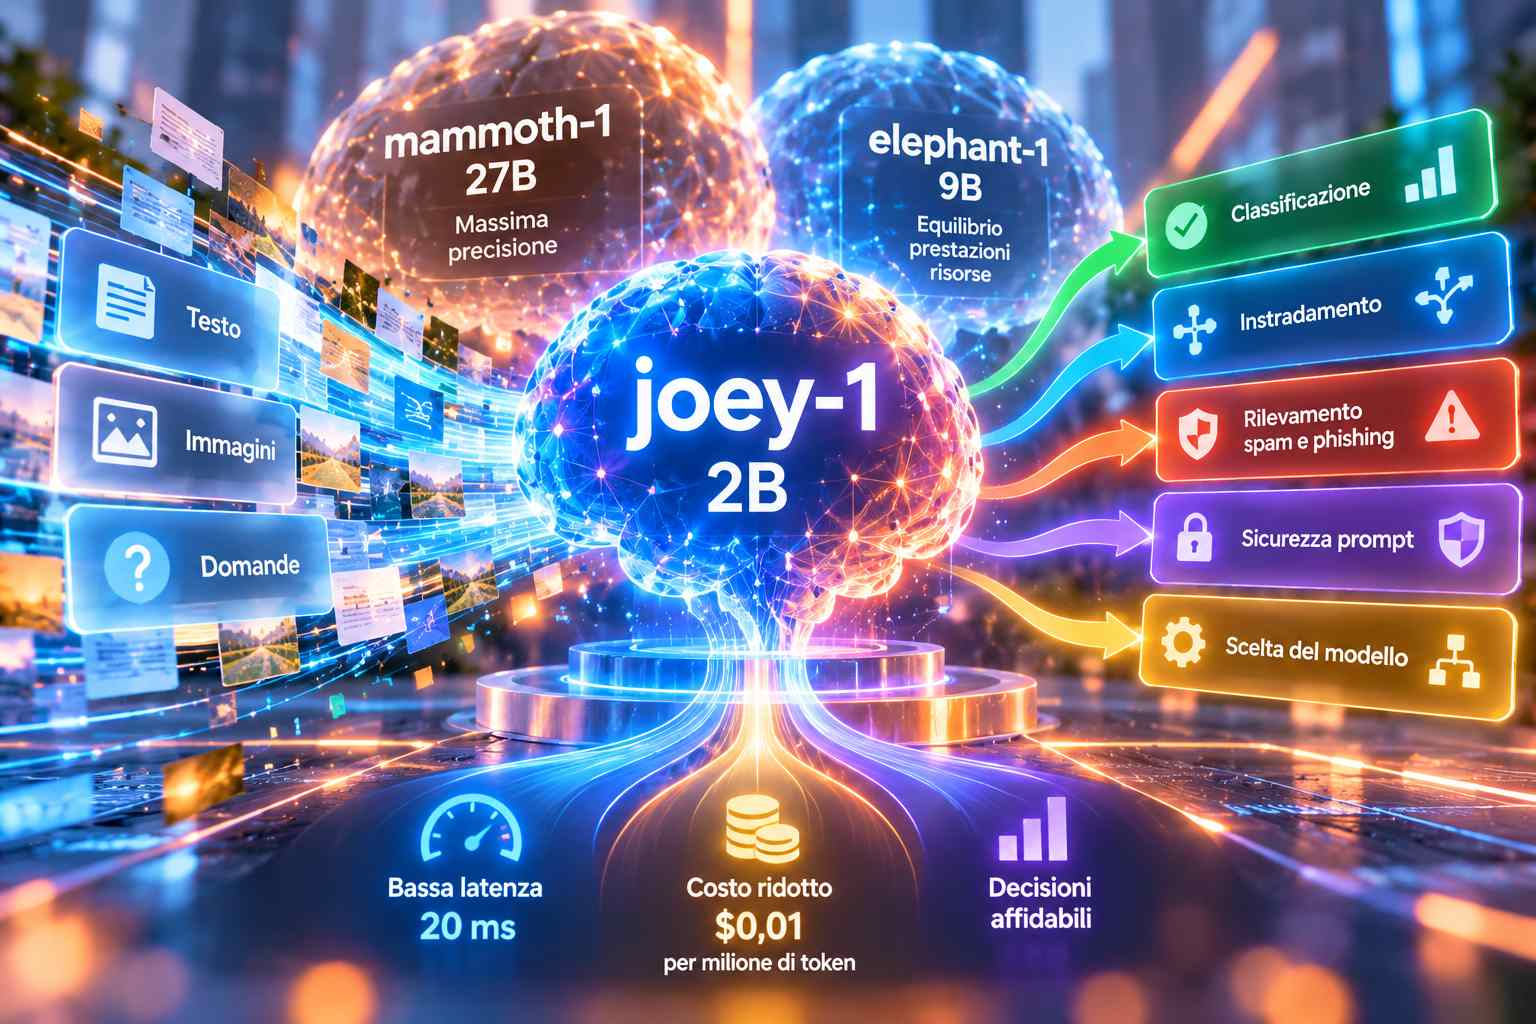
Baseten ha presentato joey-1, un modello di intelligenza artificiale da 2 miliardi di parametri sviluppato dal laboratorio interno Base Labs e progettato per eseguire attività decisionali con costi e tempi di elaborazione contenuti. Il sistema è disponibile attraverso le API di Baseten e mediante il rilascio dei pesi su Hugging Face con licenza MIT. Il prezzo previsto per il servizio API è di 0,01 dollari per milione di token di input, collocando joey-1 come il componente più economico della famiglia di modelli decisionali che comprende mammoth-1 da 27 miliardi di parametri ed elephant-1 da 9 miliardi, presentati il 21 ottobre. I tre modelli condividono l’interfaccia API e la stessa composizione dei dati di addestramento, permettendo agli sviluppatori di passare da una versione all’altra modificando sostanzialmente una sola riga della configurazione. Baseten propone mammoth-1 per applicazioni nelle quali la precisione è prioritaria, elephant-1 come soluzione intermedia tra prestazioni e risorse necessarie e joey-1 per elaborazioni ad alto volume nelle quali la latenza e il costo della singola decisione assumono particolare importanza. In occasione del precedente lancio, la società aveva indicato mammoth-1 come primo classificato tra 208 modelli nel Jev Decision Index ed elephant-1 come modello di riferimento nella categoria da 9 miliardi di parametri.
A differenza dei tradizionali modelli linguistici generativi, joey-1 non è progettato per produrre risposte testuali articolate, ma per valutare alternative e assegnare a ciascuna una probabilità. Il modello riceve uno stato costituito da testo, eventualmente accompagnato da immagini, e una o più domande, restituendo etichette e punteggi di confidenza attraverso un unico passaggio di inferenza, con probabilità normalizzate la cui somma è pari a uno. L’architettura utilizza un’elaborazione condivisa del prefisso di input per gestire più decisioni, riducendo la necessità di elaborazioni ripetute. Sono supportate domande con risposta binaria, scelte tra opzioni denominate e valutazioni su livelli ordinati. Questa impostazione permette di utilizzare il modello per classificare e instradare ticket di assistenza, individuare spam e tentativi di phishing, applicare controlli di sicurezza ai prompt, riconoscere tentativi di jailbreak e selezionare il modello linguistico più appropriato per gestire una richiesta. Baseten prevede anche configurazioni nelle quali joey-1 effettua una prima valutazione e inoltra i casi caratterizzati da maggiore incertezza a elephant-1 o mammoth-1, riservando i modelli più grandi alle decisioni che richiedono ulteriori capacità di elaborazione. La società indica come esempio un sistema che classifica dieci milioni di ticket mensili, ciascuno di circa 500 token: il volume complessivo di cinque miliardi di token avrebbe un costo API di circa 50 dollari con joey-1, rispetto ai circa 500 dollari previsti utilizzando mammoth-1 alle tariffe dichiarate.
Per quanto riguarda le prestazioni, Baseten dichiara una latenza mediana end-to-end, indicata come P50, di 20 millisecondi per richieste di 2.000 token elaborate su infrastruttura di produzione. Il valore viene confrontato con i 49 millisecondi di elephant-1, corrispondenti a un miglioramento di circa 2,5 volte, mentre la società sostiene che joey-1 possa essere fino a cinque volte più rapido rispetto a modelli decisionali comparabili. Nel Jev Decision Index 0.4, sulla suddivisione pubblica del benchmark, il modello ha ottenuto 63,30 punti, classificandosi al trentasettesimo posto su 230 modelli e raggiungendo il risultato più elevato tra quelli con meno di quattro miliardi di parametri. Nella stessa valutazione elephant-1 ha ottenuto 72,24 punti, Cloudflare Clef 61,71, Jev 1.14 60,70 e Perplexity Decider Flash v1.2 60,06. joey-1 presenta risultati inferiori a elephant-1 in tutte le aree considerate, ma supera Jev 1.14 in quattro delle cinque categorie, comprendenti linguaggio, strumenti e automazione, recupero delle informazioni e classificazione, arti e preferenze umane. In una replica interna dell’Artificial Analysis Decision Index realizzata da Base Labs, joey-1 ha registrato 62,9 punti, rispetto ai 65,9 di mammoth-1, 65,2 di elephant-1 e 65 di d1-ultra. Si tratta di risultati ottenuti in ambienti di valutazione differenti, che devono essere mantenuti distinti nelle comparazioni.
Dal punto di vista dell’addestramento, joey-1 deriva da Qwen3.5-2B ed è stato sottoposto a un fine-tuning completo utilizzando Baseten Training Jobs. Il procedimento ha impiegato una miscela di 6,21 milioni di esempi decisionali denominata Mix 8, composta per il 58,3% da capacità decisionali fondamentali, per il 16,1% da sicurezza e astensione, per un ulteriore 16,1% da valutazioni e domini specialistici e per il 9,5% da dati decisionali pubblici. L’addestramento comprende testo e immagini, con l’encoder visivo mantenuto congelato, una maschera di attenzione block-bidirectional nei livelli full-attention e una lunghezza massima delle sequenze pari a 16.384 token. La funzione obiettivo combina cross-entropy e un termine di calibrazione Brier con coefficiente lambda uguale a uno, includendo anche una risposta esplicita di incertezza, equivalente a «non lo so», per le situazioni nelle quali il modello non dispone di elementi sufficienti per scegliere con affidabilità. Il processo ha richiesto un’epoca di 43.390 passaggi, con learning rate massimo di 1e-5, ottimizzatore AdamW, coefficienti beta di 0,9 e 0,95, assenza di weight decay, warm-up del 3%, decadimento coseno e precisione bf16. L’infrastruttura utilizzata comprendeva due nodi con otto GPU NVIDIA H100 ciascuno, per un totale di sedici acceleratori.
joey-1 è accessibile attraverso l’endpoint /v1/systemone delle Baseten Model APIs, utilizzando l’identificativo decision-models/baseten-joey-2b-latest. Il servizio prevede per impostazione predefinita la conservazione nulla dei dati delle richieste e una tariffa di 0,01 dollari per milione di token in ingresso, mentre input memorizzati nella cache e output risultano indicati a costo zero. Per confronto, le tariffe pubblicate per elephant-1 e mammoth-1 sono rispettivamente di 0,035 e 0,10 dollari per milione di token. Le API condivise della famiglia supportano una finestra contestuale di 16.000 token e sono ottimizzate per ridurre la latenza; le installazioni dedicate permettono invece di utilizzare una finestra fino a 262.000 token, integrare pesi personalizzati e applicare ottimizzazioni specifiche dell’infrastruttura, anche attraverso la collocazione dei servizi decisionali in prossimità dei modelli linguistici ai quali sono collegati. joey-1 ed elephant-1 sono disponibili anche per ulteriori procedure di post-training, con un’apposita guida di fine-tuning pubblicata su GitHub. Per l’esecuzione autonoma dei pesi distribuiti sotto licenza MIT è prevista una configurazione basata su runtime di serving e OneJev con patch dedicata, utilizzabile con una GPU CUDA. La documentazione specifica che le richieste superiori ai limiti di lunghezza effettivamente supportati dall’addestramento vengono rifiutate anziché troncate automaticamente.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).