
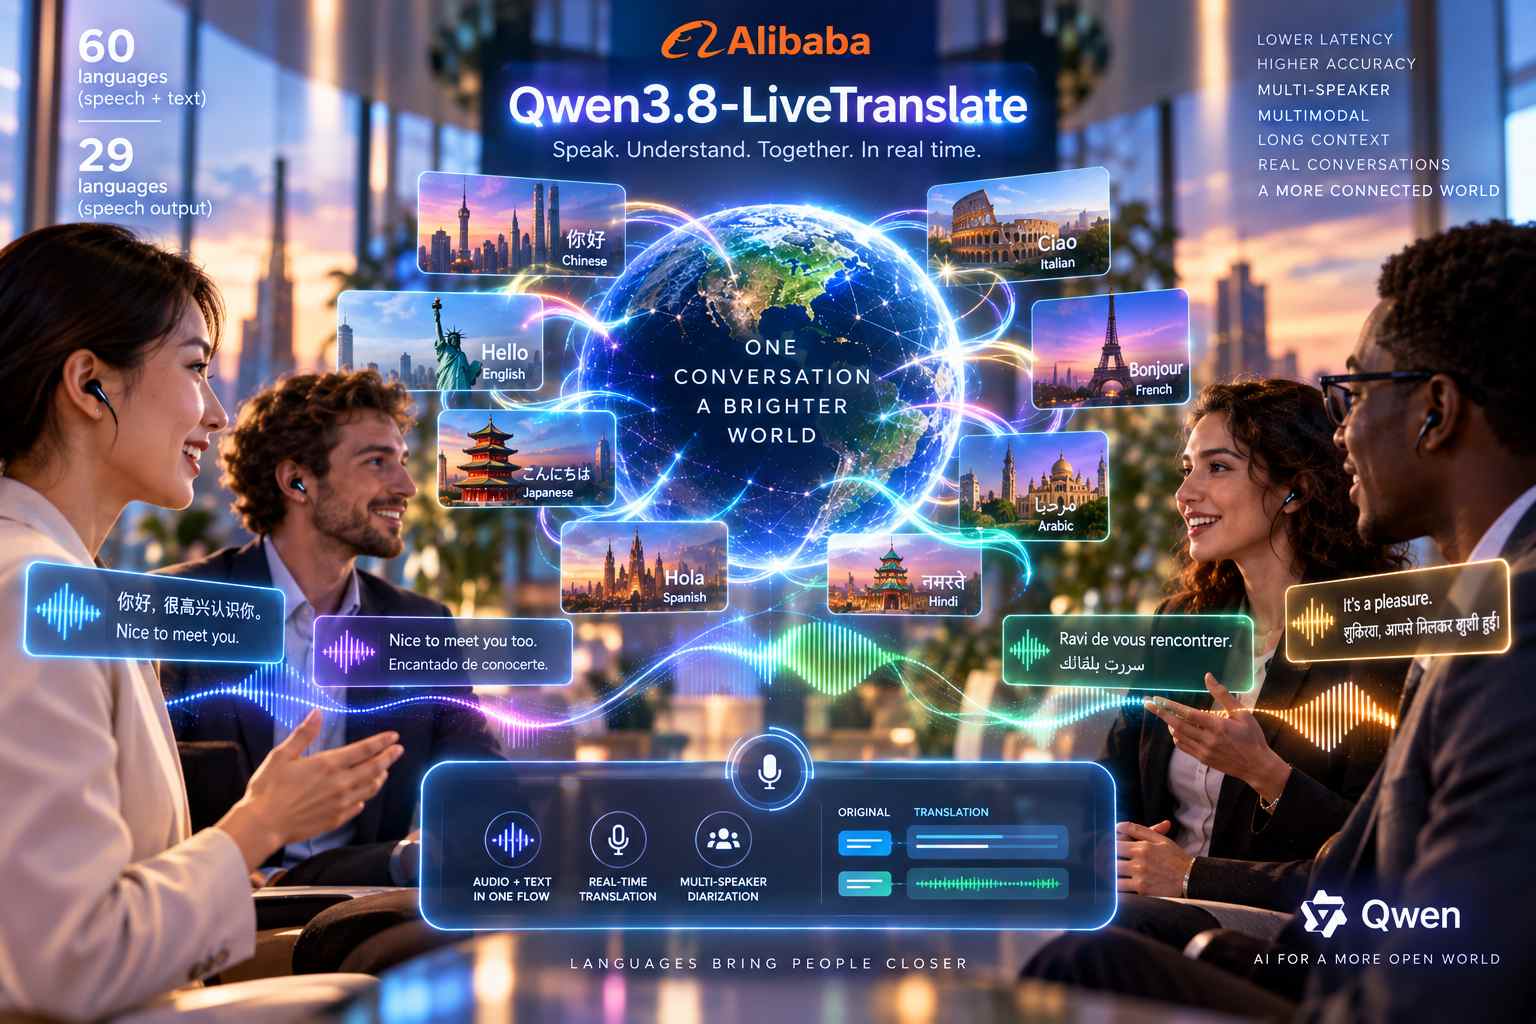
Alibaba ha presentato Qwen3.8-LiveTranslate, un nuovo modello di traduzione e interpretazione in tempo reale progettato per elaborare contemporaneamente audio e testo e ridurre il ritardo tipico dei sistemi di traduzione simultanea. Il modello non attende che l’interlocutore abbia concluso una frase o un intero intervento prima di iniziare la traduzione, ma genera progressivamente testo e voce tradotti mentre riceve l’audio originale. Il risultato è una riduzione della latenza media LAAL, Length-Adaptive Average Lagging, da 2,8 a 2,3 secondi, equivalente a un miglioramento di circa il 18% rispetto alla generazione precedente. Il sistema supporta l’ingresso vocale e la traduzione testuale per 60 lingue, mentre 29 lingue, tra cui inglese, cinese, coreano, giapponese, tedesco, francese, spagnolo, arabo e hindi, possono essere utilizzate anche per produrre direttamente l’output vocale tradotto. Una delle caratteristiche principali è l’eliminazione della tradizionale pipeline separata nella quale l’audio viene prima convertito in testo attraverso un sistema di riconoscimento vocale e soltanto successivamente tradotto: Qwen3.8-LiveTranslate gestisce invece l’intero processo all’interno di un flusso integrato.
La base tecnica del modello è un’architettura denominata Interleave, progettata per combinare audio e testo all’interno di un unico flusso temporale. I dati vocali ricevuti e le traduzioni progressivamente generate vengono conservati e riutilizzati durante l’elaborazione successiva, consentendo al sistema di utilizzare in maniera continuativa il contesto già acquisito e di migliorare fedeltà, fluidità e sintesi della traduzione. A questa struttura si aggiunge la funzione di long-context disambiguation, che permette al modello di recuperare informazioni emerse nelle fasi precedenti della conversazione per ridurre errori nella traduzione di nomi propri, termini specialistici e altre espressioni ambigue. Un nome o un termine tecnico introdotto all’inizio di una riunione può quindi essere interpretato e tradotto nello stesso modo anche molto più avanti nella conversazione, mantenendo maggiore coerenza terminologica durante sessioni prolungate.
Qwen3.8-LiveTranslate è stato inoltre progettato per gestire conversazioni con più interlocutori. La funzione di speaker diarization permette al modello di distinguere i diversi parlanti e di indicare chi ha pronunciato ciascun contenuto, mantenendo questa separazione anche durante la produzione della traduzione. Nel caso dell’output vocale, il sistema cerca inoltre di conservare in maniera stabile le caratteristiche timbriche dei diversi interlocutori, evitando che le voci tradotte risultino indistinguibili tra loro. È disponibile anche una modalità di output bilingue sincronizzato che mostra contemporaneamente sullo schermo il testo originale e quello tradotto, permettendo di seguire immediatamente l’interpretazione e confrontarla con il contenuto di partenza. Il modello può utilizzare anche informazioni visive provenienti da un flusso video: movimenti delle labbra, gesti e testo presente nelle immagini possono diventare elementi aggiuntivi del contesto utilizzato durante il processo di traduzione.
L’architettura interna è organizzata secondo una struttura composta da due moduli denominati Thinker e Talker. Il Thinker riceve video, audio, testo originale e traduzione e li organizza cronologicamente all’interno di un’unica sequenza causale, in modo che ogni nuova elaborazione possa tenere conto delle informazioni multimodali già disponibili. Il Talker utilizza invece il segnale vocale originale e il risultato della traduzione per generare la voce tradotta, cercando di preservare il timbro dell’interlocutore. La separazione tra i due componenti permette quindi di affidare a una parte del sistema la comprensione multimodale e la gestione del contesto e all’altra la produzione dell’output vocale, pur mantenendo le due fasi all’interno di un processo coordinato e in tempo reale.
Per la valutazione delle prestazioni Alibaba ha utilizzato anche FLEURS, dataset pubblico per il riconoscimento e l’elaborazione vocale multilingue, effettuando test su 70 lingue. L’azienda riferisce che Qwen3.8-LiveTranslate ha superato sia la generazione precedente sia importanti sistemi concorrenti di interpretazione in tempo reale nei parametri considerati, che comprendono qualità della traduzione, latenza, precisione del riconoscimento vocale e qualità della sintesi vocale. Il modello è già disponibile per gli sviluppatori attraverso Model Studio di Alibaba Cloud e Qwen Cloud, che consentono di integrare le funzionalità di traduzione simultanea nelle applicazioni tramite API basate su WebSocket.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)