
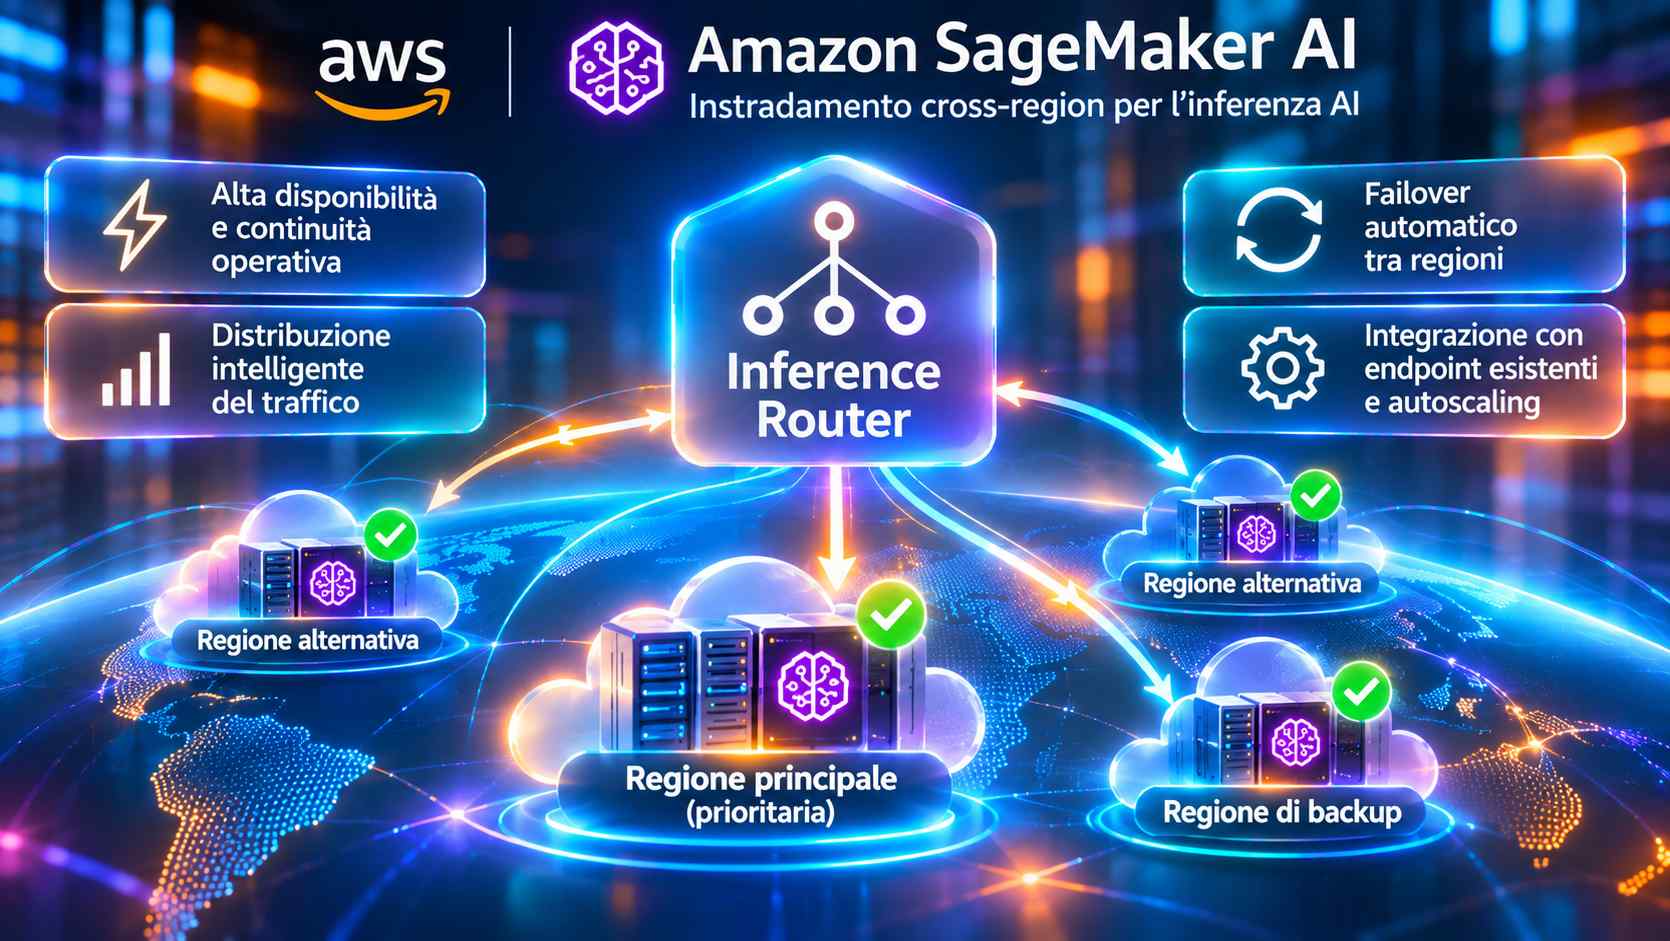
Amazon Web Services ha annunciato la disponibilità generale del servizio di instradamento cross-region per Amazon SageMaker AI, progettato per garantire una maggiore continuità operativa delle infrastrutture dedicate all’inferenza dei modelli di intelligenza artificiale. La nuova funzionalità permette alle applicazioni di utilizzare un unico punto di accesso attraverso il quale distribuire le richieste verso endpoint e componenti di inferenza presenti in differenti regioni geografiche e account AWS. Il sistema interviene quando le risorse locali non sono in grado di gestire adeguatamente il traffico, ad esempio in presenza di indisponibilità temporanee delle istanze GPU necessarie alle procedure di autoscaling. L’infrastruttura non provvede direttamente alla distribuzione dei modelli o alla creazione di nuove risorse computazionali, ma utilizza endpoint precedentemente attivati e configurati dagli operatori.
L’architettura introduce una risorsa regionale denominata Inference Router, all’interno della quale vengono definite destinazioni logiche, identificate come routing target, associate ai modelli utilizzati dalle applicazioni. Ciascuna destinazione logica può comprendere più endpoint di inferenza in tempo reale e inference component distribuiti tra differenti regioni o account, oppure una configurazione dedicata esclusivamente agli endpoint asincroni. Le risorse continuano a utilizzare le configurazioni, i container, i modelli e le procedure di autoscaling già definiti attraverso SageMaker AI, mantenendo anche la possibilità di ricevere direttamente richieste mediante InvokeEndpoint. L’instradamento attraverso il nuovo servizio attribuisce inizialmente priorità alle risorse disponibili nella stessa regione del router, distribuendo uniformemente il traffico quando sono presenti più destinazioni locali funzionanti.
Il sistema valuta continuamente lo stato operativo degli endpoint attraverso indicatori derivati dalle richieste recentemente elaborate, considerando errori del server, limitazioni dovute al sovraccarico e timeout. Le anomalie imputabili alla piattaforma determinano una maggiore riduzione dell’indice di affidabilità, mentre gli errori causati da input non validi non concorrono alla sua determinazione. La latenza di elaborazione del modello non viene invece utilizzata come criterio diretto per l’attivazione del failover. Gli stati healthy, overloaded e degraded vengono pubblicati attraverso Amazon CloudWatch e determinano la progressiva redistribuzione del traffico. In presenza di errori persistenti, il trasferimento delle nuove richieste può iniziare entro circa un minuto, mentre il ripristino del traffico verso la regione originaria avviene gradualmente. Le soglie, i tempi di intervento e la ponderazione delle destinazioni vengono gestiti automaticamente da SageMaker AI.
Per le richieste di inferenza in tempo reale, il router può effettuare un secondo tentativo presso una destinazione alternativa esclusivamente quando il modello non è stato eseguito, ad esempio in presenza di limitazioni del traffico, indisponibilità del modello o errori HTTP 503. Non vengono invece ripetute automaticamente operazioni terminate con timeout, errori HTTP 500 o errori del modello. Le richieste asincrone possono essere sottoposte a tutte le destinazioni compatibili, iniziando da quelle locali, fino all’accettazione dell’elaborazione. Le risposte in tempo reale comprendono inoltre l’identificativo ARN della risorsa utilizzata e un’indicazione del criterio che ha determinato la scelta della destinazione.
Gli amministratori possono configurare limiti al traffico proveniente da altre regioni, stabilendo la percentuale di capacità computazionale destinabile alle richieste esterne. In una configurazione composta da quattro istanze, ciascuna in grado di elaborare cinquanta richieste al secondo, un limite del 20% permette di accettare quaranta richieste interregionali al secondo. L’incremento del numero di istanze modifica automaticamente tale capacità. Le operazioni tra account differenti richiedono inoltre specifiche autorizzazioni da entrambe le parti.
Il servizio supporta fino a venti routing target per router e dieci destinazioni per ciascun target, con payload fino a 6 MB per le richieste in tempo reale. Non supporta attualmente lo streaming delle risposte ed è disponibile nella maggior parte delle regioni AWS commerciali, a eccezione di me-south-1 e me-central-1. L’utilizzo del router non comporta costi aggiuntivi di instradamento, mentre rimangono applicabili le tariffe delle risorse di inferenza e dei servizi di monitoraggio CloudWatch.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)