
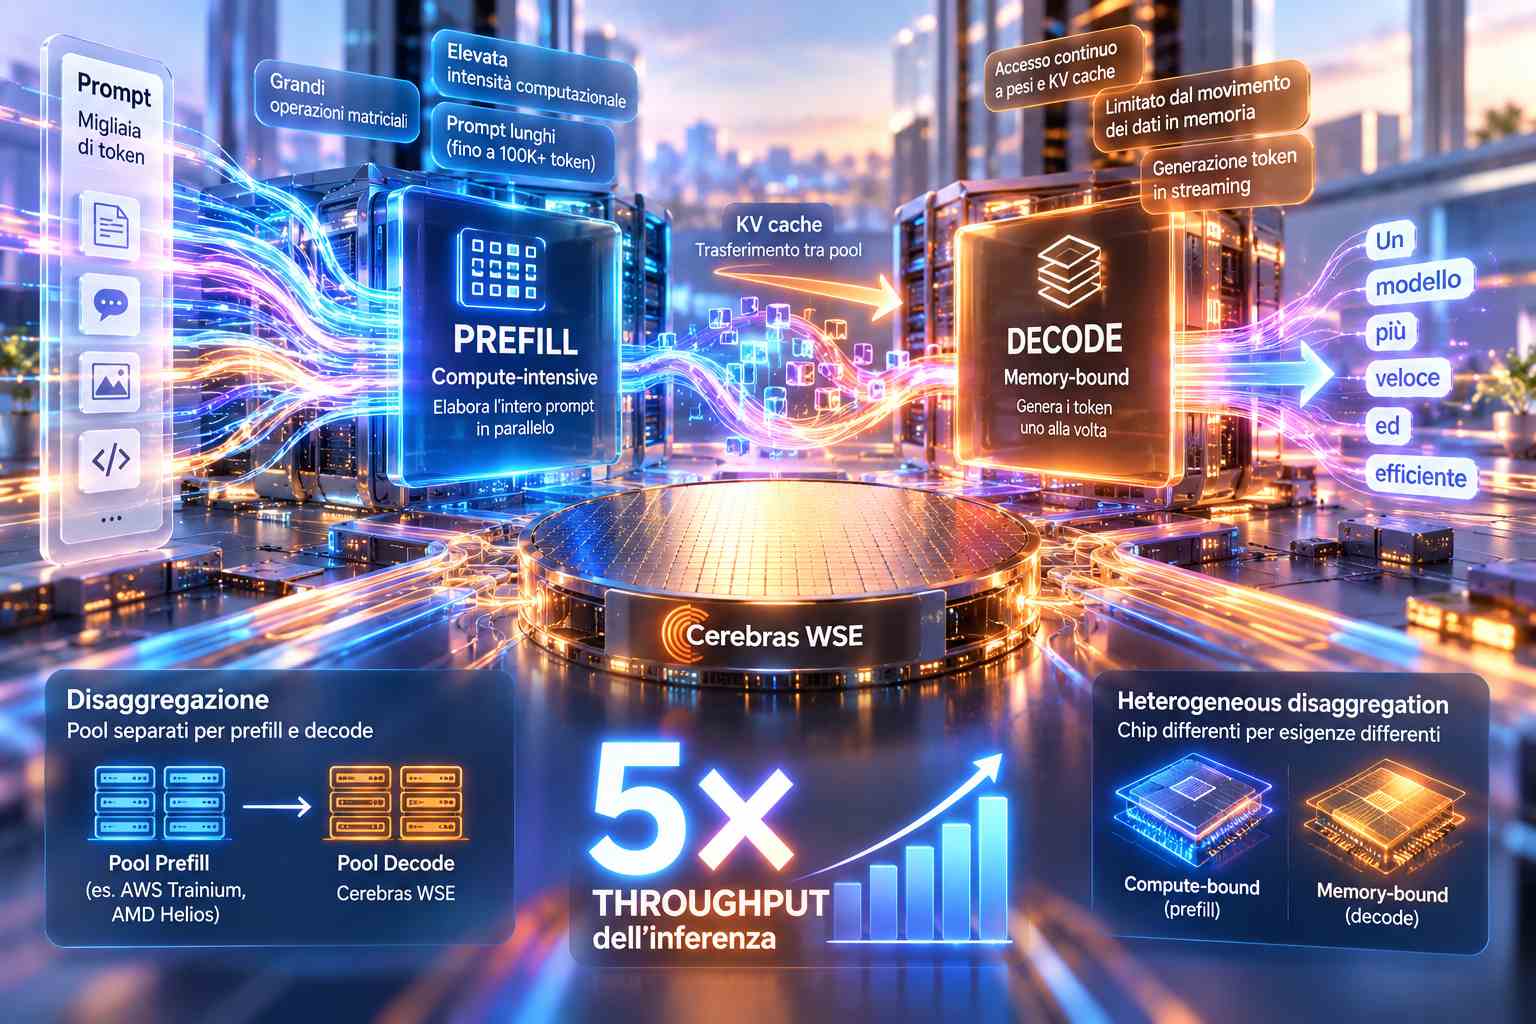
Cerebras Systems ha riportato un aumento fino a 5 volte del throughput dell’inferenza utilizzando una tecnica di disaggregazione che separa le due principali fasi di esecuzione di un modello linguistico, prefill e decode, mantenendo invariato il numero di sistemi Cerebras e senza ridurre la velocità di generazione dei token. Le due fasi hanno infatti esigenze hardware differenti: durante il prefill il modello elabora in parallelo l’intero prompt, che può contenere migliaia o anche centinaia di migliaia di token, effettuando grandi operazioni matriciali caratterizzate da un’elevata intensità computazionale; durante il decode, invece, i token vengono generati uno alla volta e il sistema deve accedere continuamente ai pesi del modello e alla KV cache, che conserva le chiavi e i valori calcolati per i token precedenti. In questa seconda fase il limite tende quindi a essere il movimento dei dati in memoria più che la capacità aritmetica pura. Cerebras descrive questo comportamento attraverso il concetto di arithmetic intensity, cioè il rapporto tra operazioni floating point eseguite e byte trasferiti tra memoria e unità di calcolo: mentre nella moltiplicazione di matrici questo rapporto può crescere con la dimensione dell’operazione, durante il decode il trasferimento dei pesi rimane elevato anche quando il lavoro computazionale per singolo token diminuisce.
Nei sistemi di inferenza tradizionali, prefill e decode condividono lo stesso hardware e questo crea un compromesso tra tempo necessario per produrre il primo token, fluidità della generazione già in corso e throughput complessivo. Un prefill particolarmente pesante può rallentare le richieste che stanno già generando token, mentre l’aumento del batching consente di condividere più efficacemente il caricamento dei pesi tra richieste concorrenti ma può allungare la durata di ogni singolo passo di decode. La disaggregazione divide invece le due fasi in pool hardware separati, permettendo di dimensionare, programmare e scalare in modo indipendente le risorse destinate al prefill e quelle dedicate al decode. Un servizio orientato a ridurre il time-to-first-token può quindi assegnare maggiore capacità al primo pool, mentre un sistema che privilegia la continuità dello streaming può destinare più risorse alla fase di generazione. La separazione introduce però un nuovo costo: al termine del prefill, la KV cache specifica della richiesta deve essere trasferita al pool di decode e caricata nella sua memoria, aggiungendo traffico di rete, coordinamento e potenziale latenza; inoltre, uno dei due pool può rimanere sottoutilizzato se la capacità non è correttamente bilanciata rispetto al carico.
Cerebras sta sviluppando in particolare un approccio di heterogeneous disaggregation, nel quale chip differenti vengono utilizzati per le parti dell’inferenza che risultano maggiormente compute-bound o memory-bound. L’architettura wafer-scale dell’azienda distribuisce SRAM e unità di calcolo sull’intero wafer, mentre le GPU tradizionali trasferiscono i dati del modello dalla memoria HBM verso memorie e cache interne più piccole. In un confronto basato sui valori di picco pubblicati al 10 settembre 2026, il WSE-3 di Cerebras viene indicato con 21.000 TB/s di banda aggregata della SRAM on-chip per wafer, contro 150 TB/s di un acceleratore SRAM non identificato e 23,3 e 22 TB/s per sistemi GPU basati su HBM4; si tratta tuttavia di livelli di memoria differenti e i valori non costituiscono direttamente una misura della velocità di generazione dei token. Nello stesso contesto vengono riportati dati di Artificial Analysis relativi a GPT-oss-120B in modalità high reasoning con 10.000 token di input: Cerebras raggiunge 1.669 token di output al secondo, davanti a SambaNova con 708, Groq con 475, Microsoft Azure con 319, Nebius con 294 e Baseten con 293.
Nei primi test della nuova architettura, Cerebras ha utilizzato acceleratori di partner per gestire il prompt processing e ha mantenuto i propri WSE dedicati alla fase di decode, ottenendo così un incremento di capacità di circa 5 volte senza aumentare il numero di sistemi Cerebras impiegati. Tra le opzioni hardware indicate per il prefill compaiono AWS Trainium e sistemi AMD Helios basati su GPU Instinct, che possono alimentare un pool di decode Cerebras. L’azienda considera particolarmente adatte a questa architettura le applicazioni agentiche, nelle quali le interazioni sono spesso lunghe e multi-turno, il contesto cresce progressivamente tra una chiamata al modello e la successiva e le latenze introdotte in ogni fase finiscono per sommarsi. Cerebras prevede di approfondire successivamente sia lo stack hardware e software necessario alla disaggregazione sia i compromessi economici legati alla sua implementazione su larga scala.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)