
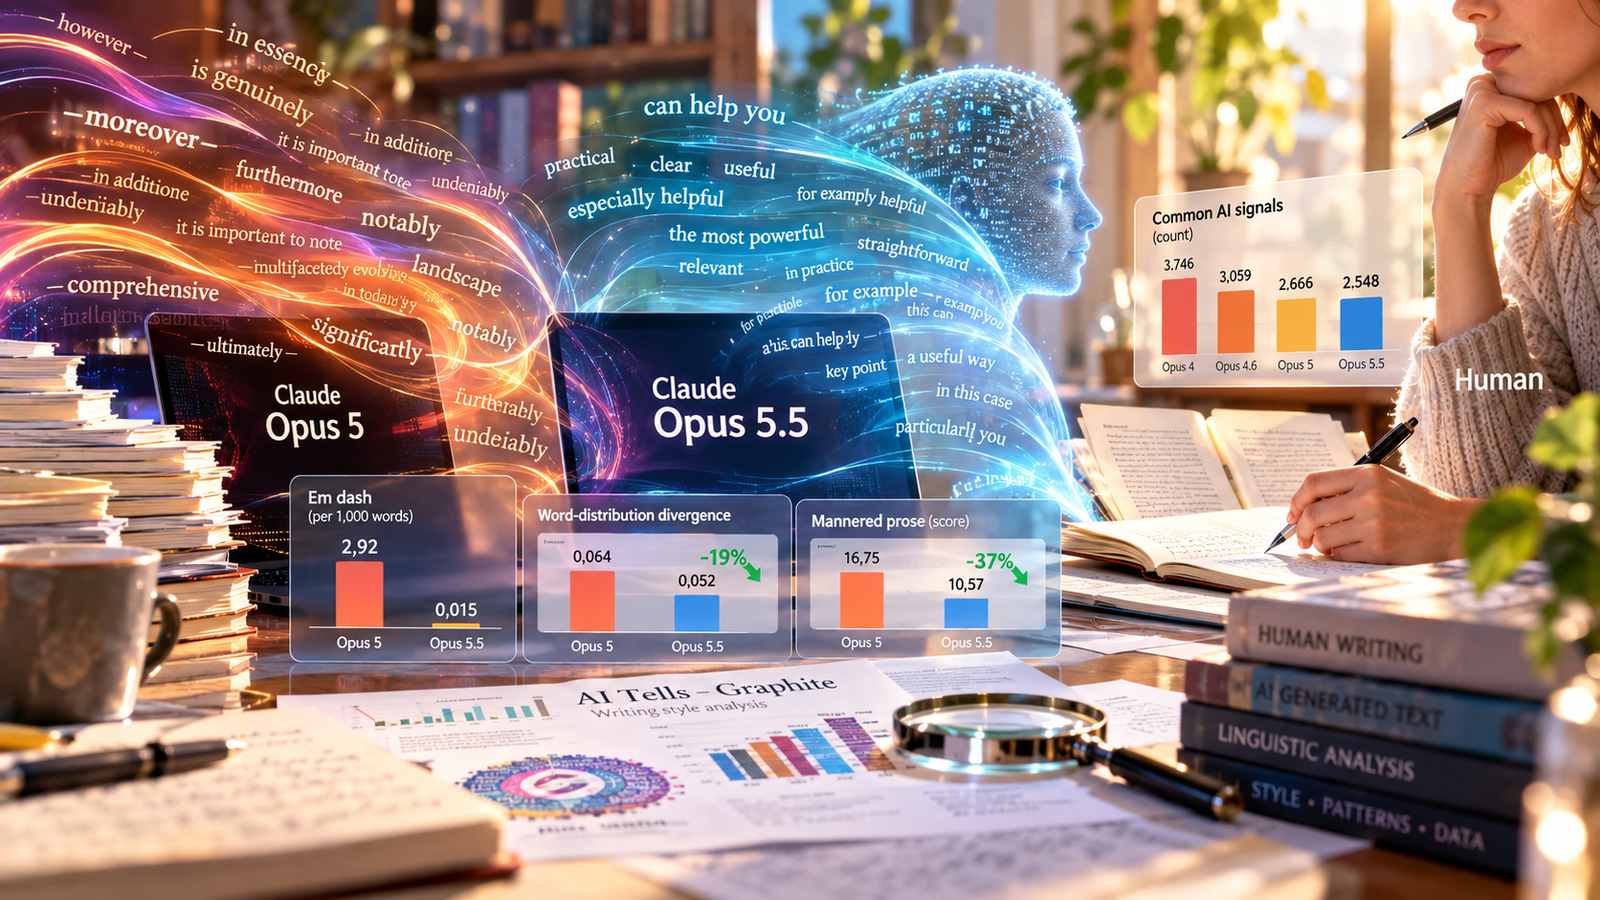
Claude Opus 5.5 produce testi complessivamente più vicini alla scrittura umana rispetto a Claude Opus 5, ma continua a mostrare migliaia di caratteristiche linguistiche statisticamente riconoscibili. È quanto emerge dall’aggiornamento dello studio AI Tells realizzato dall’agenzia Graphite, che ha confrontato articoli generati da dieci modelli linguistici con testi scritti da persone su 9.974 argomenti corrispondenti. La principale misura utilizzata è la word-distribution divergence, cioè la distanza complessiva tra la distribuzione delle parole prodotte dal modello e quella osservata nei testi umani: Opus 5.5 ottiene un valore di 0,052 contro 0,064 di Opus 5, con una riduzione del 19%. Il dato indica quindi una maggiore somiglianza statistica nella scelta delle parole, senza però dimostrare che un singolo testo sia indistinguibile da uno scritto da una persona o che sia necessariamente migliore sotto il profilo della qualità, dell’accuratezza o dell’originalità. Nello stesso confronto GPT-6 Astra registra invece una divergenza di 0,109, superiore allo 0,101 misurato per GPT-5.6 Sol.
Uno dei cambiamenti più evidenti riguarda l’em dash, il trattino lungo diventato negli ultimi anni uno dei segni più frequentemente associati alla scrittura generata dai modelli linguistici. Nei testi prodotti da Opus 5.5 Graphite ne rileva appena 0,015 ogni 1.000 parole, contro 2,92 in Opus 5, con una diminuzione di circa il 99%. Il nuovo modello ne utilizza così molti meno persino rispetto agli autori umani presenti nel campione. È diminuita anche quella che Anthropic definisce “mannered prose”, cioè una prosa caratterizzata da formulazioni elaborate, metafore o abbellimenti al posto di espressioni più dirette: il punteggio passa da 16,75 in Opus 5 a 10,57 in Opus 5.5, con una riduzione del 37%, pur rimanendo superiore al 6,65 dei testi umani e al 7,91 di GPT-6 Astra. In questo caso la valutazione non deriva però da un semplice conteggio automatico, perché Graphite utilizza Claude Opus 5 per giudicare lo stile su un sottoinsieme di 1.000 argomenti, introducendo quindi anche una componente di valutazione effettuata da un altro modello.
La scomparsa di alcuni segnali molto riconoscibili non significa tuttavia che Claude abbia perso le proprie abitudini linguistiche. Graphite ha individuato in Opus 5.5 ben 2.548 parole, brevi espressioni o strutture ricorrenti utilizzate almeno il doppio rispetto ai testi umani, contro 2.666 in Opus 5, 3.059 in Opus 4.6 e 3.746 in Opus 4. Alcune formule diminuiscono mentre altre diventano più frequenti: rispetto al predecessore, Opus 5.5 utilizza “can help you” otto volte più spesso e “is especially helpful” dodici volte più spesso, mentre Opus 5 ricorreva a “is genuinely” con una frequenza 26 volte superiore. Emergono differenze anche tra famiglie di modelli: Opus 5.5 usa “the most powerful” 24 volte più spesso di GPT-6 Astra, mentre Astra impiega “not necessarily” 17 volte più frequentemente rispetto a Opus 5.5. Secondo i ricercatori, Claude tende quindi maggiormente ai superlativi, mentre Astra mostra una maggiore propensione a qualificare e limitare le affermazioni. Considerando separatamente undici caratteristiche di scrittura già note e spesso associate all’AI, la loro capacità complessiva di distinguere Opus 5.5 dai testi umani diminuisce del 6% rispetto a Opus 5 e del 53% rispetto a Opus 4.
La metodologia di Graphite parte da 10.000 articoli web pubblicati prima del lancio di ChatGPT nel novembre 2022. GPT-4.1 viene utilizzato per sintetizzare ciascun testo e i vari modelli ricevono poi lo stesso riassunto con la richiesta di produrre un articolo di lunghezza simile all’originale, senza istruzioni specifiche per imitare lo stile umano o eliminare i segnali tipici dell’AI. Con l’aggiunta di Opus 5.5, il campione comune utilizzabile è sceso a 9.974 argomenti. Lo studio evidenzia inoltre una possibile differenza più strutturale nella lunghezza delle frasi: gli autori umani tendono ad alternare maggiormente periodi molto brevi e molto lunghi, mentre i modelli producono frasi mediamente più uniformi. Questo aspetto dovrà però essere verificato con test specifici, così come resta da valutare quanto prompt differenti o una revisione umana possano modificare i risultati. Tra i limiti riconosciuti ci sono anche la diversa epoca di produzione dei testi, perché il campione umano precede il 2022 mentre quello artificiale è attuale, e il possibile bias introdotto dall’utilizzo di un modello per valutare alcune caratteristiche stilistiche. Graphite ha reso disponibili sia i testi sia i segnali identificati per consentire ulteriori analisi e prevede di continuare a confrontare le nuove generazioni di modelli man mano che vengono pubblicate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)