
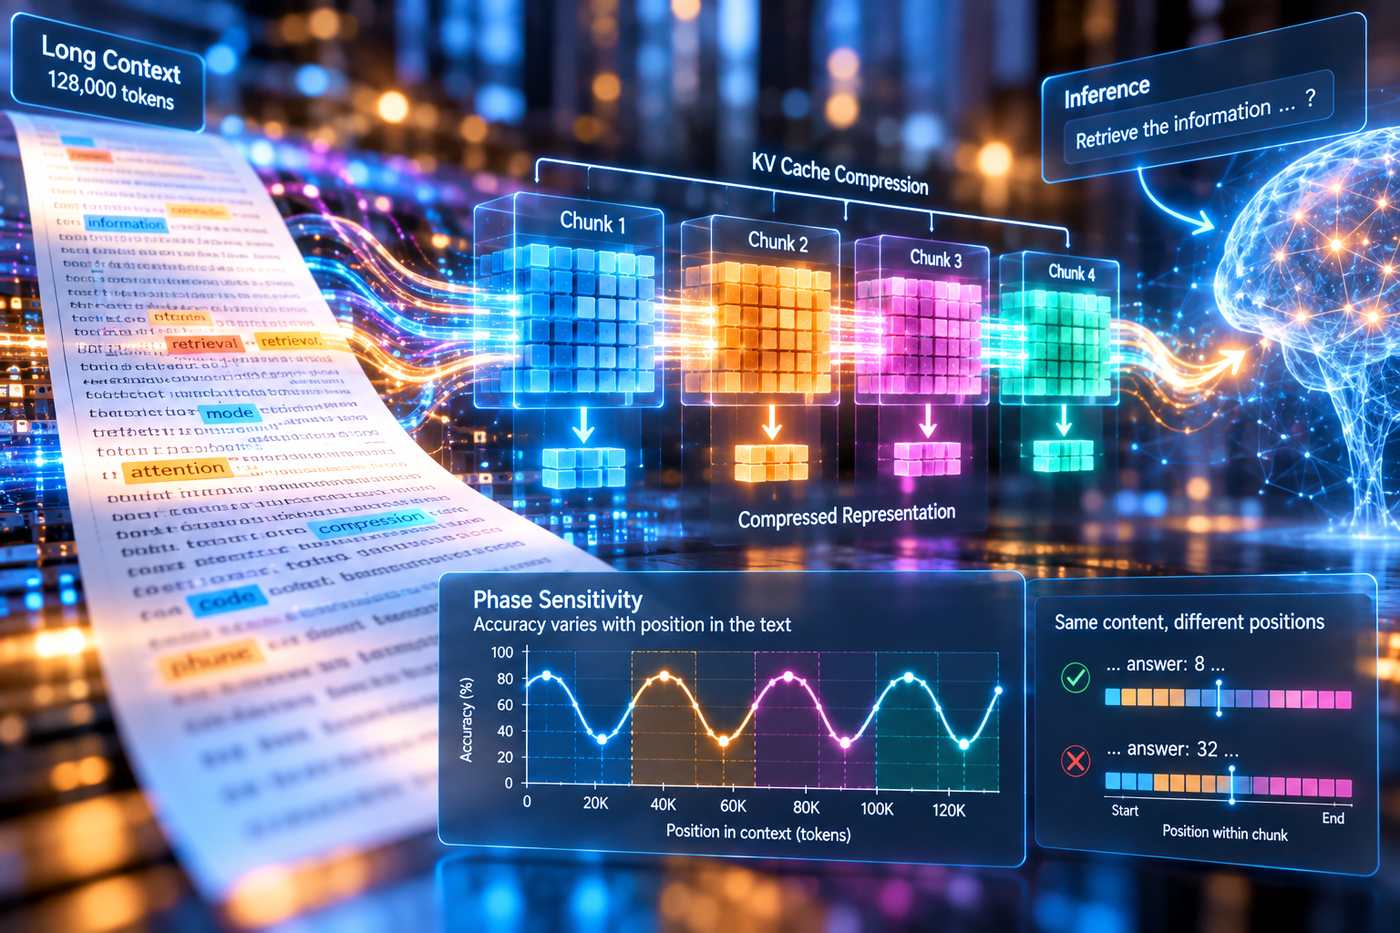
Una ricerca condotta da studiosi di ByteDance, Princeton University, Stanford University e University of California, Berkeley ha individuato una vulnerabilità prestazionale nei sistemi di compressione della memoria utilizzati dai modelli linguistici per elaborare contesti particolarmente lunghi. Il fenomeno, denominato phase sensitivity o sensibilità di fase, riguarda la variazione periodica dell’accuratezza con cui il modello recupera un’informazione in funzione della sua posizione all’interno del testo. Gli esperimenti hanno coinvolto modelli della famiglia DeepSeek V4 e V4.1, oltre ad altri sistemi sviluppati appositamente dai ricercatori, evidenziando che alcune tecniche di compressione della KV cache possono determinare differenze significative nella capacità di recuperare contenuti anche quando il testo e la domanda rimangono invariati. La ricerca, intitolata Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression, descrive il problema attraverso prove controllate di recupero delle informazioni e completamento del codice, concentrandosi sugli effetti delle strategie adottate per ridurre il consumo di memoria durante l’inferenza.
La KV cache costituisce la struttura utilizzata dai modelli Transformer per conservare le rappresentazioni key e value generate durante l’elaborazione dei token precedenti, evitando di ricalcolare ripetutamente una parte delle informazioni necessarie al meccanismo di attenzione. All’aumentare della lunghezza del contesto, la quantità di memoria richiesta dalla cache può diventare significativa, incidendo sui costi computazionali e sulla capacità di gestire sequenze molto estese. Per contenere queste risorse, alcune architetture utilizzano una compressione organizzata in blocchi, o chunk, nella quale gruppi consecutivi di token vengono rappresentati mediante un numero inferiore di elementi memorizzati. La riduzione permette di utilizzare meno memoria, ma richiede che il modello conservi all’interno delle rappresentazioni compresse le informazioni potenzialmente necessarie alle interrogazioni successive. Poiché il sistema non conosce anticipatamente quali dettagli verranno richiesti, la qualità della compressione diventa determinante per il recupero corretto dei contenuti.
Il fenomeno individuato dai ricercatori emerge quando un’informazione viene spostata all’interno di blocchi di compressione differenti, oppure collocata in posizioni diverse rispetto ai confini che separano un chunk dal successivo. A parità di contenuto complessivo, la posizione può modificare il modo in cui i dati vengono rappresentati e conservati, producendo variazioni periodiche nelle risposte del modello. In uno degli esperimenti, DeepSeek V4 Flash Base è stato sottoposto a una prova di previsione del token successivo modificando la lunghezza di una docstring, ossia una stringa utilizzata per documentare il funzionamento di un componente software. Il modello ha alternato periodicamente la risposta corretta, corrispondente al valore 8, e quella errata, corrispondente al valore 32. La periodicità delle variazioni coincideva con gli intervalli utilizzati per la compressione, collegando il comportamento osservato alla struttura interna della gestione della memoria.
Le prove di recupero delle informazioni sono state condotte utilizzando contesti lunghi 128.000 token, nei quali i ricercatori hanno collocato dati specifici in posizioni differenti, misurando successivamente la capacità del modello di recuperarli. Nelle versioni di base della famiglia DeepSeek V4, le differenze di accuratezza hanno raggiunto 40,2 punti percentuali per DeepSeek V4 Flash Base e 34,8 punti per DeepSeek V4 Pro Base. Le versioni sottoposte ad addestramento aggiuntivo hanno mostrato oscillazioni inferiori, pari rispettivamente a 19,1 punti per V4 Flash e 14,8 punti per V4 Pro, mentre DeepSeek V4.1 Flash ha registrato una differenza di 6,1 punti. I risultati indicano che le procedure di ottimizzazione successive all’addestramento possono attenuare il fenomeno, senza necessariamente eliminarlo. Variazioni analoghe sono state riscontrate nei modelli compressi sviluppati direttamente dal gruppo di ricerca, mentre i sistemi di confronto basati su un normale meccanismo di attenzione completa non hanno manifestato lo stesso andamento periodico.
La sensibilità di fase introduce quindi una specifica limitazione nella valutazione dei modelli progettati per gestire grandi finestre di contesto con un consumo di memoria ridotto. Un sistema può ottenere un’accuratezza media elevata nei benchmark complessivi e, contemporaneamente, presentare posizioni ricorrenti nelle quali il recupero delle informazioni diventa sensibilmente meno affidabile. I ricercatori propongono di integrare le procedure di valutazione con esperimenti che modifichino sistematicamente la posizione dei contenuti rispetto ai confini dei blocchi di compressione, misurando le differenze prestazionali che emergono all’interno della stessa sequenza. I risultati attualmente disponibili riguardano prove controllate di recupero delle informazioni e completamento del codice; rimane da determinare in quale misura le variazioni osservate possano incidere sull’affidabilità e sulla sicurezza delle applicazioni operative reali. La ricerca individua comunque una relazione concreta tra la struttura della compressione della KV cache e la precisione del recupero informativo, fornendo misurazioni specifiche per diverse configurazioni dei modelli DeepSeek.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)