
Nick Cammarata, ricercatore di Goodfire ed ex componente del gruppo di ricerca di OpenAI, ha presentato il 15 ottobre 2026 un’ipotesi sull’interpretabilità delle reti neurali secondo cui numerosi neuroni artificiali potrebbero possedere funzioni interne più coerenti e riconoscibili di quanto suggerito dalle interpretazioni precedenti. La proposta, sviluppata nel lavoro intitolato “Neural Networks Are Already Clean”, mette in discussione l’idea che una parte significativa della complessità interpretativa dei modelli derivi necessariamente dalla sovrapposizione disordinata di concetti indipendenti nelle medesime unità computazionali. Cammarata, che aveva contribuito insieme a Chris Olah e ad altri ricercatori ai lavori “Zoom In” del 2020 e “Multimodal Neurons” del 2021, aveva inoltre partecipato nel 2023 alle ricerche di OpenAI sull’impiego dell’intelligenza artificiale per produrre spiegazioni automatiche del comportamento dei neuroni. La nuova ipotesi nasce dalla revisione di alcuni risultati considerati rappresentativi della difficoltà di interpretare direttamente le attivazioni interne dei modelli. Secondo il ricercatore, il problema potrebbe dipendere in misura rilevante non da una mancanza intrinseca di organizzazione delle reti neurali, ma dall’incapacità degli strumenti analitici utilizzati finora di identificare le proprietà comuni che determinano le risposte dei neuroni.
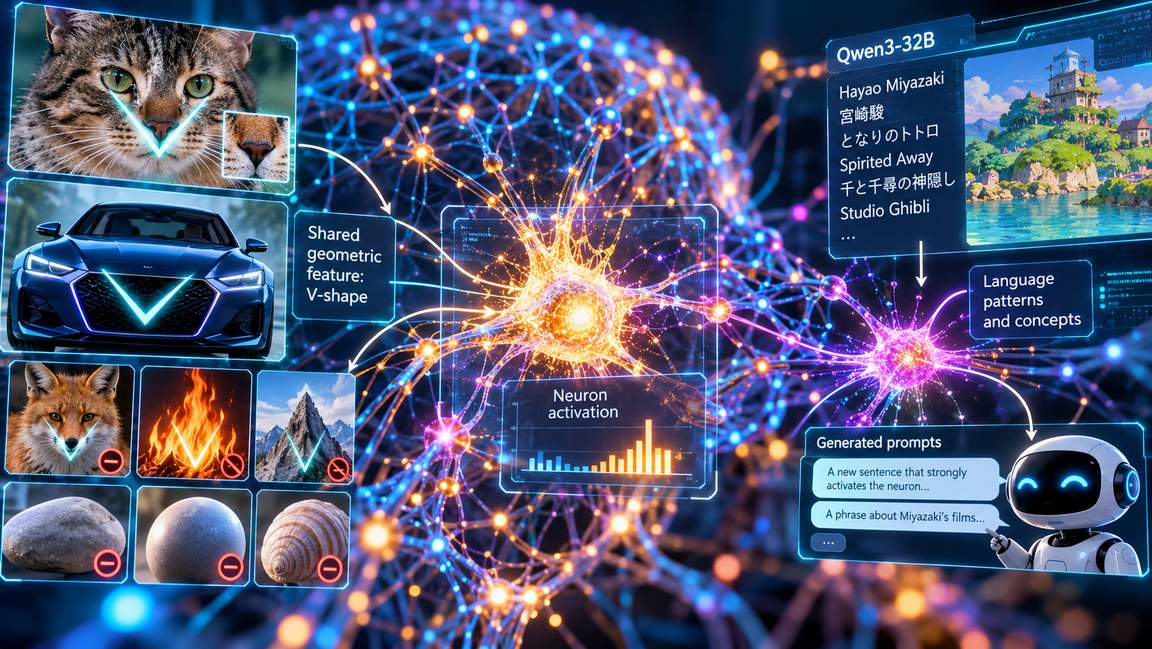
Uno degli esempi riguarda un neurone di un modello di visione artificiale capace di reagire sia alle immagini dei volti dei gatti sia alle parti anteriori delle automobili. In passato, questa risposta era stata interpretata come un caso di rappresentazione simultanea di concetti semanticamente estranei all’interno dello stesso neurone, un comportamento frequentemente associato alla polisemicità delle unità neurali. Cammarata propone invece una spiegazione basata sulle caratteristiche geometriche condivise dagli oggetti: il neurone sarebbe sensibile soprattutto a configurazioni appuntite a forma di V, presenti tanto in alcune caratteristiche del muso dei felini quanto nelle strutture anteriori delle automobili. La stessa interpretazione troverebbe ulteriori elementi di supporto nelle risposte prodotte da immagini di volpi, fiamme e altre strutture appuntite, nonché nelle reazioni di segno opposto associate a forme arrotondate. In questa prospettiva, l’apparente combinazione di concetti differenti deriverebbe dall’osservazione delle categorie rappresentate nelle immagini, mentre la funzione effettiva del neurone sarebbe collegata a una proprietà visiva più elementare e condivisa. La distinzione è importante perché sposta l’analisi dalla ricerca delle categorie semantiche che attivano una determinata unità all’identificazione delle caratteristiche visive o computazionali che possono spiegare con un unico principio risposte apparentemente eterogenee.
L’analisi è stata estesa anche al modello linguistico Qwen3-32B, prendendo in considerazione separatamente le attivazioni positive e negative dei neuroni. Nelle verifiche preliminari, Cammarata ha stimato che circa il 90% delle unità esaminate potesse essere ricondotto a una funzione dominante, pur precisando che la percentuale dipende dai criteri adottati per classificare e interpretare le risposte. Tra gli esempi figurano circuiti capaci di riconoscere sequenze di frammenti ortografici associate al nome di Hayao Miyazaki e di collegarle a informazioni relative alle sue opere. Per verificare che le spiegazioni formulate non fossero soltanto interpretazioni plausibili a posteriori, sono stati realizzati esperimenti nei quali un agente AI esaminava il comportamento di un neurone e produceva una descrizione della sua funzione, mentre un secondo agente, privo dell’accesso diretto al neurone durante la generazione, utilizzava esclusivamente quella descrizione per costruire frasi capaci di provocarne una forte attivazione. In alcuni casi, gli stimoli sintetizzati attraverso questo procedimento hanno prodotto risposte più intense rispetto agli esempi identificati mediante la ricerca in grandi raccolte di dati. Il risultato suggerisce che determinate descrizioni possano avere un valore predittivo sperimentale e non soltanto descrittivo, perché consentono di formulare nuovi input sulla base di un’ipotesi relativa alla funzione interna dell’unità analizzata.
La proposta ha suscitato valutazioni differenti nella comunità di ricerca sull’interpretabilità e sulla sicurezza dei modelli. Il commentatore tecnico conosciuto come Roon ha considerato i risultati potenzialmente importanti per trasformare lo studio dell’allineamento dell’intelligenza artificiale in una disciplina maggiormente fondata su osservazioni e verifiche sperimentali. Anche l’analista Andrew Curran ha espresso interesse, richiamando il precedente pessimismo sulla possibilità di ottenere interpretazioni sufficientemente approfondite dei modelli prima dello sviluppo di sistemi molto più avanzati. Neil Nanda, ricercatore specializzato nell’interpretabilità meccanicistica, ha invece riconosciuto l’interesse del lavoro senza ritenerlo una dimostrazione capace di modificare radicalmente il quadro della disciplina. Secondo Nanda, l’esame diretto dei neuroni può risultare utile per investigare comportamenti anomali o sospetti, ma la ricostruzione di circuiti basata soltanto sulle componenti considerate più importanti rischia di escludere informazioni significative. Rimane inoltre necessario spiegare il contenuto informativo delle attivazioni deboli, non soltanto quello delle risposte particolarmente intense. Comprendere il comportamento di alcune unità e prevederne specifiche attivazioni non equivale infatti a ricostruire integralmente il funzionamento di una rete neurale di grandi dimensioni.
Cammarata ha presentato esplicitamente questa interpretazione come un’ipotesi di lavoro e non come una conclusione definitivamente dimostrata. I risultati preliminari non costituiscono una spiegazione completa del funzionamento di Qwen3-32B né, più in generale, dei grandi modelli linguistici, e i dettagli tecnici degli esperimenti sui modelli di linguaggio dovrebbero essere approfonditi in una pubblicazione successiva. Se le osservazioni venissero confermate su scala più ampia, potrebbero favorire metodi di ricerca basati sull’esame diretto dei neuroni e dei circuiti originali, riducendo in alcuni casi la necessità di utilizzare modelli ausiliari per separare rappresentazioni apparentemente sovrapposte. L’impiego di agenti AI per formulare ipotesi funzionali, generare stimoli di verifica e confrontare le attivazioni potrebbe inoltre consentire l’automazione di una parte delle indagini. La questione ancora aperta riguarda soprattutto la possibilità di passare da spiegazioni affidabili di singoli neuroni o circuiti locali a una descrizione sufficientemente completa delle interazioni che determinano il comportamento dell’intero modello.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)