
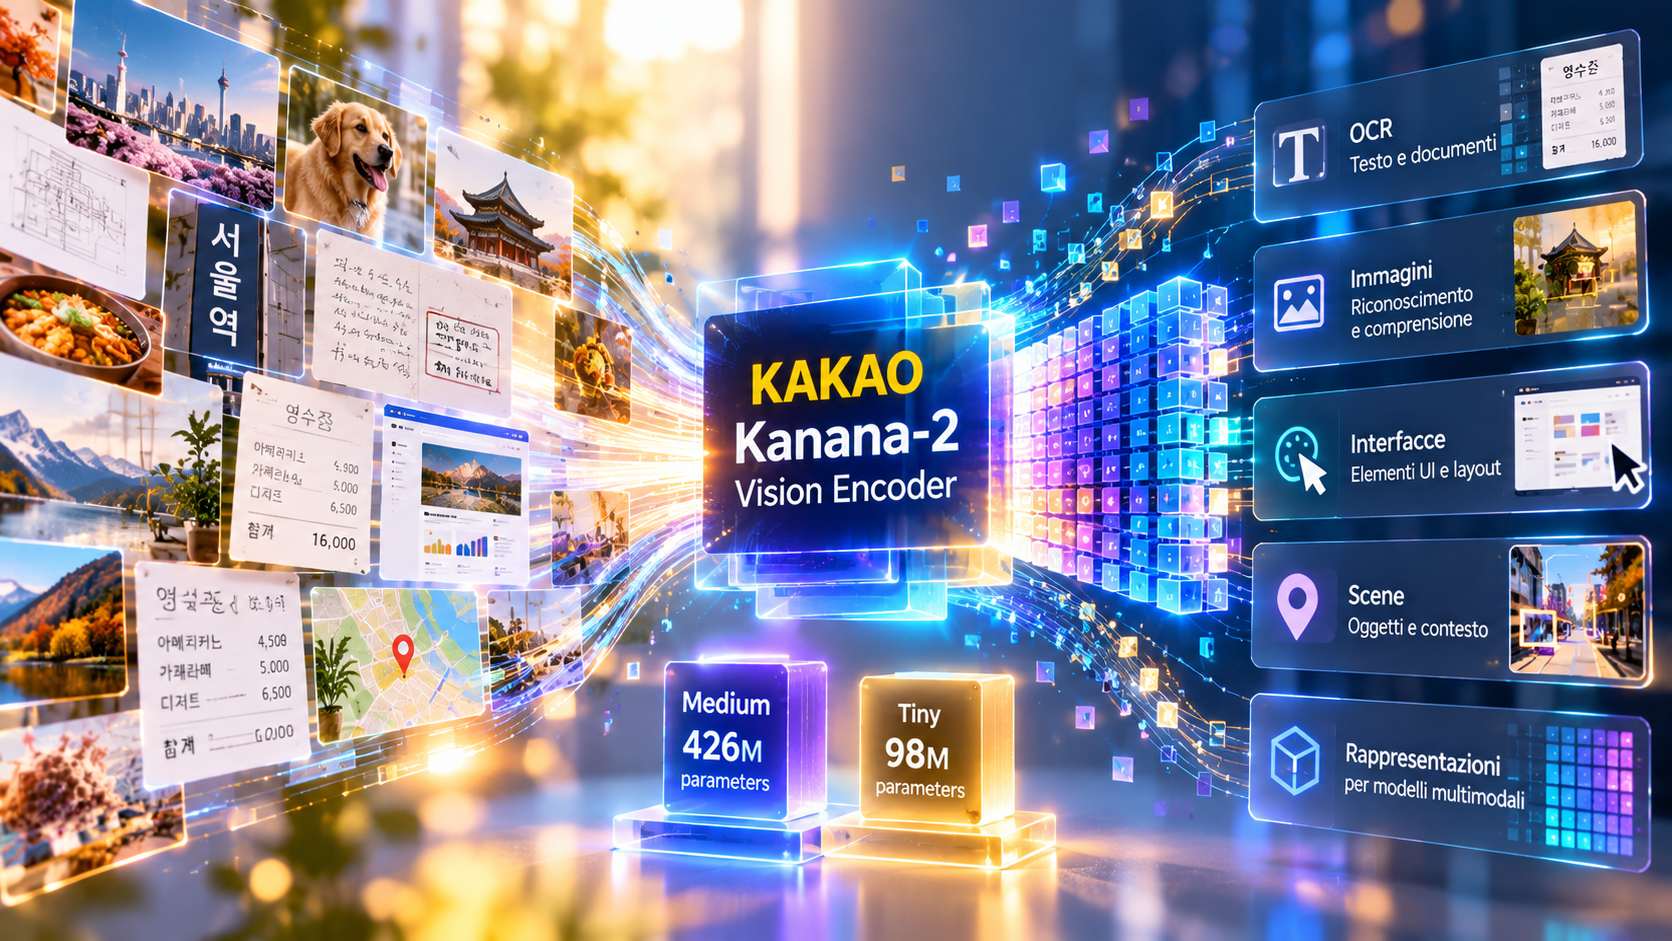
Kakao ha annunciato la pubblicazione open source di Kanana-2 Vision Encoder, una famiglia di modelli progettati per trasformare immagini e contenuti visivi in rappresentazioni utilizzabili dai sistemi di intelligenza artificiale. Il rilascio comprende due varianti: Kanana-2 Vision Encoder Medium, con 426 milioni di parametri, e Kanana-2 Vision Encoder Tiny, con 98 milioni di parametri, destinato in particolare alle applicazioni on-device. Entrambi sono stati resi disponibili attraverso Hugging Face con la Kanana Open License, che consente utilizzi di ricerca e commerciali secondo le relative condizioni. Un vision encoder costituisce il componente che elabora l’immagine iniziale e ne produce una rappresentazione numerica interpretabile dai modelli successivi, svolgendo un ruolo fondamentale nei sistemi multimodali e nelle applicazioni di computer use. Quando un agente AI deve utilizzare un’interfaccia grafica, infatti, la correttezza delle sue operazioni dipende anche dalla capacità di riconoscere testi, pulsanti, elementi del layout e relazioni visive presenti sullo schermo.
Kakao ha sviluppato le due varianti con l’obiettivo di combinare prestazioni nel riconoscimento delle informazioni visive e riduzione delle risorse necessarie all’esecuzione. Medium rappresenta la configurazione più ampia, mentre Tiny concentra le capacità di analisi in un modello con meno di 100 milioni di parametri, caratteristica rilevante per dispositivi nei quali memoria e potenza computazionale risultano limitate. La società ha valutato i modelli attraverso 42 benchmark distribuiti in nove aree, utilizzando come termini di confronto encoder sviluppati da altri importanti gruppi tecnologici, tra cui SigLIP 2 di Google, Perception Encoder di Meta, AIMv2 di Apple e Qwen3.5-ViT di Alibaba. Secondo i risultati comunicati, Kanana-2 Vision Encoder ha ottenuto prestazioni superiori ai modelli confrontati nelle valutazioni presentate dall’azienda. I risultati devono essere interpretati nel contesto delle configurazioni e dei benchmark utilizzati, poiché l’accuratezza degli encoder visivi può variare sensibilmente in funzione della tipologia delle immagini, del task e delle procedure di valutazione.
Una particolare attenzione è stata dedicata al riconoscimento dei caratteri coreani e alla comprensione dei documenti. Kakao ha dichiarato che Kanana-2 Vision Encoder Tiny, pur possedendo soltanto 98 milioni di parametri, ha superato in queste attività alcuni modelli internazionali di dimensioni oltre quattro volte superiori. Il dato riguarda quindi specifiche categorie di riconoscimento e comprensione testuale, nelle quali l’addestramento e la qualità delle rappresentazioni possono incidere più del semplice numero di parametri. Le capacità risultano particolarmente rilevanti per l’elaborazione di schermate, moduli, documenti amministrativi e interfacce che comprendono testo coreano, ma possono contribuire anche a sistemi nei quali informazioni grafiche e contenuti scritti devono essere interpretati congiuntamente.
Per sviluppare gli encoder, Kakao ha utilizzato il proprio modello linguistico Kanana-2 all’interno della procedura di addestramento visivo. Secondo le dichiarazioni dell’azienda, tale impostazione ha consentito di incrementare di circa quattro volte l’efficienza dell’addestramento. È stata inoltre introdotta una progettazione specifica per l’elaborazione delle immagini ad alta risoluzione, con una riduzione della latenza superiore al 60% rispetto ai principali modelli internazionali utilizzati come riferimento. La documentazione pubblicamente comunicata non permette di considerare questi valori come garanzie di identiche prestazioni in qualsiasi implementazione: latenza e utilizzo delle risorse dipendono anche dall’hardware, dalla dimensione delle immagini e dalla configurazione del sistema.
La pubblicazione dei pesi attraverso Hugging Face permette agli sviluppatori di integrare gli encoder in sistemi più ampi, compresi agenti che analizzano schermate e interagiscono con applicazioni software. Un encoder visivo non costituisce da solo un agente capace di controllare un computer: deve essere collegato a componenti che interpretano le rappresentazioni prodotte, decidono le azioni ed eseguono le operazioni attraverso gli strumenti disponibili. La disponibilità di una variante Tiny rende inoltre possibile sperimentare l’elaborazione visiva locale su dispositivi con risorse limitate, mentre Medium è destinato a situazioni nelle quali è possibile utilizzare una capacità computazionale superiore. Kakao colloca Kanana-2 Vision Encoder nella propria strategia di sviluppo dei foundation model, rendendo disponibile una componente specializzata per applicazioni multimodali e per i sistemi AI che devono interpretare visivamente documenti e interfacce grafiche.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)