
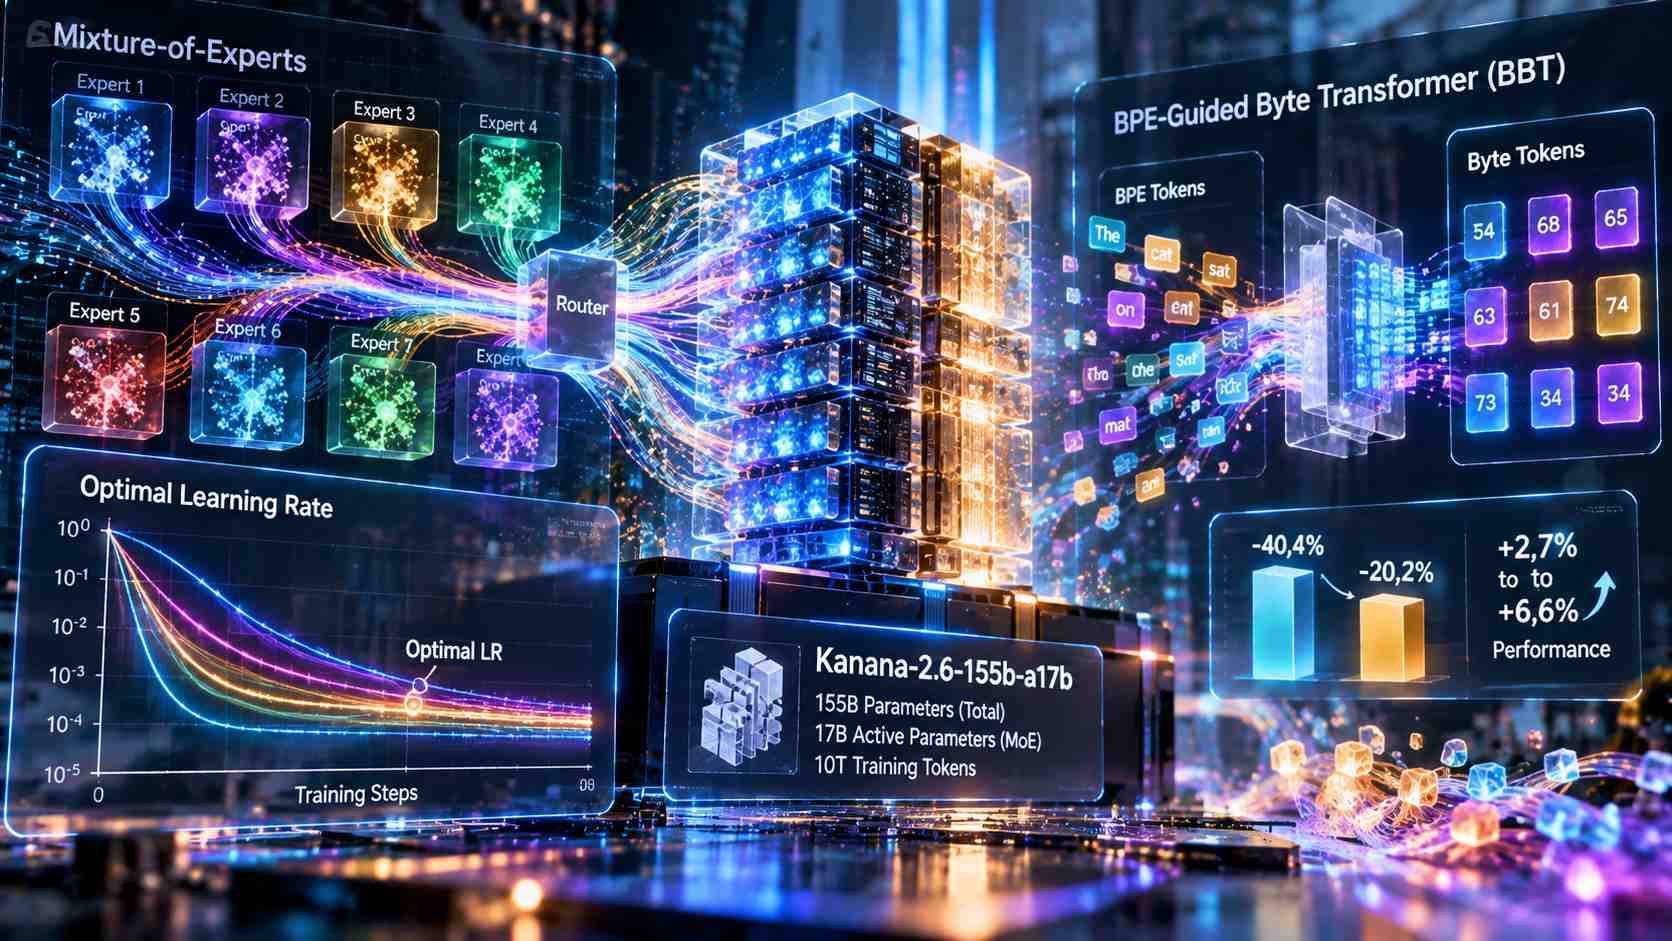
Kakao ha presentato due ricerche dedicate all’efficienza dei modelli linguistici durante COLM 2026, la Conference on Language Modeling, annunciando una metodologia per individuare il tasso di apprendimento ottimale dei grandi modelli Mixture-of-Experts e una nuova architettura denominata BBT, BPE-Guided Byte Transformer, progettata per ridurre il numero di parametri mantenendo o migliorando le capacità del modello. I risultati, comunicati l’8 ottobre 2026, sono stati illustrati rispettivamente durante la conferenza principale e nel workshop TokShop, dedicato alle tecnologie di tokenizzazione. Le due ricerche affrontano problematiche differenti ma direttamente collegate al costo di sviluppo e distribuzione dei sistemi di intelligenza artificiale. La prima interviene sul processo di preaddestramento, cercando di individuare configurazioni che garantiscano stabilità e prestazioni senza richiedere numerose prove estremamente costose su modelli di grandi dimensioni. La seconda riguarda invece il modo in cui le informazioni testuali vengono rappresentate e elaborate, con l’obiettivo di diminuire la memoria necessaria per il modello senza sacrificare le caratteristiche che rendono efficiente il trattamento di sequenze linguistiche estese. Kakao ha dichiarato che la metodologia di ottimizzazione dell’apprendimento è già stata applicata al proprio modello Kanana-2.6-155b-a17b, mentre BBT ha ottenuto nei confronti sperimentali una riduzione dei parametri compresa tra il 20,2% e il 40,4%, accompagnata da miglioramenti prestazionali dal 2,7% al 6,6%.
La ricerca presentata durante la conferenza principale riguarda l’individuazione del learning rate, uno degli iperparametri fondamentali nell’addestramento delle reti neurali. Il tasso di apprendimento determina l’ampiezza degli aggiornamenti applicati ai parametri del modello durante l’ottimizzazione e influenza direttamente la stabilità numerica, la velocità di convergenza e la qualità del risultato finale. Un valore eccessivamente elevato può produrre oscillazioni o instabilità, impedendo al sistema di raggiungere una configurazione soddisfacente, mentre un valore troppo contenuto può rallentare il processo di apprendimento e determinare un utilizzo inefficiente delle risorse computazionali. La scelta diventa particolarmente delicata nel caso dei modelli Mixture-of-Experts, caratterizzati dalla presenza di numerosi componenti specializzati e da meccanismi di instradamento che determinano quali esperti debbano essere attivati per elaborare le informazioni. Rispetto ai modelli densi, nei quali tutti i parametri pertinenti all’architettura partecipano ordinariamente a ogni passaggio, i sistemi MoE presentano dinamiche di ottimizzazione più articolate, legate anche alla distribuzione del lavoro tra gli esperti e al comportamento delle componenti di routing. La ricerca pubblica disponibile sulle configurazioni ottimali per questi sistemi è inoltre meno estesa rispetto a quella relativa alle architetture tradizionali, aumentando il rischio di dover ripetere esperimenti costosi durante la preparazione di modelli di grandi dimensioni.
Per affrontare il problema, Kakao ha adattato alle architetture Mixture-of-Experts una metodologia basata sulla μ-Parameterization, o mu-parameterization, una tecnica che permette di trasferire determinate proprietà dell’ottimizzazione tra modelli caratterizzati da scale differenti. Il principio consiste nell’individuare configurazioni efficaci attraverso esperimenti condotti su modelli relativamente piccoli e utilizzare regole di scalabilità per applicarle successivamente a sistemi molto più grandi. La ricerca di Kakao ha esteso questo approccio alle caratteristiche delle architetture MoE, verificando progressivamente il comportamento delle impostazioni individuate al crescere delle dimensioni del modello e della quantità di token utilizzati durante l’addestramento. Gli esperimenti hanno inoltre preso in considerazione la possibilità di individuare parametri validi attraverso segmenti relativamente brevi del processo di apprendimento e di trasferire successivamente le configurazioni a esecuzioni molto più estese. In questo modo la selezione del learning rate non richiede necessariamente l’addestramento completo di molteplici versioni di un modello di frontiera, ma può essere effettuata utilizzando un insieme di esperimenti preliminari più economici. Kakao ha dichiarato che la metodologia permette di prevedere il valore ottimale del tasso di apprendimento con un costo computazionale corrispondente a circa l’1% di quello necessario per l’addestramento complessivo del modello di riferimento. Questo dato riguarda il costo della procedura di individuazione del learning rate e non significa che l’intero preaddestramento possa essere completato utilizzando soltanto l’1% delle risorse normalmente necessarie.
La validazione della metodologia è stata condotta anche attraverso l’addestramento di Kanana-2.6-155b-a17b, un modello appartenente alla famiglia Kanana e basato su un’architettura Mixture-of-Experts. La denominazione identifica un sistema con circa 155 miliardi di parametri complessivi e una componente attiva di circa 17 miliardi di parametri per ciascun passaggio di elaborazione. La metodologia di selezione del learning rate è stata effettivamente applicata al suo preaddestramento, consentendo secondo Kakao di mantenere la stabilità del processo fino a diecimila miliardi di token, equivalenti a 10 trilioni nella notazione internazionale. Questo risultato documenta l’utilizzo della tecnica su un modello di dimensioni considerevoli e su un volume di dati di addestramento particolarmente elevato. La possibilità di prevedere configurazioni adeguate prima dell’avvio delle fasi più onerose permette di ridurre gli esperimenti necessari e il rischio di interrompere o ripetere lunghe sessioni a causa di impostazioni inefficaci. Il risparmio effettivo dipende comunque dalle procedure di ricerca degli iperparametri adottate come riferimento, dall’architettura del modello e dalle condizioni computazionali considerate. Kakao non ha comunicato un benchmark quantitativo generale che permetta di attribuire alla tecnica una percentuale uniforme di riduzione del costo complessivo di sviluppo per qualsiasi modello MoE. Il risultato verificato riguarda principalmente la previsione del learning rate a basso costo e la successiva applicazione della configurazione a un processo di preaddestramento esteso.
La seconda ricerca, presentata durante TokShop, introduce BBT, acronimo di BPE-Guided Byte Transformer, un’architettura progettata per combinare l’elaborazione del testo a livello di byte con alcuni vantaggi delle tecniche di tokenizzazione basate su Byte Pair Encoding. Nei modelli linguistici tradizionali, la tokenizzazione suddivide il testo in unità che possono rappresentare parole, parti di parole, simboli oppure sequenze ricorrenti di caratteri. Il metodo BPE costruisce progressivamente un vocabolario di unità attraverso la combinazione delle sequenze più frequenti, permettendo di rappresentare porzioni relativamente estese del testo mediante un numero contenuto di token. Questa soluzione riduce la lunghezza delle sequenze da elaborare, ma richiede al modello di mantenere rappresentazioni associate a un vocabolario che può comprendere numerose decine o centinaia di migliaia di elementi. Le dimensioni delle matrici di embedding e delle componenti associate alla rappresentazione del vocabolario contribuiscono quindi alla quantità complessiva di parametri e memoria necessaria. Un approccio basato direttamente sui byte può invece utilizzare un insieme di unità fondamentali molto più piccolo, evitando di dipendere da un vocabolario ampio di sottoparole. L’elaborazione dei singoli byte presenta tuttavia un problema differente: una stessa frase può richiedere un numero di passaggi molto superiore rispetto a quello necessario quando viene rappresentata attraverso token BPE.
BBT è stato concepito per affrontare questo compromesso, utilizzando i byte come unità fondamentali di rappresentazione e conservando un meccanismo guidato da BPE per raggruppare e trattare efficientemente le informazioni. L’architettura permette quindi di ridurre la dipendenza da un grande vocabolario di token, senza rinunciare interamente ai vantaggi computazionali derivanti dall’elaborazione di segmenti testuali più estesi. L’integrazione tra rappresentazione a livello di byte e organizzazione guidata dalle unità BPE costituisce l’elemento distintivo della proposta. Kakao ha confrontato BBT con configurazioni di riferimento ottenendo una riduzione del numero di parametri compresa tra il 20,2% e il 40,4%, accompagnata da miglioramenti delle prestazioni nei test compresi tra il 2,7% e il 6,6%. I due intervalli derivano da differenti configurazioni sperimentali e non devono essere interpretati come un risultato identico garantito su qualsiasi modello, dataset o dispositivo. La diminuzione dei parametri rappresenta inoltre una misura strutturale delle dimensioni del modello, mentre il risparmio effettivo in memoria e nei tempi di esecuzione dipende anche dal runtime, dalla precisione numerica utilizzata, dalla lunghezza delle sequenze elaborate e dall’organizzazione delle operazioni computazionali. Il risultato presentato da Kakao riguarda quindi una possibilità concreta di ridimensionamento dell’architettura mantenendo prestazioni competitive, non una percentuale universale di accelerazione delle inferenze.
Un ulteriore elemento della valutazione riguarda la robustezza agli errori di scrittura e alle alterazioni delle sequenze di caratteri. I sistemi basati su vocabolari di sottoparole possono incontrare difficoltà quando ricevono termini contenenti refusi, caratteri inseriti o sostituiti, traslitterazioni insolite oppure sequenze linguistiche scarsamente rappresentate durante la costruzione del tokenizer. Una piccola modifica della parola può produrre una segmentazione molto diversa da quella prevista per la forma corretta, aumentando la frammentazione e alterando le rappresentazioni disponibili al modello. L’elaborazione basata sui byte permette invece di rappresentare direttamente qualsiasi sequenza codificabile senza richiedere che essa corrisponda a una specifica voce del vocabolario. Nelle prove comunicate da Kakao, BBT ha mostrato una maggiore robustezza agli errori tipografici e alle perturbazioni dei caratteri, oltre a una migliore capacità di trasferimento verso lingue non utilizzate durante l’addestramento. Questo risultato è particolarmente rilevante nelle applicazioni multilingue e nei servizi conversazionali, dove gli input possono comprendere nomi propri, termini tecnici, parole straniere, simboli e digitazioni non perfettamente corrette. Kakao non ha però pubblicato nel comunicato risultati numerici separati per ciascun test di robustezza o per le singole lingue, limitandosi a riportare il miglioramento complessivo osservato.
Le possibili applicazioni di BBT comprendono soprattutto modelli destinati a dispositivi con risorse di memoria limitate e sistemi che devono gestire informazioni linguistiche eterogenee. Riducendo il numero dei parametri associati alla rappresentazione del testo, l’architettura può contribuire ad abbassare le risorse necessarie per conservare il modello e renderne più praticabile l’esecuzione su dispositivi personali o ambienti edge. L’analisi a livello di byte può inoltre semplificare la gestione di lingue che presentano caratteristiche molto differenti da quelle prevalenti nei dataset di addestramento, evitando che il vocabolario iniziale costituisca un vincolo troppo rigido. Le prospettive applicative indicate da Kakao comprendono l’estensione delle ricerche a differenti architetture linguistiche, ambienti multimodali e sistemi multilingue. Le due tecnologie presentate durante COLM 2026 intervengono quindi su fasi distinte del ciclo di vita dei modelli: la metodologia basata sulla μ-Parameterization migliora l’efficienza della preparazione e dell’addestramento di grandi architetture MoE, mentre BBT agisce sulla rappresentazione degli input e sulle dimensioni della rete neurale. Entrambe sono state proposte come strumenti per contenere i requisiti computazionali dei sistemi di intelligenza artificiale, attraverso risultati sperimentali specifici anziché mediante una semplice riduzione indiscriminata delle dimensioni o del volume dei dati utilizzati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)