
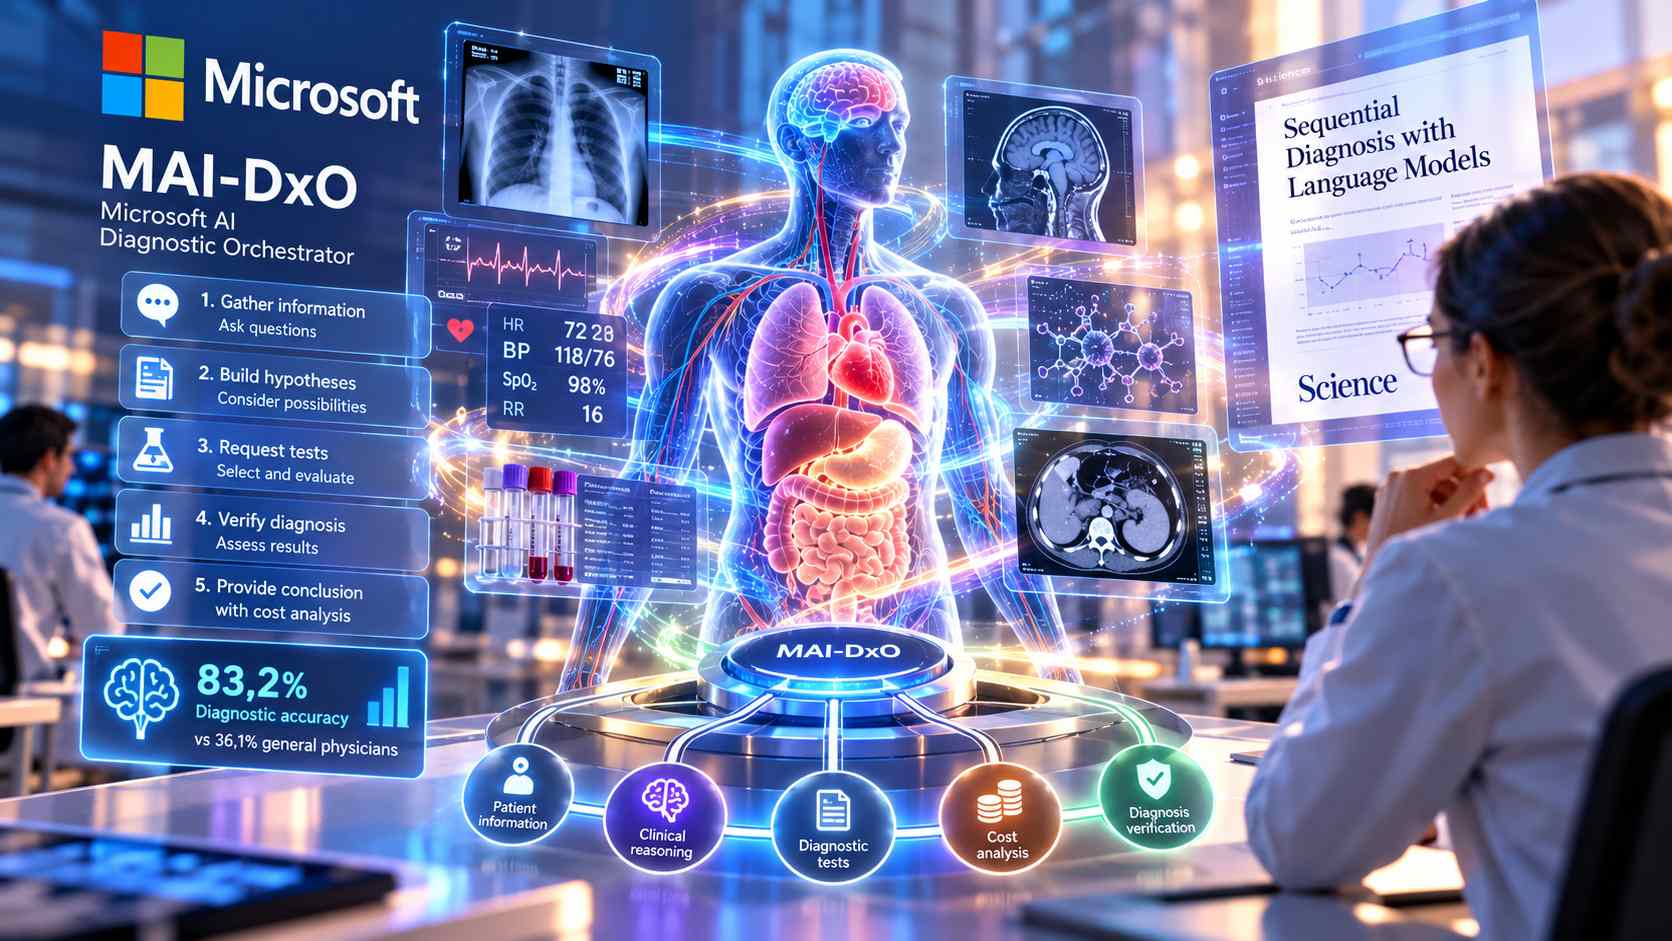
Microsoft ha presentato i risultati della valutazione scientifica di MAI-DxO, Microsoft AI Diagnostic Orchestrator, un sistema di intelligenza artificiale progettato per affrontare processi diagnostici complessi attraverso una sequenza strutturata di raccolta delle informazioni cliniche, formulazione delle ipotesi, richiesta degli esami e verifica delle diagnosi. La ricerca, pubblicata il 22 ottobre 2026 sulla rivista Science con il titolo Sequential diagnosis with language models, ha evidenziato un’accuratezza diagnostica dell’83,2% nei casi clinici tratti dal New England Journal of Medicine, rispetto al 36,1% ottenuto dai medici generalisti partecipanti alla sperimentazione con accesso a risorse di consultazione. Lo studio, apparso nel volume 394, numero 6822, alle pagine 423–428, è stato realizzato da quindici ricercatori Microsoft, tra i quali Mustafa Suleyman, Dominic King ed Eric Horvitz. Il progetto introduce un’impostazione differente rispetto ai tradizionali benchmark medici, nei quali i modelli linguistici ricevono tutte le informazioni cliniche contemporaneamente e devono formulare una diagnosi in un unico passaggio. MAI-DxO opera invece attraverso un procedimento interattivo che riproduce le decisioni successive di un percorso diagnostico, includendo la selezione degli approfondimenti clinici e la valutazione dei relativi costi.
L’infrastruttura sperimentale si basa su SDBench, Sequential Diagnosis Benchmark, sviluppato utilizzando 304 casi clinico-patologici del New England Journal of Medicine e 325 episodi di accesso al pronto soccorso con successivo ricovero provenienti dal dataset MIMIC-IV-ED. Ogni caso inizia con una descrizione clinica sintetica, sulla quale il sistema può formulare domande anamnestiche, richiedere informazioni relative all’esame obiettivo, prescrivere accertamenti diagnostici e decidere quando dispone di elementi sufficienti per formulare una conclusione. Un agente denominato Gatekeeper gestisce l’accesso alle informazioni presenti nei casi originali e produce risultati sintetici diagnostically neutrali quando un dato richiesto non è disponibile, impedendo che l’assenza di informazioni diventi un indizio artificiale. Un secondo agente, Judge, valuta la corrispondenza tra la diagnosi formulata e quella di riferimento attraverso una scala a cinque livelli definita da medici, considerando corrette le valutazioni che raggiungono i livelli quattro o cinque, nei quali la differenza diagnostica non comporterebbe una modifica della gestione clinica. I costi degli esami sono stimati attraverso riferimenti tariffari CPT derivati dai prezzi ospedalieri di Kaiser Permanente Washington, mentre le domande e le valutazioni cliniche sono ricomprese in un costo fisso di visita.
L’orchestratore diagnostico è indipendente dal modello linguistico utilizzato e simula il lavoro di un gruppo di specialisti virtuali con ruoli complementari, introducendo valutazioni successive, confronto tra ipotesi diagnostiche e controllo delle spese necessarie per arrivare alla diagnosi. Nella configurazione basata su GPT-5 senza vincoli economici, MAI-DxO ha raggiunto l’83,2% di accuratezza nei casi clinico-patologici, con un costo medio stimato di 5.431 dollari per caso. Introducendo limitazioni economiche, il sistema ha ottenuto un’accuratezza dell’80,9% con 2.241 dollari e del 79,6% con 1.303 dollari. Una configurazione orientata alla massima accuratezza ha invece raggiunto l’84,5%, con un costo medio di 8.945 dollari. Nel confronto umano, effettuato su 56 casi esclusi dalle attività di sviluppo, sono state raccolte 764 diagnosi senza consultazione di risorse e 662 diagnosi con accesso a materiali di riferimento. I medici hanno raggiunto rispettivamente il 22,3% e il 36,1% di accuratezza, con costi medi di 3.049 e 4.725 dollari. Il miglior risultato individuale è stato del 51,8%. Sono emerse anche differenze nella strategia di raccolta delle informazioni: i medici hanno formulato mediamente 5,6 domande prima del primo esame, contro le 25,5 domande prodotte dal sistema basato su GPT-5.
Nella valutazione dei casi provenienti dal pronto soccorso, MAI-DxO ha raggiunto un’accuratezza dell’80,3% con una spesa media di 4.979 dollari senza restrizioni di budget e del 73,2% con una spesa media di 2.634 dollari nella configurazione economicamente vincolata. I medici generalisti hanno ottenuto un’accuratezza media del 46,8%, con un costo stimato di 3.400 dollari, mentre il miglior partecipante ha raggiunto il 62,5%. L’orchestrazione multiagente ha inoltre migliorato l’accuratezza rispetto all’impiego dei modelli con prompt di base di 7,9 punti percentuali nei casi clinico-patologici e di 4,4 punti nei casi di pronto soccorso. Il sistema, inizialmente sviluppato con GPT-4.1, è stato successivamente valutato con GPT-5 e GPT-5.5 senza modificare la struttura dell’orchestrazione o i prompt. I risultati ampliano quelli preliminari diffusi nel giugno 2025, quando una configurazione con OpenAI o3 aveva raggiunto l’80% di accuratezza e una configurazione orientata alla massima precisione l’85,5%.
I risultati devono essere interpretati considerando le condizioni sperimentali. Il confronto riguarda medici generalisti impegnati individualmente in simulazioni diagnostiche, non specialisti, équipe multidisciplinari o processi clinici reali. Le simulazioni non riproducono integralmente l’incertezza delle testimonianze dei pazienti, la documentazione incompleta, il rapporto medico-paziente, il monitoraggio longitudinale e l’interpretazione diretta di immagini diagnostiche o preparati anatomopatologici. La valutazione misura inoltre la correttezza delle diagnosi, non la qualità delle decisioni terapeutiche o la sicurezza complessiva delle cure. Gli autori sono dipendenti Microsoft e detengono partecipazioni azionarie nella società, mentre alcuni risultano coinvolti in una domanda di brevetto relativa alla valutazione automatizzata della diagnosi sequenziale.
Microsoft ha reso disponibili in modalità open source, con licenza MIT, componenti di SDBench comprendenti Gatekeeper, Judge, il sistema di stima dei costi e una selezione di casi clinici. I dati derivati dal New England Journal of Medicine richiedono una licenza dedicata, mentre il materiale MIMIC è distribuito attraverso PhysioNet con requisiti di accesso specifici. La versione iniziale comprende anche cinque casi interamente sintetici. Parallelamente, Microsoft ha presentato il quadro di ricerca Medical Superintelligence: Foundations and Aspirations, articolato in sei dimensioni interdipendenti dell’intelligenza medica, e ha avviato un coordinamento tra Microsoft Research, Dragon Copilot, PowerScribe e le altre attività sanitarie di Microsoft AI. Le collaborazioni cliniche includono Mayo Clinic, con lo sviluppo di un modello sanitario destinato a essere posseduto dalla struttura medica e reso disponibile attraverso Azure Foundry, e Beth Israel Deaconess Medical Center di Boston, dove è prevista una valutazione prospettica del ragionamento clinico del sistema attraverso interazioni dirette con i pazienti e confronti con le valutazioni indipendenti dei medici.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)