
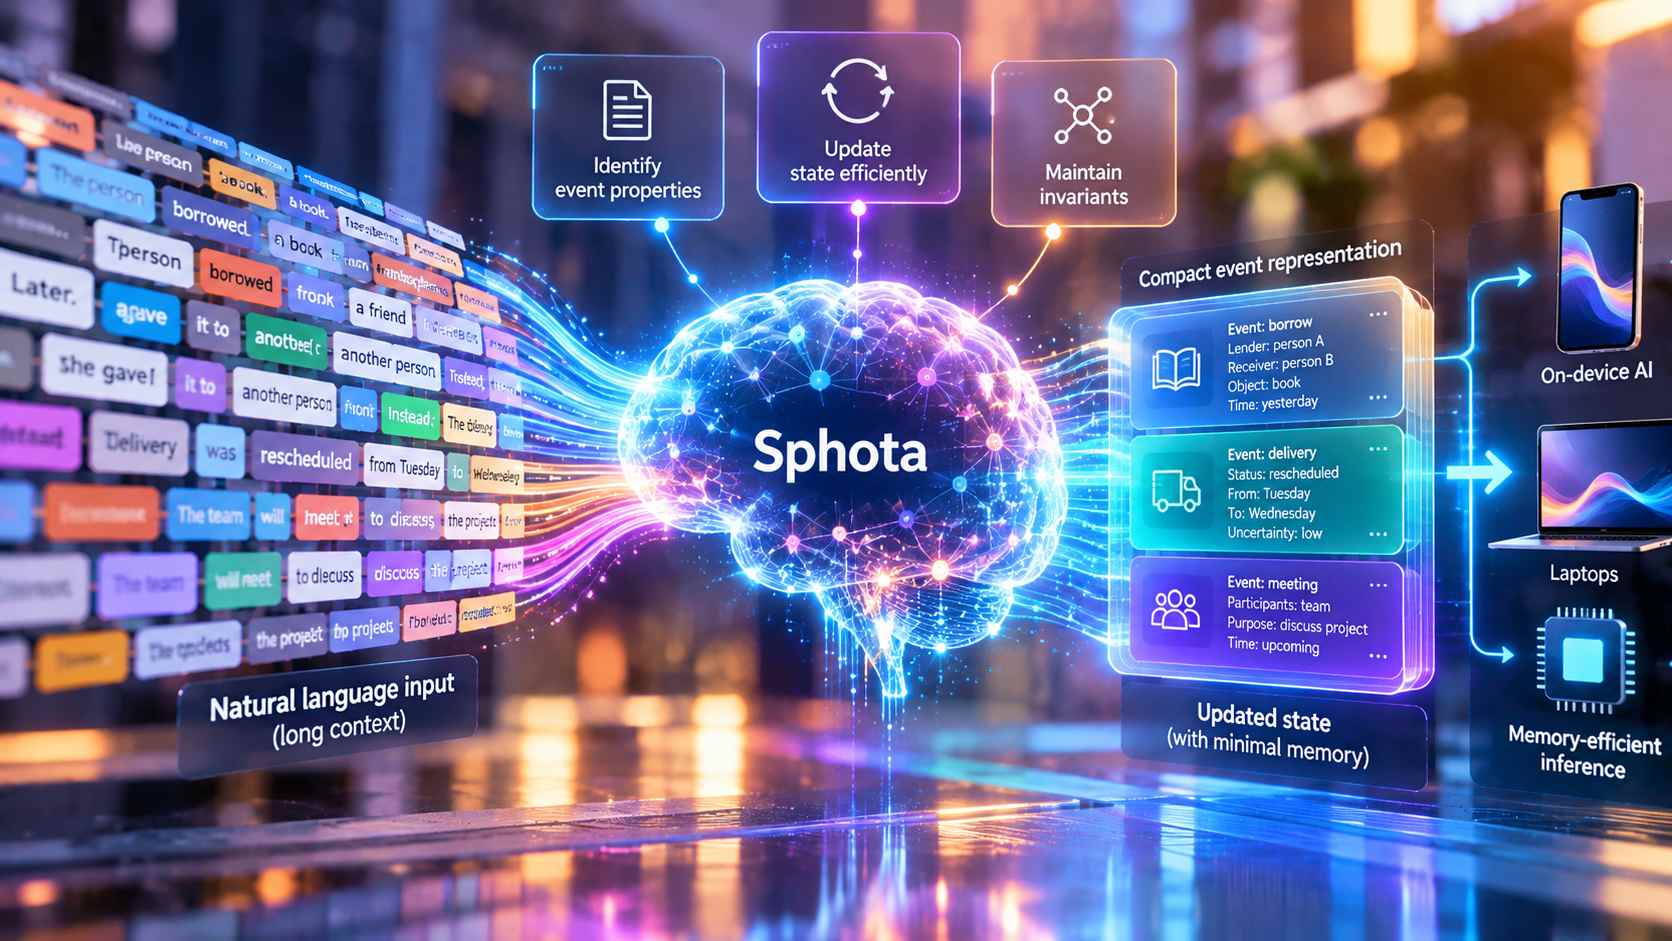
NeuroDx ha presentato in anteprima Sphota, un’architettura di modello linguistico sviluppata con l’obiettivo di ridurre il consumo di memoria durante l’inferenza attraverso una rappresentazione più compatta degli eventi descritti nel linguaggio naturale. La proposta è stata illustrata da Siddharth Panwar, amministratore delegato di NeuroDx e assistant professor presso l’Indian Institute of Technology Mandi, durante Cypher 2026. Il principio progettuale consiste nel mantenere una rappresentazione dello stato di un evento e aggiornarla quando arrivano nuove informazioni, evitando di ricostruire ripetutamente il medesimo contesto a partire dall’intera sequenza dei token. L’architettura si trova ancora in una fase preliminare di sviluppo e le misurazioni condivise dall’azienda non costituiscono benchmark ufficiali di un modello commercialmente disponibile.
Nei modelli Transformer autoregressivi tradizionali, l’elaborazione del contesto si avvale generalmente di una cache key-value che conserva le rappresentazioni necessarie ai meccanismi di attenzione durante la generazione dei token successivi. La quantità di memoria richiesta può diventare significativa quando aumenta la lunghezza del contesto, soprattutto nei sistemi che devono mantenere conversazioni estese oppure operare con risorse hardware limitate. Sphota affronta il problema attraverso un’impostazione orientata alla rappresentazione dello stato: anziché trattare ogni nuova informazione soltanto come un elemento aggiuntivo nella sequenza, il modello cerca di identificare le proprietà che caratterizzano l’evento e le trasformazioni che intervengono nel corso della descrizione. Panwar ha definito queste proprietà come gli elementi invarianti dell’evento, ossia le informazioni che ne determinano la struttura anche quando cambiano alcuni dettagli della situazione rappresentata.
Gli esempi utilizzati per spiegare il funzionamento riguardano eventi nei quali viene modificato uno degli elementi della relazione. Se una persona presta un libro a un’altra e una frase successiva introduce un soggetto differente, il sistema dovrebbe aggiornare la rappresentazione del prestatore senza ricostruire integralmente tutte le informazioni precedenti. Analogamente, quando una consegna inizialmente prevista per martedì viene rinviata a mercoledì, la rappresentazione dovrebbe riflettere la variazione temporale e l’eventuale incertezza associata all’evento. La proposta mira a distinguere le informazioni persistenti dalle modifiche che intervengono successivamente, riducendo le rappresentazioni ridondanti e il costo di aggiornamento del contesto.
NeuroDx ha condotto confronti preliminari con un modello da 600 milioni di parametri, indicando una riduzione sostanziale della memoria necessaria alla cache key-value e un minor numero di operazioni in virgola mobile. I risultati sono stati descritti come incoraggianti, ma non sono ancora accompagnati da un rapporto tecnico pubblico completo che permetta di verificare in modo indipendente le configurazioni sperimentali, i carichi di lavoro e le condizioni del confronto. Rimangono quindi da documentare l’efficienza su contesti di lunghezza differente, la qualità della generazione, l’accuratezza nel ragionamento, la capacità di conservare informazioni storiche e le eventuali perdite derivanti dalla compressione dello stato. Panwar ha indicato come possibile destinazione applicativa dispositivi con memoria limitata, tra cui smartphone e computer portatili, per i quali il consumo della cache durante l’inferenza rappresenta un vincolo importante. NeuroDx prevede di uscire dalla fase stealth nei prossimi mesi e di pubblicare un modello basato sull’architettura entro il 2026, secondo il programma comunicato durante la presentazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)