
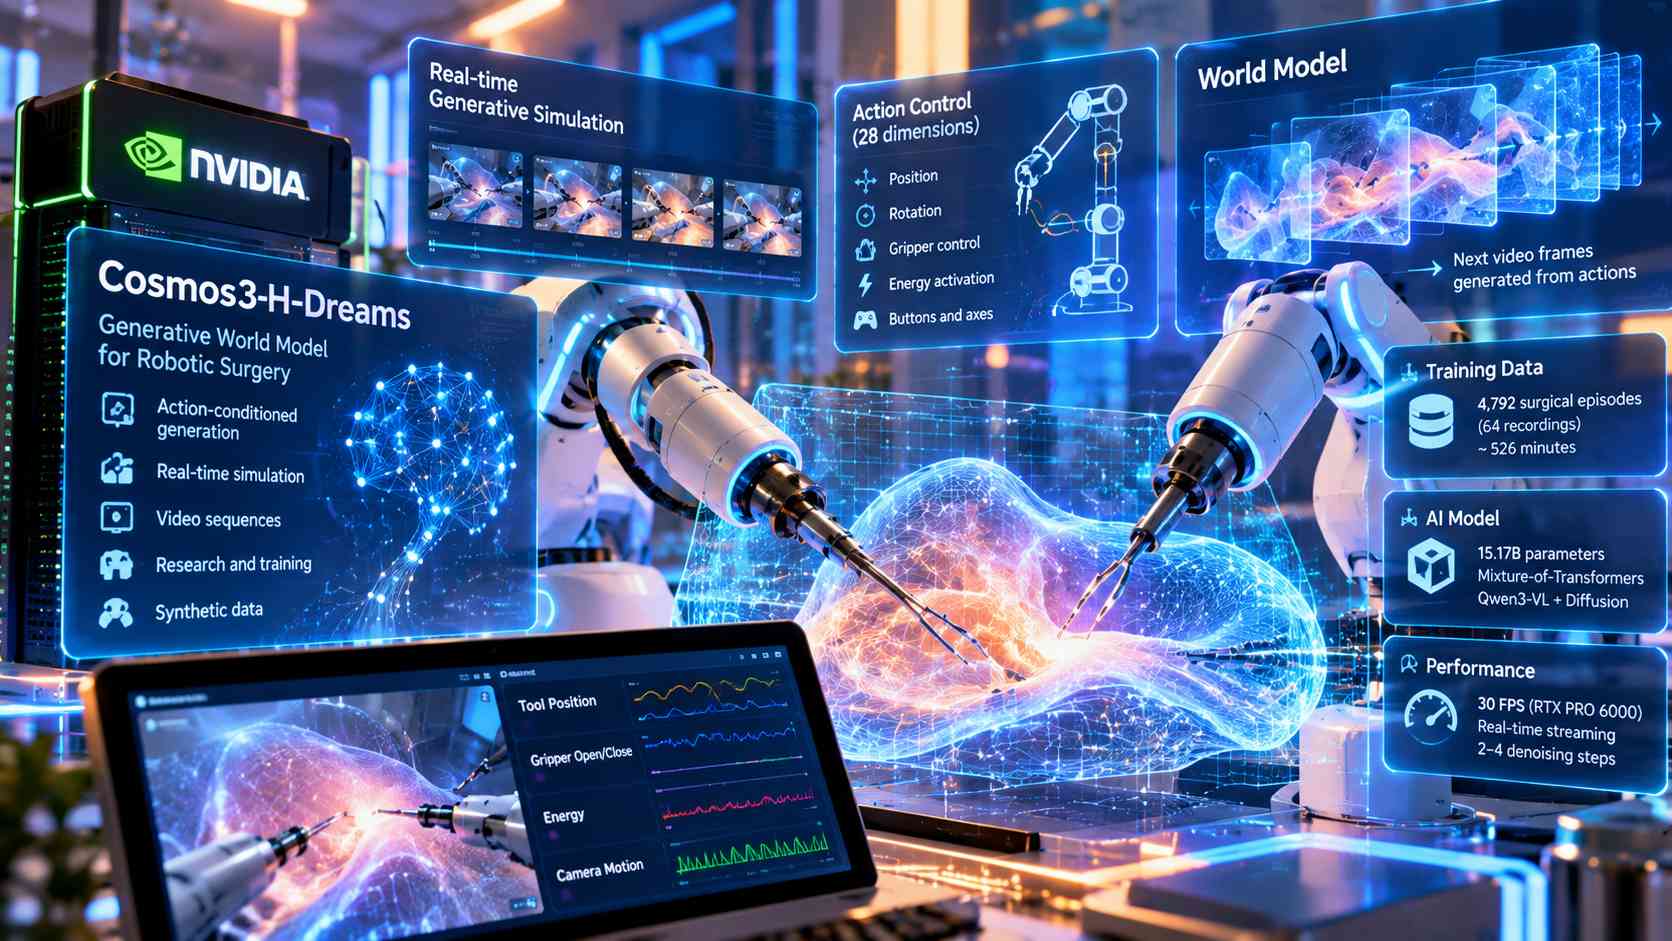
NVIDIA ha rilasciato Cosmos3-H-Dreams, un world model generativo condizionato dalle azioni progettato per riprodurre in tempo reale scenari di chirurgia robotica attraverso sequenze video controllabili mediante comandi cinematici. Il sistema è stato specializzato utilizzando registrazioni cliniche di colecistectomie eseguite con la piattaforma robotica Versius di CMR Surgical e rappresenta un’evoluzione di Cosmos-H-Dreams, precedentemente sviluppato per simulare attività di sutura su banco attraverso il sistema robotico dVRK. L’obiettivo tecnico consiste nel costruire un ambiente visivo interattivo capace di reagire ai movimenti degli strumenti chirurgici senza ricorrere necessariamente a una ricostruzione geometrica esplicita dei tessuti e delle loro proprietà meccaniche. Il modello apprende infatti le relazioni tra video, azioni e cambiamenti dell’ambiente a partire da dati sincronizzati, generando le immagini successive in funzione dei comandi ricevuti. La versione distribuita è destinata alla ricerca sulla robotica chirurgica, alla valutazione di politiche di controllo in simulazione, all’esplorazione mediante teleoperazione e alla generazione di dati sintetici. NVIDIA precisa che si tratta di un simulatore sperimentale e non di un sistema clinicamente validato per l’assistenza ai pazienti.
L’architettura deriva da Cosmos3-H-Embodied-Nano, modello da 16 miliardi di parametri addestrato sul dataset Open-H-Embodiment, e impiega una struttura Mixture-of-Transformers che combina una componente di ragionamento basata su Qwen3-VL-8B-Instruct con un esperto generativo a diffusione latente. Cosmos3-H-Dreams contiene complessivamente circa 15,17 miliardi di parametri e utilizza rappresentazioni latenti prodotte dal VAE Wan2.2, integrate con embedding delle azioni cinematiche. L’interfaccia di controllo comprende 28 dimensioni per intervallo temporale, suddivise in 14 per ciascun braccio robotico. I parametri descrivono traslazione relativa a un punto di riferimento, rotazione rappresentata in sei dimensioni, apertura e chiusura delle pinze, attivazione dell’energia elettrochirurgica, pulsanti e assi dei controller. Rispetto alla configurazione precedente a 20 dimensioni, il sistema è stato esteso per rappresentare le caratteristiche operative di Versius, conservando i pesi già appresi per posizione e apertura degli strumenti e inizializzando a zero quelli associati ai nuovi controlli. Le immagini di addestramento sono elaborate a 832 × 480 pixel e le azioni sono allineate a una frequenza di 10 Hz.
La pipeline di preparazione utilizza un modello teacher bidirezionale, inizialmente specializzato su sequenze di 24 fotogrammi futuri per 2.000 iterazioni e successivamente su un orizzonte di 72 fotogrammi per altre 4.400 iterazioni. Alla frequenza di 10 Hz, i due intervalli corrispondono rispettivamente a 2,4 e 7,2 secondi di evoluzione simulata. La successiva distillazione trasforma il teacher, che richiede 35 passaggi di campionamento, in uno student autoregressivo con struttura block-causal. Questa fase comprende 1.000 iterazioni di causal teacher forcing e 300 iterazioni di Self-Forcing con distribution-matching distillation. Il modello risultante genera le immagini utilizzando una cache key/value e quattro passaggi di denoising per fotogramma latente, consumando quattro vettori di azioni future, equivalenti a 0,4 secondi di controllo, e producendo quattro nuovi fotogrammi per ogni blocco. NVIDIA ha distribuito anche una variante specificamente addestrata per operare con due passaggi di denoising, più rapida ma caratterizzata da una qualità visiva inferiore. L’inferenza in streaming è accelerata da FlashDreams, mentre un modulo FadeMem adattato gestisce la crescita della cache durante le generazioni prolungate.
Il materiale clinico utilizzato per la specializzazione proviene da una raccolta proprietaria di 4.792 episodi di colecistectomia, comprendenti circa 17 milioni di fotogrammi acquisiti originariamente a 60 Hz e risoluzione 1080p. Le registrazioni includono video endoscopici e telemetria del robot durante interventi teleoperati da chirurghi, mentre le informazioni sulla visibilità degli strumenti sono state annotate manualmente. La selezione dei segmenti ha privilegiato intervalli nei quali risultavano visibili e operativi esattamente due strumenti, con una pinza Cadiere a sinistra e un uncino monopolare a destra, escludendo i segmenti caratterizzati da movimenti della telecamera superiori a una soglia prestabilita. Il dataset di addestramento effettivamente utilizzato comprende 64 registrazioni e circa 526 minuti unici di video, mentre la validazione su dati esclusi dall’addestramento copre circa 10,6 minuti provenienti da dieci registrazioni. Le prove comprendono casi di qualità visiva, verifiche del controllo tramite azioni, variazioni della rotazione degli strumenti e sequenze continue di 30,4 secondi, necessarie a osservare la stabilità delle generazioni nel tempo.
Sul piano prestazionale, NVIDIA dichiara una velocità di 30 fotogrammi al secondo a 832 × 480 pixel con quattro passaggi di diffusione su RTX PRO 6000 Blackwell Workstation Edition, che sale a 43,2 fotogrammi con la variante a due passaggi. La RTX PRO 6000 Max-Q raggiunge rispettivamente 20,2 e 31,2 fotogrammi al secondo, mentre DGX Spark produce 16,9 fotogrammi al secondo alla risoluzione ridotta di 512 × 288 pixel. L’esecuzione interattiva è stata verificata su una singola RTX PRO 6000 e su DGX Spark, con compatibilità dichiarata anche per H100 e per le architetture NVIDIA Blackwell e Hopper. Il software richiede Linux, una GPU CUDA, Python 3.12 e, alla risoluzione predefinita, oltre 32 GB di memoria video. Il repository distribuito con licenza Apache 2.0 permette di riprodurre azioni registrate producendo video MP4 e di controllare il simulatore tramite visori compatibili WebXR e due controller tracciati. I pesi del modello sono disponibili secondo la NVIDIA Open Model License, per impieghi commerciali e non commerciali.
La documentazione include inoltre procedure per adattare il sistema a nuovi dataset e robot mediante fine-tuning del teacher e distillazione Self-Forcing, purché siano disponibili registrazioni video sincronizzate e rappresentazioni delle azioni coerenti con quelle utilizzate durante l’addestramento. Restano tuttavia limitazioni sostanziali: un’elevata plausibilità visiva non dimostra la correttezza biomeccanica della simulazione, le deformazioni dei tessuti possono accumulare errori durante sequenze prolungate e la risposta ai comandi deve essere valutata separatamente dalla qualità delle immagini. Tra le attività di ricerca previste figurano la simulazione dell’intera colecistectomia con criteri verificabili di completamento, l’integrazione con simulatori numerici, il supporto a ulteriori strumenti chirurgici e la valutazione da parte di chirurghi. Il modello non anonimizza automaticamente eventuali dati personali o sanitari presenti nei contenuti forniti in ingresso, che devono quindi essere utilizzati nel rispetto delle autorizzazioni e delle condizioni di trattamento applicabili.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)