
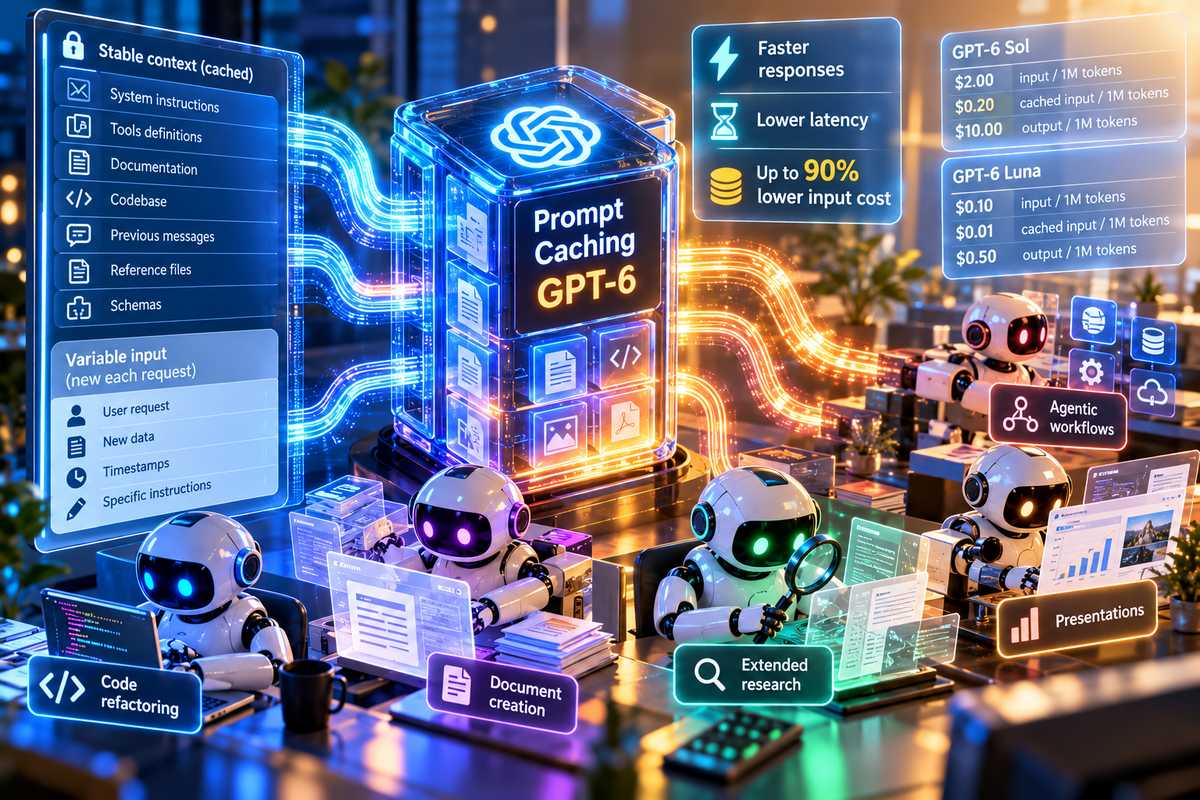
OpenAI ha potenziato il sistema di prompt caching della famiglia GPT-6 per rendere più efficienti soprattutto gli agenti AI che lavorano per periodi prolungati e inviano numerose richieste API mantenendo una grande quantità di contesto invariato. Il meccanismo permette di riutilizzare il lavoro già effettuato dal modello quando richieste successive condividono lo stesso prefisso del prompt, evitando di ricalcolare ogni volta istruzioni, definizioni degli strumenti, messaggi precedenti, documenti di riferimento e altre parti stabili del contesto. Il vantaggio diventa particolarmente rilevante in attività come refactoring di codebase, ricerche estese, produzione di documenti o presentazioni e workflow agentici che possono durare ore e nei quali lo stesso insieme di istruzioni e dati viene trasmesso ripetutamente al modello. Quando un prefisso già elaborato viene recuperato dalla cache, OpenAI applica ai relativi token di input una tariffa ridotta che può arrivare a uno sconto del 90% rispetto al normale costo dell’input, riducendo contemporaneamente il tempo necessario prima dell’avvio della risposta. Con GPT-6 il comportamento predefinito è stato modificato per aumentare la probabilità di ottenere un cache hit senza richiedere una gestione manuale complessa da parte dello sviluppatore: i prefissi condivisi idonei possono essere riutilizzati quando vengono richiamati entro almeno 30 minuti dall’ultima scrittura o dall’ultimo utilizzo della cache, mentre il sistema continua a occuparsi automaticamente del routing delle richieste verso le macchine sulle quali sono presenti gli stati intermedi necessari. Questi stati non consistono nella memorizzazione del testo del prompt, ma nei tensori key-value calcolati dal modello durante l’elaborazione, che possono essere riutilizzati soltanto quando il prefisso renderizzato della nuova richiesta corrisponde a quello precedentemente memorizzato.
Per permettere agli sviluppatori di capire quanto efficacemente questo meccanismo venga utilizzato, OpenAI ha introdotto anche strumenti specifici di osservabilità. Il nuovo Prompt Caching Dashboard mostra quale percentuale dell’input complessivo dell’applicazione viene servita attraverso la cache, permette di seguire nel tempo l’andamento del cache hit rate e confronta i token elaborati attraverso prefissi già memorizzati con quelli che devono essere calcolati nuovamente. In questo modo diventa possibile individuare rapidamente un calo improvviso dell’efficienza e capire se una modifica dell’applicazione abbia alterato la parte iniziale del contesto condiviso. A questo si aggiunge Prompt Cache Diagnostics, uno strumento che confronta richieste recenti e individua le cause dei cache miss, segnalando per esempio variazioni del modello utilizzato, delle definizioni o dell’ordine degli strumenti, delle relative descrizioni e degli schemi, della configurazione, del service tier oppure della chiave di caching. La diagnostica consente inoltre di stimare quanti token siano stati interessati dalla mancata riutilizzazione, fornendo quindi indicazioni concrete per correggere l’applicazione. La regola di base rimane che il prefisso deve essere identico fino al punto che si intende riutilizzare: modificare istruzioni iniziali, tool schema, formati di output o altri parametri che incidono sul contesto renderizzato può impedire l’utilizzo della cache dalla prima differenza in poi. Per questo OpenAI raccomanda di collocare nella parte iniziale del prompt le informazioni più stabili, mantenere intatta la cronologia delle conversazioni quando possibile e aggiungere invece alla fine le informazioni variabili come timestamp, dati specifici dell’utente o nuove istruzioni operative, evitando di riscrivere retroattivamente il contesto già utilizzato.
GPT-6 introduce inoltre un controllo più preciso sui punti nei quali creare la cache. Oltre alla modalità implicita, nella quale OpenAI seleziona automaticamente i breakpoint più adatti, gli sviluppatori possono utilizzare breakpoint espliciti per indicare quali porzioni del contesto debbano essere considerate riutilizzabili, concentrando per esempio la cache su istruzioni di sistema applicative, grandi documenti di riferimento o definizioni di strumenti che resteranno stabili per molte richieste. Ogni richiesta può creare fino a quattro scritture di cache e la modalità implicita utilizza uno di questi slot, lasciandone altri disponibili per eventuali breakpoint espliciti. Una novità particolarmente utile nei workflow agentici riguarda anche il ragionamento: nei modelli GPT-6 è possibile modificare il livello di reasoning durante una conversazione tramite un elemento configuration_update, passando per esempio da un livello basso per operazioni semplici a uno più elevato per passaggi complessi senza riscrivere la parte precedente del contesto e senza invalidare il prefisso già memorizzato. La stessa logica viene applicata agli strumenti. OpenAI raccomanda di mantenere il più possibile costanti nomi, descrizioni, schemi e ordine dei tool e, quando un determinato strumento non serve per una singola richiesta, di non rimuoverlo dalla definizione generale: è preferibile limitarne temporaneamente l’utilizzo attraverso allowed_tools oppure impostare tool_choice su none. Gli strumenti necessari soltanto in fasi successive possono anche essere caricati dinamicamente attraverso tool search e defer_loading, appendendoli al contesto invece di modificare ciò che è già presente nella parte iniziale e preservando così una porzione più ampia del prefisso riutilizzabile.
Un’altra funzione introdotta per ridurre la latenza iniziale è il prewarm della cache, disponibile sui modelli GPT-5.6 e successivi e quindi utilizzabile anche con GPT-6. Attraverso l’opzione prompt_cache_options.prewarm un’applicazione può inviare in anticipo a OpenAI il contesto che sa di dover riutilizzare, come istruzioni condivise, definizioni degli strumenti o materiale di riferimento, chiedendo al sistema di preparare la cache senza generare una risposta. Quando l’utente invia successivamente la prima richiesta reale con lo stesso prefisso, una parte significativa del lavoro è già stata elaborata e il tempo necessario per iniziare la generazione può quindi diminuire. OpenAI combina questa possibilità con un comportamento automatico pensato per funzionare anche senza configurazioni specifiche, lasciando però agli sviluppatori la possibilità di intervenire in modo dettagliato sui workload più complessi. L’aggiornamento accompagna il lancio di GPT-6 Sol e GPT-6 Luna del 22 settembre 2026: per GPT-6 Sol il prezzo standard indicato da OpenAI è di 2 dollari per milione di token di input, 0,20 dollari per milione di token di input già presenti in cache e 10 dollari per milione di token di output, mentre GPT-6 Luna costa rispettivamente 0,10 dollari, 0,01 dollari e 0,50 dollari per milione di token. La differenza di dieci volte tra input normale e cached input mostra direttamente l’impatto economico che il prompt caching può avere nei sistemi che ripetono grandi quantità di contesto, soprattutto quando agenti e applicazioni mantengono sessioni prolungate, numerosi strumenti e documenti molto estesi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)