
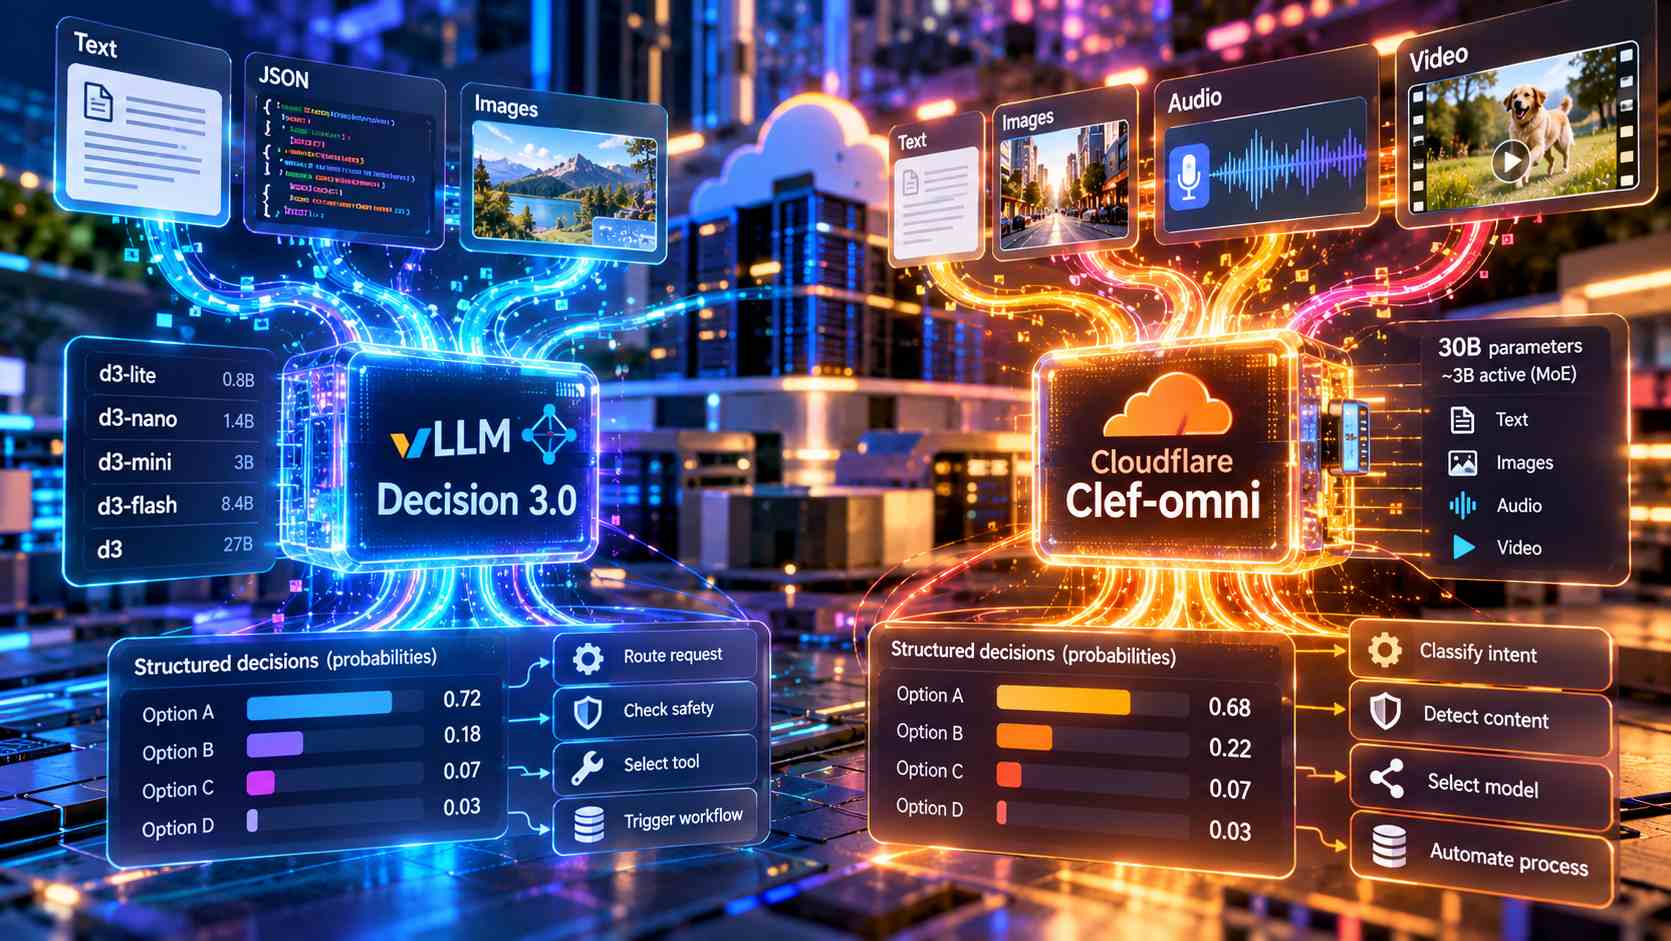
Il gruppo di sviluppo di vLLM Semantic Router e Cloudflare hanno presentato due nuove famiglie di modelli dedicati all’elaborazione di decisioni strutturate attraverso input multimodali. L’11 ottobre 2026 il team di vLLM Semantic Router ha pubblicato Decision 3.0, una serie di cinque modelli open source in grado di analizzare testo, dati JSON e immagini, mentre il 9 ottobre Cloudflare ha introdotto Clef-omni, progettato per elaborare anche audio e video. Entrambi i sistemi si distinguono dai tradizionali modelli linguistici generativi per la modalità di produzione dei risultati: anziché costruire una lunga risposta in linguaggio naturale, restituiscono probabilità associate a opzioni prestabilite, utilizzabili direttamente dalle applicazioni. L’obiettivo è consentire ai software di classificare richieste, selezionare strumenti o modelli, verificare condizioni di sicurezza e prendere decisioni operative mediante un’interfaccia con risultati strutturati.
Decision 3.0 comprende cinque configurazioni denominate d3-lite, d3-nano, d3-mini, d3-flash e d3, con dimensioni comprese fra circa 800 milioni e 27 miliardi di parametri. La famiglia deriva da modelli Qwen di Alibaba sottoposti a fine-tuning per le attività decisionali. Le quattro varianti più contenute comprendono configurazioni fino a circa 8,4 miliardi di parametri, mentre il modello principale d3 utilizza circa 26 miliardi di parametri. Tutti i modelli sono distribuiti tramite Hugging Face con licenza Apache 2.0, che permette l’utilizzo e la modifica del software nel rispetto delle condizioni previste. La principale innovazione rispetto alle precedenti generazioni consiste nell’integrazione di un encoder visivo in ogni variante, così da consentire l’analisi diretta delle immagini senza dover introdurre obbligatoriamente una fase preliminare di riconoscimento ottico dei caratteri o descrizione testuale.
Il sistema supporta immagini PNG, JPEG e WebP fino a circa 1,6 milioni di pixel e permette di includere più immagini nella stessa richiesta. Un’applicazione può quindi sottoporre al modello una schermata di un’interfaccia, un documento acquisito come immagine oppure un’infografica, accompagnando l’input con domande a risposta binaria, opzioni multiple o criteri di valutazione. Il risultato viene espresso attraverso distribuzioni di probabilità relative alle possibili risposte, che il programma può utilizzare direttamente per attivare istruzioni condizionali. Ogni domanda richiede una propria elaborazione forward, per cui il carico computazionale cresce con il numero delle valutazioni richieste. La modalità operativa elimina tuttavia la necessità di generare una risposta verbale e di sottoporla successivamente a un parser, riducendo i passaggi presenti nelle pipeline di classificazione e routing.
Nelle valutazioni interne comunicate dal gruppo vLLM, il modello d3 ha ottenuto 64,1 punti nei test testuali e 71,6 punti nelle prove visive, superando Perplexity Decider v1.1 nei confronti indicati. La variante d3-flash, caratterizzata da circa nove miliardi di parametri, ha inoltre superato nelle valutazioni testuali un modello della generazione precedente con circa 27 miliardi di parametri. Le prove riguardano capacità di classificazione e selezione delle risposte, non la qualità generale della generazione di testi o l’efficacia di un agente autonomo completo. I risultati permettono di confrontare configurazioni con dimensioni differenti, ma rimangono valutazioni comunicate dagli sviluppatori e richiedono ulteriori verifiche in contesti operativi eterogenei.
Cloudflare ha sviluppato Clef-omni utilizzando un’architettura mixture-of-experts composta complessivamente da 30 miliardi di parametri, dei quali circa tre miliardi vengono attivati durante la singola inferenza. Il modello è distribuito con pesi aperti attraverso Hugging Face e può essere eseguito anche su infrastrutture controllate direttamente dagli sviluppatori. La caratteristica principale consiste nella possibilità di fornire in un’unica richiesta informazioni testuali, immagini, tracce audio e video, ottenendo probabilità relative alle risposte richieste. Non è quindi necessario costruire obbligatoriamente una catena separata di trascrizione vocale, estrazione dei fotogrammi, generazione di didascalie e analisi del testo ricavato. Clef-omni utilizza direttamente le rappresentazioni dei differenti input per valutare le condizioni definite dall’applicazione.
Nell’ambiente Cloudflare Workers AI, ogni richiesta a Clef-omni può comprendere fino a quattro immagini, quattro clip audio e due video, con un massimo di 64 domande. Le misurazioni presentate da Cloudflare indicano una latenza mediana di circa 130 millisecondi per gli input testuali e 150 millisecondi per quelli visivi, mentre una clip video di 21 secondi comprendente audio è stata analizzata in circa 1,5 secondi. Nei benchmark dedicati al riconoscimento dell’intenzione dell’utente, il modello ha registrato un macro-F1 del 94,8% su BANKING77 e del 97,7% su CLINC150+OOS. Si tratta di misure che descrivono il comportamento nelle rispettive condizioni di valutazione e non garantiscono tempi o accuratezze equivalenti per richieste di dimensioni, complessità o distribuzione differenti.
Le prestazioni risultano meno elevate in alcuni benchmark che richiedono ragionamento complesso e gestione articolata dei workflow. Clef-omni ha ottenuto 47,4 punti in GPQA Diamond, rispetto ai 78,3 attribuiti al modello di confronto Zeb, e in alcune valutazioni di ragionamento e organizzazione delle attività ha mostrato risultati inferiori rispetto alla precedente versione di Clef. Le differenze indicano che la capacità di interpretare più modalità di input e quella di risolvere problemi complessi devono essere misurate separatamente. Le due famiglie si rivolgono soprattutto alle applicazioni nelle quali un modello deve produrre una decisione controllabile, come l’assegnazione di una richiesta al sistema appropriato, il rilevamento di contenuti potenzialmente non conformi, la classificazione di schermate o la selezione di un percorso operativo all’interno di una pipeline di agenti AI.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)