
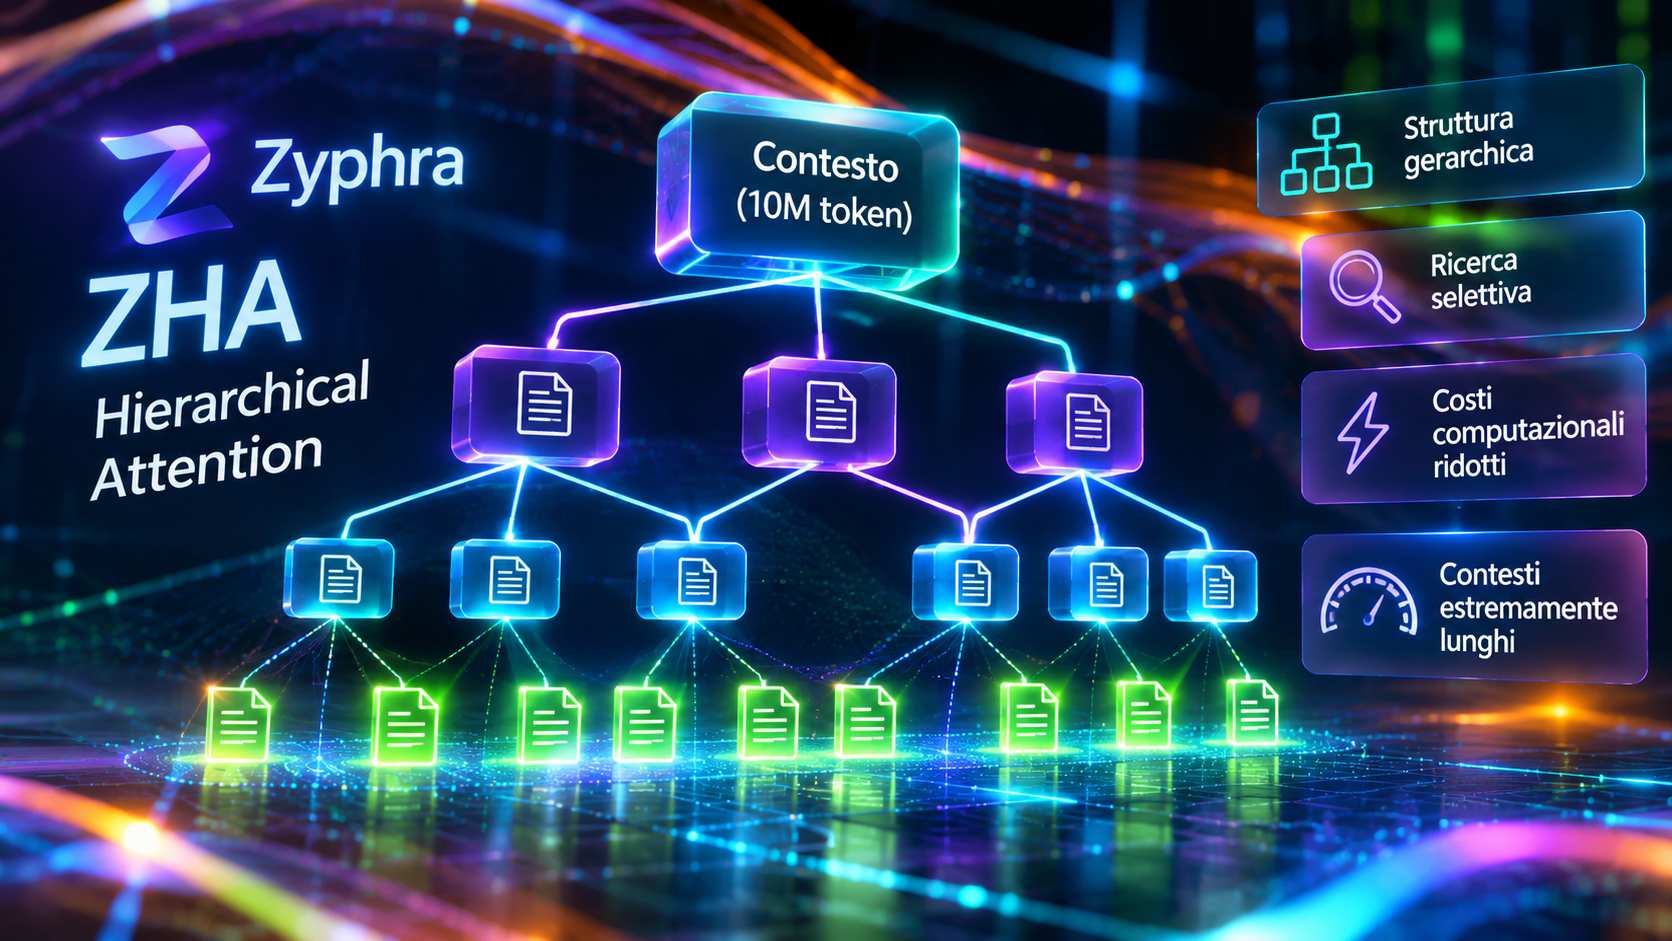
Zyphra ha presentato Zyphra Hierarchical Attention, denominata ZHA, una nuova architettura di attenzione sparsa progettata per ridurre il costo computazionale dell’elaborazione di contesti estremamente lunghi nei modelli linguistici. Il lavoro, pubblicato inizialmente il 30 ottobre 2026 e aggiornato il 2 novembre, introduce un sistema di indicizzazione gerarchica che permette di individuare le informazioni rilevanti senza esaminare sistematicamente tutti i token precedenti a ogni operazione. La soluzione affronta uno dei principali limiti dell’attenzione tradizionale dei transformer, il cui costo computazionale durante l’elaborazione completa di una sequenza cresce quadraticamente rispetto alla lunghezza del contesto. In presenza di milioni di token, le operazioni necessarie per calcolare le relazioni tra le rappresentazioni linguistiche diventano particolarmente onerose, mentre la generazione di nuovi token richiede comunque di confrontare le nuove interrogazioni con una quantità crescente di informazioni memorizzate. Zyphra propone di intervenire non soltanto sul numero di elementi selezionati, ma anche sul costo della procedura utilizzata per individuare tali elementi.
L’architettura ZHA organizza la memoria del contesto in una struttura ad albero, costruita attraverso livelli successivi di compressione delle rappresentazioni delle chiavi presenti nella cache KV. Le informazioni originali vengono suddivise in unità, dalle quali vengono ricavate rappresentazioni sintetiche; queste sono successivamente aggregate in nodi di livello superiore, creando una gerarchia che descrive porzioni progressivamente più ampie del contesto. Quando il modello deve elaborare una nuova interrogazione, il sistema attraversa l’albero a partire dai livelli superiori, identifica i rami maggiormente pertinenti e concentra l’attenzione sulle informazioni contenute nei nodi selezionati. Il procedimento evita di effettuare una ricerca completa su tutte le chiavi disponibili e permette di recuperare soltanto una frazione della cache KV, mantenendo accessibili le rappresentazioni originali. La profondità dell’albero può essere aumentata in funzione della lunghezza della sequenza, consentendo di contenere la crescita dei costi di instradamento anche quando la memoria contestuale raggiunge dimensioni molto elevate.
Il contributo tecnico consiste soprattutto nella riduzione della complessità della fase di ricerca. Diverse tecnologie di sparse attention permettono già di limitare il numero di token sui quali viene calcolata direttamente l’attenzione, ma alcune richiedono comunque operazioni di selezione il cui costo cresce rapidamente con la dimensione del contesto. ZHA introduce un indicizzatore gerarchico che, aumentando progressivamente la profondità della struttura, consente una crescita sublineare del costo di ricerca rispetto alla lunghezza della sequenza. Considerando l’intera elaborazione, comprendente indicizzazione, instradamento e attenzione sui token recuperati, il metodo presenta una complessità subquadratica. Questo comportamento è particolarmente rilevante per applicazioni che richiedono di conservare e consultare cronologie operative estese, grandi raccolte documentali o informazioni prodotte da agenti che eseguono numerosi passaggi consecutivi. Il sistema può inoltre ampliare dinamicamente la porzione di contesto recuperata quando una richiesta richiede di combinare informazioni distribuite, invece di limitarsi alla ricerca di un singolo elemento.
Zyphra ha sviluppato un modello prestazionale basato sulle caratteristiche delle GPU NVIDIA H100, considerando capacità computazionale e larghezza di banda della memoria. Nelle simulazioni relative a un contesto di dieci milioni di token, ZHA ha mostrato un’accelerazione stimata compresa tra 32 e 35 volte rispetto all’attenzione densa tradizionale e tra 4,7 e 5,1 volte rispetto a MiniMax Sparse Attention. Il vantaggio previsto aumenta con l’estensione del contesto, poiché la ricerca gerarchica evita una parte crescente delle operazioni richieste dai metodi che devono esaminare numerose chiavi prima di selezionare quelle rilevanti. Questi risultati devono tuttavia essere distinti dalle misurazioni effettuate su implementazioni operative: le accelerazioni massime sono state ricavate da un modello teorico di prestazione e non da benchmark end-to-end eseguiti su kernel ottimizzati. Al momento della pubblicazione, Zyphra non aveva ancora messo a disposizione un’implementazione completamente ottimizzata che permettesse di verificare sperimentalmente il guadagno di velocità massimo dichiarato.
Sul fronte dell’accuratezza, la tecnologia è stata sperimentata anche come modifica applicabile a modelli già pre-addestrati, mantenendo invariati i pesi principali. L’adattamento utilizza una fase di distillazione con regolarizzazione basata sulla divergenza Kullback-Leibler, in modo da avvicinare il comportamento della nuova architettura a quello del modello originale. La sperimentazione descritta comprende un processo di addestramento dell’ordine di alcuni miliardi di token e richiede soltanto 81.920 parametri aggiuntivi. Applicando ZHA a Qwen3.6-35B-A3B, i ricercatori hanno mantenuto prestazioni confrontabili con quelle dell’attenzione tradizionale in diversi compiti di ricerca documentale, ragionamento, matematica e programmazione agentica. Su LongBench v2, l’accuratezza è passata dal 58% del modello originale al 63,4% della versione modificata, nonostante fosse stato consultato soltanto circa l’1,1% della cache KV disponibile. Su SWE-bench Verified entrambe le configurazioni hanno raggiunto il 67,4%, indicando che la riduzione dell’attenzione non ha comportato una diminuzione misurabile delle prestazioni nel benchmark di sviluppo software considerato.
L’adattamento non ha tuttavia prodotto risultati uniformi su tutte le architetture. Nei test con NVIDIA Nemotron 3.5 Lightning, l’applicazione di ZHA ha causato una riduzione dell’accuratezza sul benchmark RULER dedicato al recupero di informazioni in contesti lunghi. Nelle configurazioni con alberi particolarmente profondi, la perdita ha raggiunto 25,3 punti percentuali rispetto all’attenzione originale, evidenziando la dipendenza delle prestazioni dalla struttura del modello e dalle modalità di costruzione dell’indice. I ricercatori hanno esaminato anche configurazioni con alberi fino a sei livelli, ottenendo risultati che indicano una buona robustezza generale del metodo, ma non una garanzia di equivalenza per qualsiasi modello pre-addestrato. ZHA si presenta quindi come un’architettura capace di modificare il rapporto tra dimensione del contesto e costo di recupero delle informazioni, con risultati sperimentali incoraggianti sulla qualità delle risposte e potenziali accelerazioni rilevanti. La verifica del comportamento in produzione richiederà ulteriori implementazioni, misurazioni dirette della latenza e valutazioni specifiche sui modelli destinati a utilizzare finestre contestuali molto estese.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)