
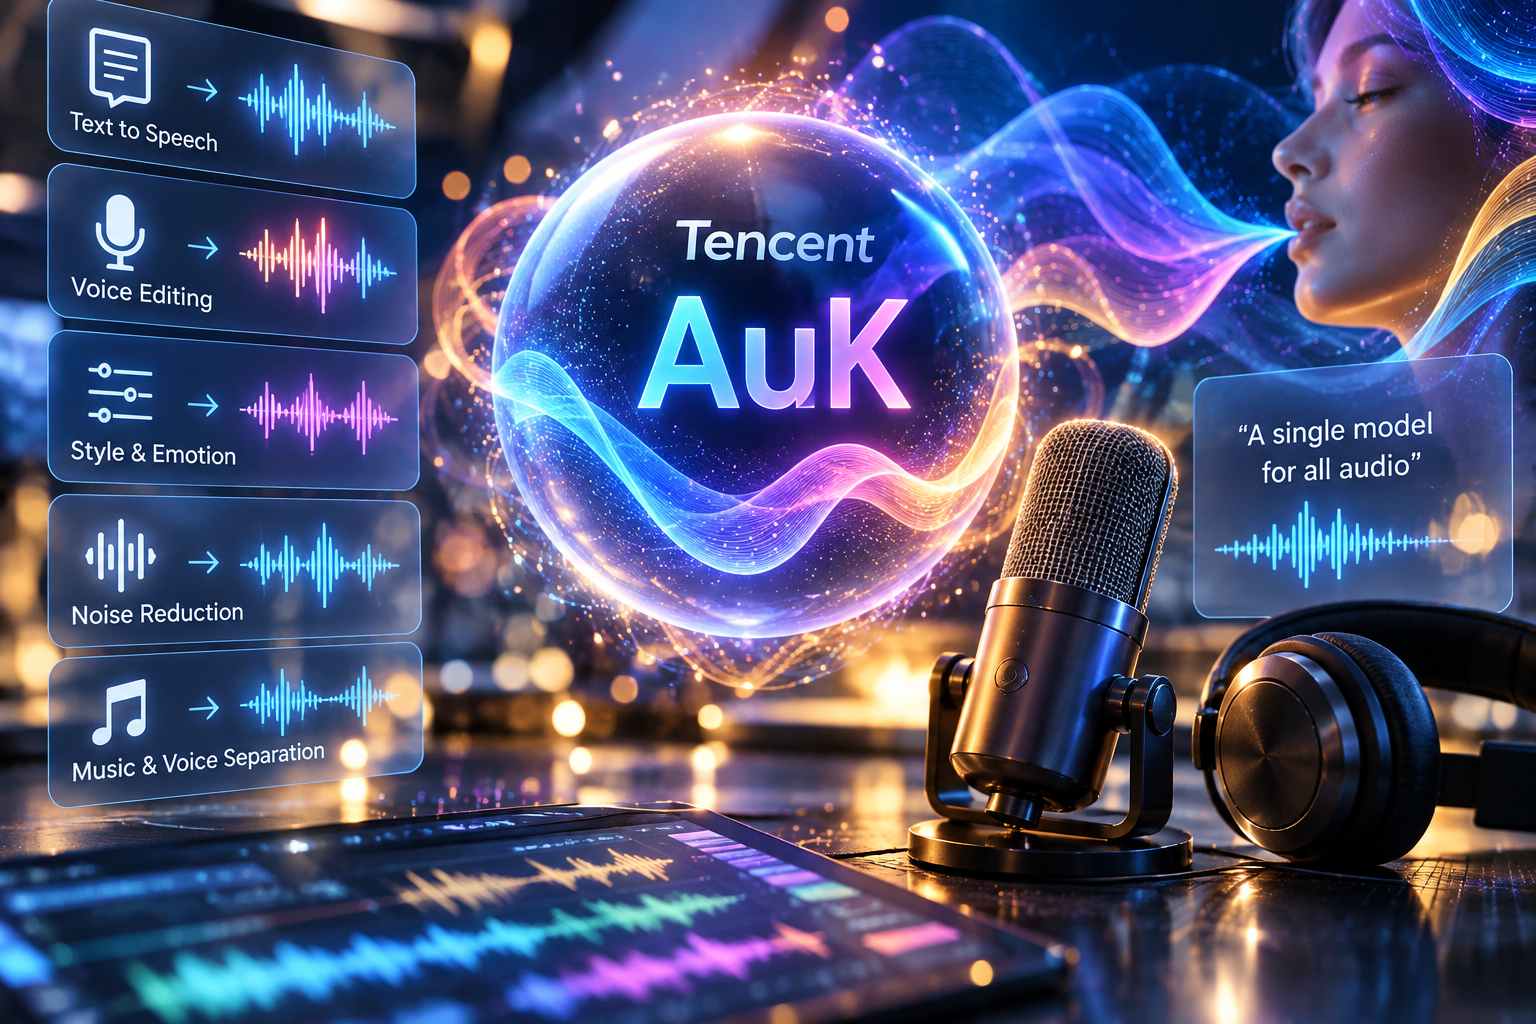
Tencent ha presentato AuK, modello foundation open source progettato per riunire in un unico sistema la generazione e la modifica dell’audio. Il modello può trasformare testo in voce, generare parlato sulla base di istruzioni e riferimenti vocali e intervenire direttamente su contenuti audio già esistenti attraverso comandi in linguaggio naturale. L’obiettivo è sostituire workflow che normalmente richiedono strumenti separati per sintesi vocale, editing, miglioramento della qualità e trasformazione dello stile con una sola architettura capace di gestire tutte queste operazioni.
AuK supporta zero-shot text-to-speech, generazione controllata tramite istruzioni e creazione di nuove frasi utilizzando una voce di riferimento fornita dall’utente. Il modello può inoltre modificare registrazioni esistenti intervenendo sul contenuto, sul timbro, sullo stile e sull’espressione emotiva. Le operazioni disponibili comprendono inserimento, eliminazione e sostituzione di parole o porzioni di parlato, modifica dell’intonazione, rimozione di accenti regionali, conversione verso una pronuncia più standard, regolazione della velocità e dell’altezza della voce e trasformazione del parlato in modalità sussurrata.
Una delle funzioni principali riguarda l’editing locale del contenuto. Se in una registrazione è presente una parola pronunciata in modo errato, AuK permette di correggere soltanto quella porzione attraverso un’istruzione testuale, senza dover rigenerare o registrare nuovamente l’intera frase. Lo stesso meccanismo può essere utilizzato per modificare contenuto e caratteristiche vocali preservando il resto dell’audio originale, riducendo il numero di passaggi necessari nei workflow di produzione.
Il modello non è limitato al parlato. Tencent ha integrato anche funzioni di miglioramento dell’audio, riduzione del rumore, separazione di più parlanti e separazione tra musica e voce. AuK viene quindi proposto come modello foundation per audio in senso più ampio, capace di gestire voce, suoni generici e contenuti musicali all’interno della stessa architettura.
Per il training sono stati utilizzati circa 3,03 miliardi di coppie istruzione-audio e 1,95 milioni di ore di contenuti audio. Il dataset è suddiviso in cinque gruppi principali: generazione vocale, editing del contenuto, modifica delle caratteristiche della voce, editing acustico e operazioni di miglioramento e separazione dell’audio. Tencent ha combinato dati pubblici, registrazioni proprietarie e materiale sintetico, sottoponendo i contenuti anche a verifiche basate su riconoscimento vocale e identificazione dei parlanti per controllarne la qualità.
L’architettura combina tre componenti principali. Un modello linguistico multimodale di grandi dimensioni viene utilizzato per comprendere il significato della voce e delle istruzioni, un variational autoencoder gestisce le caratteristiche di parlato, audio generale e musica, mentre un trasformatore ibrido è responsabile della generazione finale del segnale audio. Questa struttura permette di utilizzare lo stesso modello sia per la sintesi basata esclusivamente sul testo sia per le attività di editing che richiedono contemporaneamente istruzioni testuali e una traccia audio di riferimento.
Tencent ha applicato anche RLHF e tecniche di reinforcement learning. Nelle attività di modifica della voce, il sistema viene ottimizzato utilizzando preferenze umane per favorire risultati giudicati più naturali. Nella generazione vocale, invece, vengono utilizzate come segnali di ricompensa metriche legate all’accuratezza del contenuto e alla somiglianza con il parlante di riferimento. In questo modo il training interviene non soltanto sulla qualità tecnica del segnale, ma anche sulla coerenza del risultato rispetto alle istruzioni e all’identità vocale richiesta.
Accanto al modello completo è stata presentata AuK-Flash, versione alleggerita progettata per ridurre i tempi di inferenza. La variante utilizza un processo di generazione ridotto a quattro passaggi mantenendo, secondo Tencent, gran parte delle prestazioni del modello principale. Nelle stesse condizioni AuK-Flash può generare audio con una velocità circa 4,5 volte superiore rispetto alla versione completa, mantenendo risultati competitivi sia nella qualità del suono sia nell’editing vocale.
Nei test interni, Tencent indica prestazioni superiori rispetto ai modelli presi come riferimento nelle attività di zero-shot TTS, generazione vocale controllata tramite istruzioni ed editing dell’audio con linguaggio naturale. I miglioramenti più marcati vengono segnalati nella modifica del contenuto vocale, dove AuK mostra una maggiore accuratezza linguistica e una migliore capacità di seguire le richieste dell’utente. Anche AuK-Flash mantiene livelli competitivi nonostante la riduzione dei passaggi di inferenza e il maggiore throughput.
AuK e AuK-Flash sono stati entrambi distribuiti come modelli open source tramite Hugging Face. Tencent ha reso disponibili i pesi, il codice sorgente e una demo, permettendo a sviluppatori e ricercatori di utilizzare direttamente i modelli, testarli nei propri workflow o impiegarli come base per ulteriori attività di ricerca e sviluppo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)