
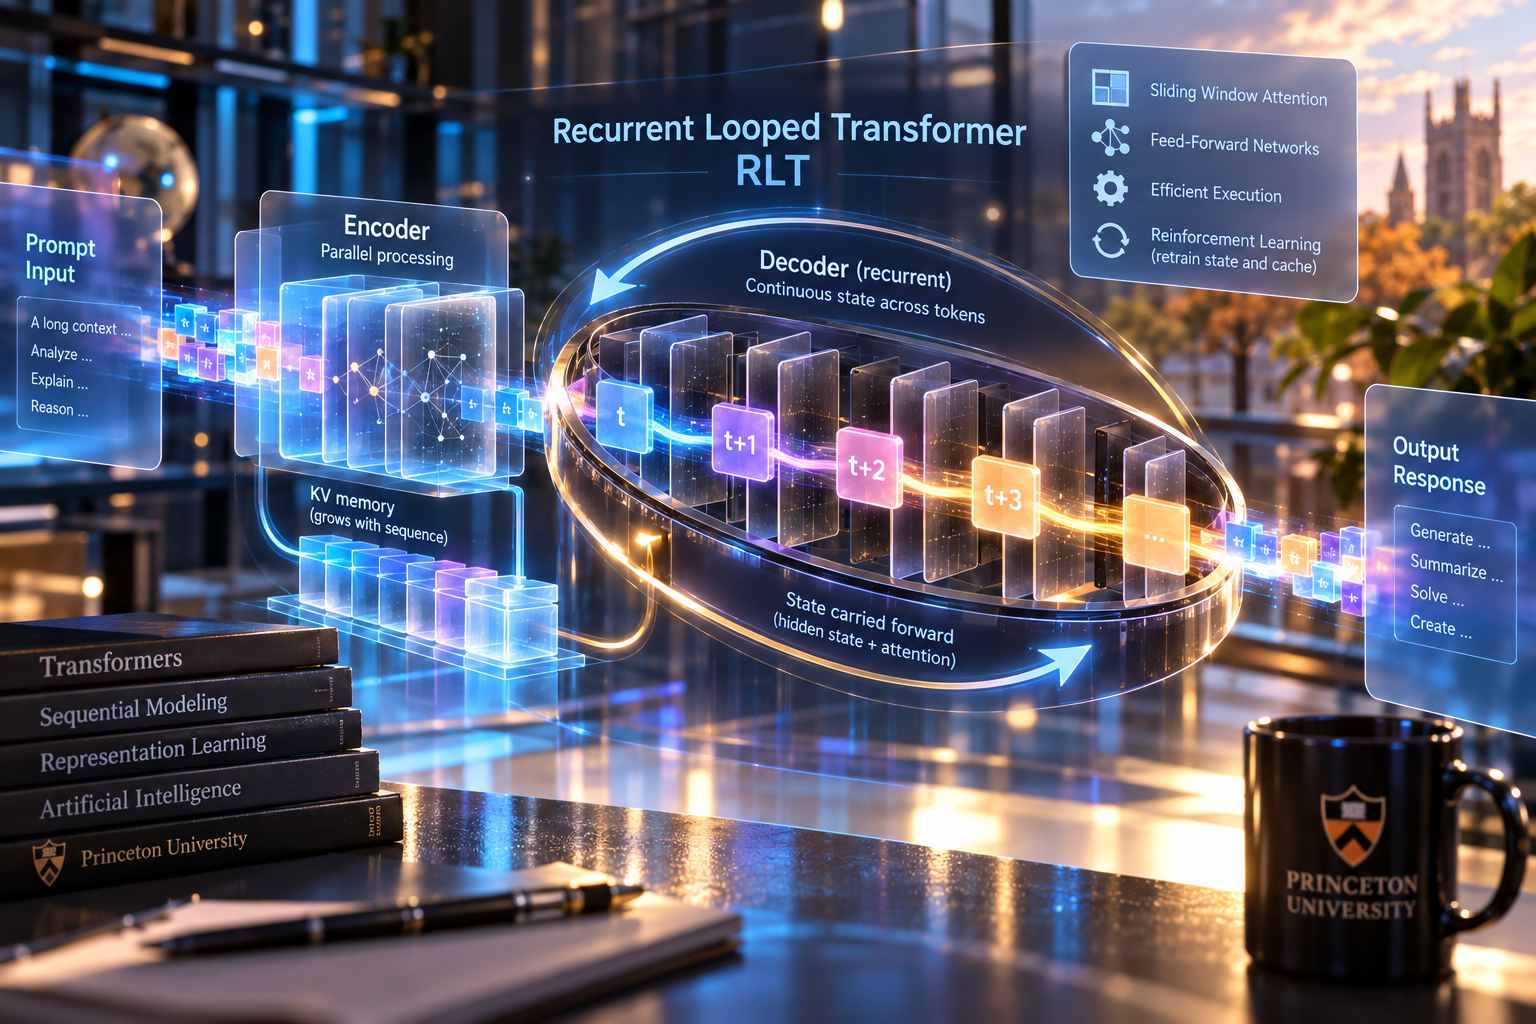
Un gruppo di ricercatori della Princeton University ha presentato Recurrent Looped Transformer, o RLT, una nuova architettura progettata per mantenere una continuità diretta tra il calcolo effettuato su un token e quello eseguito sul token successivo. Il modello è stato descritto in un lavoro pubblicato il 12 settembre e introduce una modifica sostanziale al funzionamento tipico dei Transformer autoregressivi, nei quali le informazioni precedenti vengono normalmente conservate soprattutto attraverso la KV cache e recuperate mediante il meccanismo di attenzione. In RLT, invece, anche lo stato finale del decoder viene trasferito direttamente alla fase successiva, creando una catena computazionale continua lungo l’intera sequenza.
Nei modelli decoder-only tradizionali, ogni nuovo token viene generato utilizzando le informazioni memorizzate nella KV cache, ma il risultato finale del calcolo precedente non viene necessariamente utilizzato come stato iniziale completo per il passaggio successivo. Questo può limitare la continuità delle rappresentazioni interne costruite durante l’elaborazione. Recurrent Looped Transformer modifica questo comportamento facendo proseguire direttamente lo stato nascosto finale del decoder e le informazioni di attenzione nel calcolo del token successivo, senza azzerare il processo nemmeno nel passaggio dalla fase di elaborazione del prompt alla generazione della risposta.
Il concetto centrale introdotto dai ricercatori è quello di “temporal depth”, o profondità temporale. In un Transformer convenzionale ogni token attraversa un numero fisso di layer, mentre in RLT il percorso computazionale complessivo si estende progressivamente con l’avanzare della sequenza. In un esempio basato su un modello con 48 layer nell’encoder e 48 nel decoder, l’elaborazione di t token produce un percorso del decoder equivalente a 48t passaggi concatenati. La quantità di calcolo eseguita per il singolo token non viene necessariamente aumentata, ma il sistema mantiene una catena interna più lunga, che i ricercatori descrivono come una forma di “infinite depth”.
L’architettura combina un encoder e un decoder ricorrente. L’encoder elabora in parallelo i token di input e produce una memoria KV complessiva, mentre il decoder integra le informazioni del token corrente con lo stato computazionale proveniente dal passaggio precedente. Il sistema utilizza Sliding Window Attention, o SWA, insieme a reti feed-forward e mantiene nella cache soltanto le informazioni KV relative ai token più recenti entro una finestra prestabilita. Con l’aggiunta di nuovi token, anche la memoria costruita dall’encoder viene progressivamente estesa, mantenendo quindi una rappresentazione aggiornata della sequenza in crescita.
La separazione tra elaborazione parallela dell’encoder e calcolo sequenziale del decoder è stata progettata anche tenendo conto dell’efficienza hardware. I ricercatori raggruppano le operazioni che possono essere eseguite simultaneamente, cercando di aumentare il livello di utilizzo delle risorse computazionali pur mantenendo la natura ricorrente della parte decoder. L’obiettivo è evitare che la continuità del calcolo tra token introduca automaticamente un forte peggioramento dell’efficienza di esecuzione.
Particolare attenzione è stata dedicata anche al reinforcement learning. Durante l’addestramento con RL, quando i parametri del modello vengono aggiornati, gli stati nascosti e la KV cache generati con una versione precedente dei pesi non possono essere semplicemente riutilizzati, perché non sarebbero più coerenti con il modello aggiornato. Per questo RLT rigenera da zero, a ogni aggiornamento dei parametri, lo stato computazionale e la cache relativi all’intera sequenza che comprende prompt e risposta, impedendo che rappresentazioni prodotte da versioni precedenti del modello vengano propagate nel nuovo ciclo di training.
Il lavoro non dimostra però che Recurrent Looped Transformer sia già superiore ai Transformer convenzionali in termini di velocità, qualità del ragionamento o capacità di generalizzazione. I ricercatori specificano che si tratta soprattutto di una proposta architetturale e di un nuovo schema di esecuzione. Al momento non sono stati pubblicati risultati conclusivi sulla velocità reale del sistema, sulle prestazioni di reasoning in modelli di grandi dimensioni o sul comportamento dell’architettura quando viene scalata fino ai livelli tipici degli attuali LLM.
I test effettuati evidenziano inoltre alcuni limiti nella conservazione dell’informazione su sequenze più lunghe rispetto a quelle utilizzate durante il training. Nei compiti di state tracking, l’accuratezza di RLT tende a diminuire all’aumentare della lunghezza della sequenza e una GRU utilizzata come termine di confronto mostra in alcune condizioni una generalizzazione più stabile. Questo indica che una maggiore profondità computazionale non implica automaticamente una migliore memoria a lungo termine.
Gli stessi autori sottolineano infatti che rendere più profondo il percorso del calcolo non garantisce di per sé un miglioramento delle capacità di ragionamento. Le informazioni trasferite da un token all’altro possono comunque attenuarsi lungo la catena a causa del comportamento dei gate interni e delle trasformazioni successive, con il rischio che parte dello stato precedente perda progressivamente rilevanza. La proposta RLT va quindi interpretata come un tentativo di introdurre maggiore continuità nel calcolo autoregressivo, non come una soluzione già dimostrata al problema del reasoning nei modelli linguistici.
Recurrent Looped Transformer propone in sostanza di trasformare la generazione autoregressiva da una sequenza di passaggi collegati soprattutto attraverso la cache di attenzione a un processo nel quale anche lo stato computazionale completo viene esplicitamente propagato nel tempo. Il potenziale vantaggio è la possibilità di preservare una maggiore continuità interna durante sequenze lunghe e operazioni di ragionamento articolate, ma la validità di questa impostazione dovrà essere verificata con modelli più grandi, benchmark di reasoning e misure dirette di velocità ed efficienza.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)