
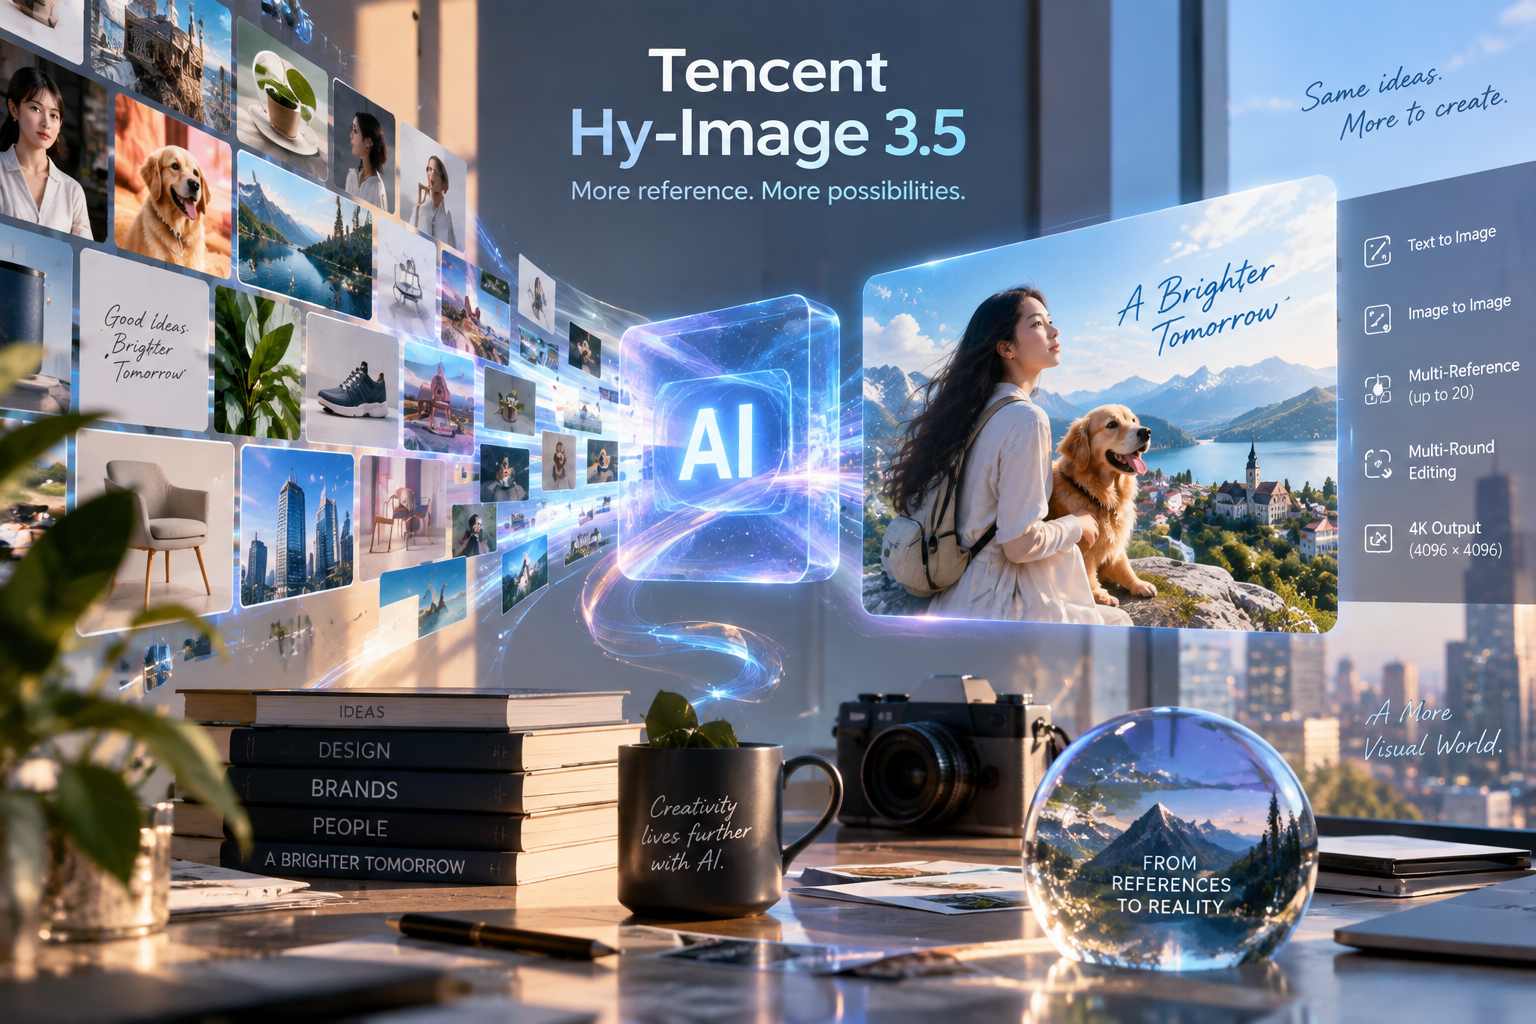
Tencent ha presentato Hy-Image 3.5, nuova versione del proprio modello per la generazione e la modifica di immagini, dichiarando un miglioramento complessivo delle prestazioni del 30% rispetto a Hy-Image 3.0 e ampliando in modo significativo le capacità destinate ai workflow visivi più complessi. Una delle modifiche principali riguarda il numero di immagini di riferimento utilizzabili contemporaneamente, passato da un massimo di tre a un massimo di 20, così da permettere al modello di mantenere con maggiore coerenza identità, abbigliamento, prodotti, elementi di marca e altri dettagli quando la generazione deve combinare numerosi riferimenti diversi all’interno della stessa composizione. Hy-Image 3.5 supporta sia text-to-image sia image-to-image e utilizza un protocollo di tipo Chat/Messages attraverso il quale è possibile fornire al modello più turni di contesto, comprese istruzioni testuali e immagini, mantenendo quindi la continuità tra una modifica e quella successiva. Tencent ha aggiunto anche l’editing multi-round, che consente di partire da un’immagine generata o fornita dall’utente e procedere con modifiche successive senza dover ricostruire ogni volta l’intero contesto, insieme alla possibilità di produrre direttamente immagini fino alla risoluzione di 4096×4096 pixel. La documentazione tecnica prevede inoltre input fino a 100.000 token, supporto a immagini PNG, JPEG e JPG fino a 20 MB ciascuna, riscrittura delle istruzioni tramite chain-of-thought, ricerca esterna di supporto e determinazione automatica delle dimensioni finali in base al prompt e alla superficie di output richiesta.
Il modello è stato sviluppato anche per gestire meglio contenuti nei quali la generazione grafica deve convivere con testo e impaginazione. Tencent indica infatti un miglioramento nella resa di testo multilingue e layout complessi, oltre alla possibilità di ottenere direttamente immagini ad alta risoluzione senza passare attraverso un ulteriore processo di upscaling. Queste caratteristiche sono pensate soprattutto per casi d’uso come poster, design di interfacce, materiali pubblicitari, immagini di prodotto e composizioni nelle quali più soggetti o riferimenti devono rimanere riconoscibili durante le iterazioni. La capacità di utilizzare fino a 20 immagini costituisce in questo senso una delle principali differenze rispetto a Hy-Image 3.0, che nella documentazione Tencent rimane limitato a un massimo di tre riferimenti e a una superficie di output molto inferiore. Hy-Image 3.5 viene inoltre distribuito come modello sincrono: una singola chiamata API restituisce il risultato finale senza richiedere la creazione di un’attività separata da interrogare successivamente, mentre il server gestisce internamente l’esecuzione in streaming fino al completamento dell’immagine. Il modello verrà integrato progressivamente nell’ecosistema Tencent, comprendendo il chatbot Yuanbao, gli strumenti di video editing e design e, più in prospettiva, i servizi legati a WeChat, piattaforma con oltre un miliardo di utenti sulla quale Tencent sta costruendo una parte della propria strategia per gli agenti AI.
Tencent ha accompagnato il lancio con una serie di valutazioni interne condotte coinvolgendo centinaia di designer dell’azienda. Secondo i risultati comunicati dalla società, Hy-Image 3.5 avrebbe raggiunto prestazioni comparabili a Seedream 5.0 Pro di ByteDance e leggermente superiori rispetto a Nano Banana Pro di Google e Qwen Image 3.0 Pro di Alibaba. I risultati devono però essere considerati come benchmark interni di Tencent e non come una valutazione indipendente, elemento particolarmente rilevante perché il confronto riguarda modelli concorrenti sviluppati da altri grandi gruppi tecnologici cinesi e internazionali. Il lancio arriva inoltre in una fase in cui Tencent sta rafforzando il proprio team AI dopo essere stata considerata meno rapida di alcuni concorrenti nello sviluppo dei grandi modelli. Nel corso del 2026 l’azienda ha assunto Yao Shunyu, ex ricercatore OpenAI, con il ruolo di chief AI scientist, affidandogli una revisione dell’infrastruttura e dei criteri di valutazione dei modelli. Yao ha indicato come priorità non soltanto l’aumento dei punteggi nei benchmark, ma soprattutto l’integrazione dei modelli all’interno di servizi reali e la loro capacità di risolvere problemi concreti degli utenti. A luglio Tencent ha inoltre reclutato Tian Yonglong, anch’egli proveniente da OpenAI e specializzato in computer vision, assegnandogli la guida dello sviluppo dei modelli vision-language all’interno del team Hunyuan.
La distribuzione iniziale di Hy-Image 3.5 avviene attraverso Miora, il design agent di Tencent, dove la versione preview può essere provata gratuitamente dal 22 settembre al 7 ottobre 2026. Il modello è disponibile anche tramite Tencent Cloud e TokenHub con l’identificativo hy-image-v3.5-preview. Nella documentazione internazionale Tencent indica per l’API un endpoint dedicato alla generazione tramite Hunyuan Image 3.5 e un sistema di input basato su messaggi, nel quale l’ultimo messaggio con ruolo utente viene interpretato come istruzione corrente mentre quelli precedenti costituiscono il contesto utilizzato per l’editing multi-turn. Il prezzo riportato da AI Times per l’utilizzo tramite API Tencent Cloud è di 0,024 dollari per immagine; la documentazione cinese di TokenHub distingue invece il consumo per risoluzione, indicando un equivalente di 0,15 yuan per immagine a 1K e 2K e di 0,20 yuan per 4K. L’introduzione di Hy-Image 3.5 è stata accompagnata anche da una forte reazione del mercato: il titolo Tencent è salito di oltre il 7% alla Borsa di Hong Kong nella giornata dell’annuncio, avvenuto in coincidenza con l’apertura di un importante evento AI di Alibaba. L’aumento è stato collegato alle aspettative su un’accelerazione della capacità di Tencent di ridurre il divario con i concorrenti e di sfruttare la propria infrastruttura di servizi, in particolare WeChat, per portare i nuovi modelli direttamente all’interno di applicazioni utilizzate su larga scala.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)