
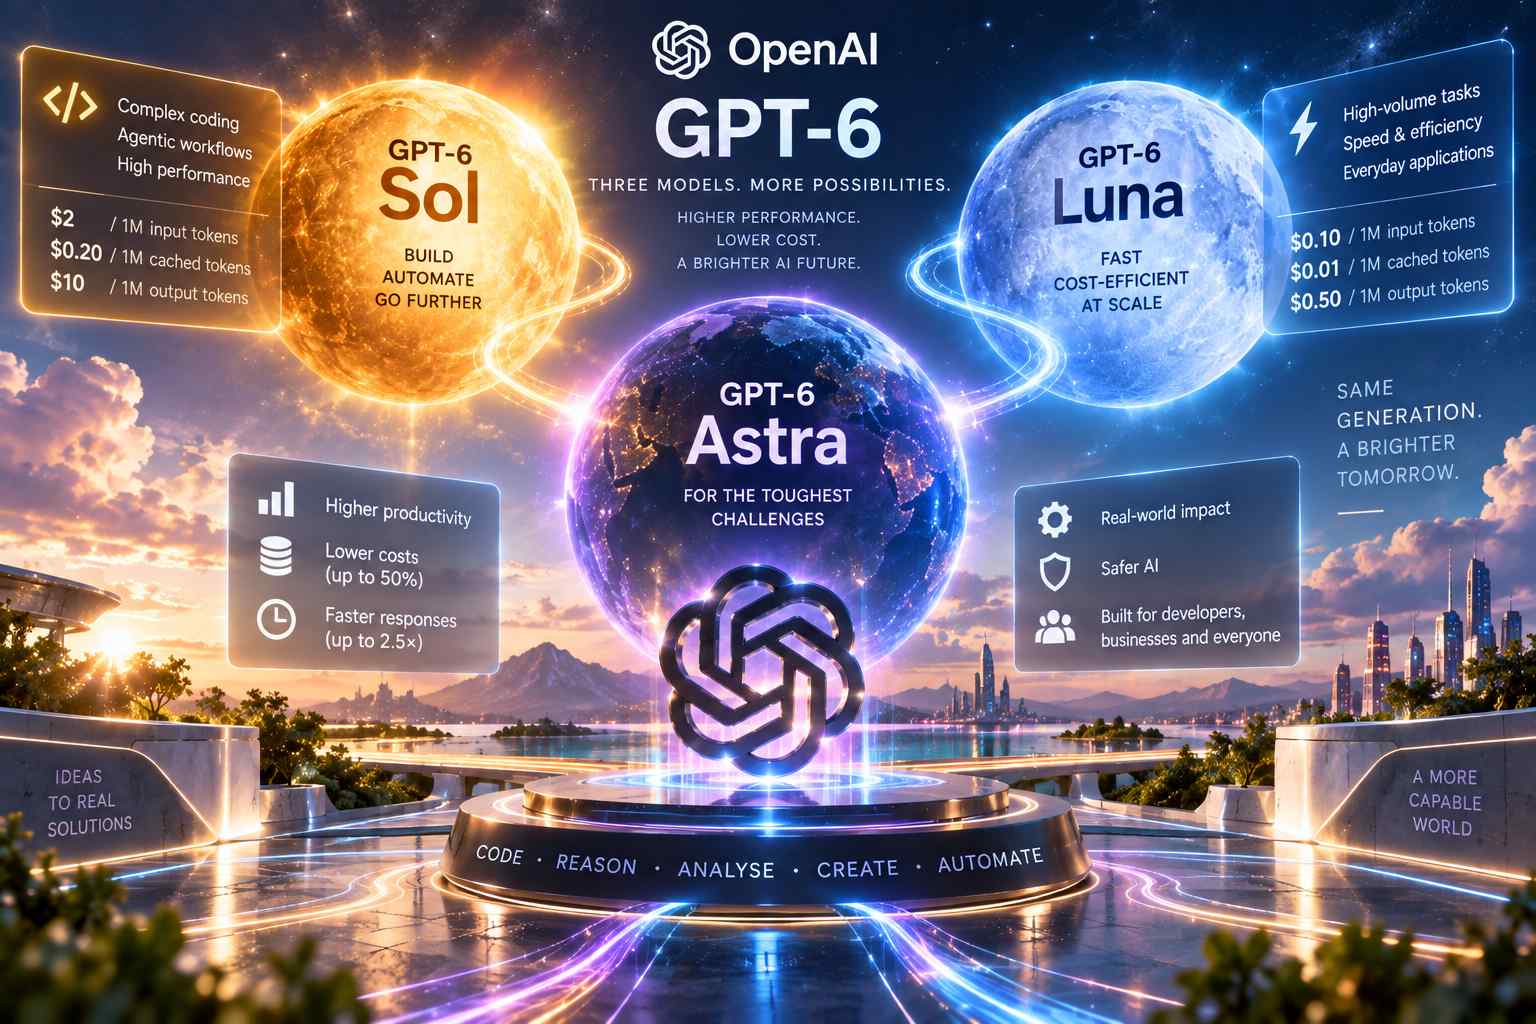
OpenAI ha introdotto GPT-6 Sol e GPT-6 Luna, ampliando la famiglia GPT-6 inaugurata a settembre con GPT-6 Astra e portando parte delle capacità del modello più avanzato verso configurazioni progettate per offrire maggiore velocità ed efficienza economica. I due nuovi modelli sono stati sviluppati utilizzando approcci simili a quelli impiegati per Astra e incorporano miglioramenti nelle attività professionali, nella factuality, nella programmazione, nell’utilizzo del computer e nell’allineamento, pur mantenendo una differenziazione precisa all’interno della gamma: Astra rimane il modello destinato ai problemi più impegnativi, Sol punta soprattutto su coding complesso e workflow agentici, mentre Luna è orientato ai carichi focalizzati e ad alto volume per i quali costo e velocità assumono un peso maggiore. OpenAI ha contemporaneamente ridotto del 50% i prezzi API di Sol e Luna rispetto ai prezzi promozionali dei corrispondenti modelli GPT-5.6, attribuendo la riduzione alle ottimizzazioni introdotte nei sistemi di caching e inferenza.
GPT-6 Sol costa 2 dollari per milione di token di input, 0,20 dollari per milione di token memorizzati nella cache e 10 dollari per milione di token di output nella modalità Standard, mentre GPT-6 Luna scende rispettivamente a 0,10, 0,01 e 0,50 dollari. Entrambi dispongono di una finestra di contesto da 1.050.000 token e possono generare fino a 128.000 token in output, accettano testo e immagini come input e producono testo, mentre non supportano direttamente audio e video. I livelli di reasoning effort possono essere regolati da “none” fino a “max”, con “medium” utilizzato come impostazione predefinita, consentendo agli sviluppatori di bilanciare quantità di ragionamento, latenza e consumo di token in funzione dell’applicazione. GPT-6 Sol ha un knowledge cutoff fissato al 20 aprile 2026, mentre per GPT-6 Luna il limite è il 18 maggio 2026. Le letture degli input già presenti nella cache costano il 10% rispetto all’input non memorizzato, mentre le scritture nella cache vengono fatturate a 1,25 volte il prezzo normale dell’input. Per prompt superiori a 272.000 token vengono inoltre applicate tariffe maggiorate all’intera richiesta: il costo dell’input e della cache raddoppia e quello dell’output viene moltiplicato per 1,5.
Una parte rilevante dei miglioramenti riguarda l’esecuzione di workflow agentici. In AutomationBench, benchmark che misura la capacità degli agenti AI di completare processi aziendali end-to-end utilizzando 47 strumenti differenti, GPT-6 Sol con reasoning effort xhigh ha ottenuto il 33,2% con un costo di 0,27 dollari per attività. Il risultato supera il 30,3% raggiunto da GPT-6 Astra con effort basso e il 31,4% ottenuto da Claude Fable 5.1 con fallback su Opus 5; OpenAI segnala inoltre che il costo attribuito a quest’ultima configurazione non comprende il ricorso al modello di fallback, verificatosi in circa il 40% delle attività. Nello stesso benchmark GPT-6 Luna, impostato su high, migliora di 5,4 punti percentuali rispetto al proprio predecessore GPT-5.6 riducendo contemporaneamente del 58% il costo per attività. Su Agents’ Last Exam, valutazione dedicata ad attività professionali di lunga durata distribuite fra 55 sotto-settori, GPT-6 Sol con effort massimo raggiunge invece il 56,4%, con un costo per attività indicato come inferiore del 60% rispetto alla migliore configurazione di Claude Opus 5 utilizzata nel confronto.
OpenAI segnala progressi anche nella factuality e nella programmazione. In una valutazione interna costruita utilizzando conversazioni de-identificate nelle quali gli utenti avevano segnalato errori del modello, GPT-6 Sol produce circa la metà degli errori del proprio predecessore, mentre GPT-6 Luna, utilizzando livelli di reasoning più elevati, raggiunge risultati paragonabili a GPT-5.6 Sol con un costo pari a circa un centesimo. OpenAI precisa tuttavia che questo insieme di conversazioni è deliberatamente concentrato sui casi problematici e non rappresenta l’utilizzo medio dei modelli, nel quale gli errori fattuali risultano meno frequenti. Nei test dedicati allo sviluppo software, FrontierCode misura invece se le modifiche prodotte dagli agenti sono sufficientemente affidabili da poter essere integrate in repository reali: GPT-6 Sol mostra un miglioramento consistente rispetto a GPT-5.6 Sol e, con effort xhigh, raggiunge risultati comparabili a Claude Fable 5.1 con un costo sensibilmente più basso.
Risultati analoghi emergono da DeepSWE v1.1, benchmark basato su attività complesse di software engineering eseguite all’interno di codebase reali. GPT-6 Sol con reasoning impostato su max raggiunge il 68,8%, a 1,1 punti percentuali dal 69,9% ottenuto dalla migliore configurazione di Claude Fable 5 inclusa nella valutazione, ma con un costo per task inferiore di circa l’80%. GPT-6 Luna con effort massimo raggiunge il 66,6%, un risultato comparabile a quelli ottenuti da Claude Opus 5 e Fable 5 con effort medio, con riduzioni del costo per attività indicate rispettivamente nel 93% e nel 96%. OpenAI ha collegato l’attenzione riservata all’efficienza di questi workload anche all’aumento del consumo interno di modelli per lo sviluppo software: valutando i token utilizzati ai prezzi API, il consumo quotidiano avrebbe superato l’equivalente di 600 dollari per il ricercatore mediano e di 7.000 dollari per i ricercatori collocati al novantesimo percentile.
I miglioramenti interessano anche l’utilizzo autonomo del computer. Nel benchmark OSWorld 2.0 offline, GPT-6 Sol con effort xhigh raggiunge il 60,5%, rispetto al 60,3% ottenuto da Claude Opus 5 con effort medio, mentre il costo per attività risulta inferiore di circa l’80%. GPT-6 Luna impostato su max supera invece GPT-5.6 Sol con effort medio consumando circa un decimo delle risorse economiche. Per questi confronti OpenAI specifica che i risultati dei propri modelli sono stati prodotti nel proprio ambiente di ricerca o attraverso le API, mentre i valori relativi ai modelli concorrenti provengono da risultati pubblicamente disponibili; nei casi in cui non erano disponibili risultati per Claude Fable 5.1 sono stati utilizzati quelli di Fable 5. Parallelamente alle prestazioni, Sol e Luna ereditano da Astra anche alcune modifiche nello stile di risposta, con formulazioni più chiare, minore utilizzo di gergo e risposte leggermente più concise, in particolare nelle conversazioni tecniche e relative alla programmazione.
Un’altra componente centrale della nuova generazione riguarda il prompt caching. OpenAI ha modificato l’infrastruttura di GPT-6 per aumentare automaticamente la probabilità di cache hit e applica uno sconto del 90% alla lettura dei token già memorizzati rispetto al normale costo dell’input. Per gli sviluppatori sono stati introdotti un Prompt Caching Dashboard per osservare il comportamento della cache, strumenti diagnostici capaci di individuare le ragioni per cui una determinata richiesta non viene riutilizzata, controlli sul reasoning effort e sull’utilizzo degli strumenti progettati per preservare parti del contesto precedente e nuovi breakpoint espliciti che permettono di definire il punto in cui termina il prefisso del prompt da memorizzare. Secondo i dati comunicati da GitHub, l’applicazione di queste ottimizzazioni a miliardi di richieste effettuate verso i modelli OpenAI negli ultimi mesi avrebbe ridotto di oltre il 50% la quota di token dei prompt che deve essere elaborata nuovamente, contribuendo a diminuire anche i tempi di risposta di GitHub Copilot.
Sul fronte dell’allineamento, GPT-6 Sol e GPT-6 Luna mostrano miglioramenti rispetto ai rispettivi modelli GPT-5.6 nelle valutazioni utilizzate da OpenAI, comprese quelle dedicate alle affermazioni fuorvianti che un modello può produrre descrivendo il lavoro di programmazione che sostiene di aver svolto. La società precisa anche in questo caso che i test sono costruiti intenzionalmente per sottoporre i sistemi a situazioni difficili e non rappresentano quindi direttamente il tasso di errore che dovrebbe emergere nell’utilizzo normale; i risultati estesi sull’allineamento sono inclusi nella system card della famiglia GPT-6 Astra. I due nuovi modelli mantengono inoltre la disponibilità attraverso le principali interfacce API OpenAI, comprese Responses API e Chat Completions API, oltre al supporto degli endpoint e degli strumenti compatibili previsti dalla piattaforma.
GPT-6 Sol e GPT-6 Luna sono disponibili dal 22 settembre 2026 attraverso le API con gli identificativi gpt-6-sol e gpt-6-luna e sono stati introdotti anche in ChatGPT Work e Codex per gli utenti Plus, Pro, Business, Enterprise ed Edu. GPT-6 Luna è inoltre accessibile agli utenti Free e Go attraverso l’app desktop. OpenAI ha scelto un rilascio progressivo all’interno di ChatGPT per mantenere stabile il servizio durante l’aumento iniziale della domanda. Con Sol e Luna, la famiglia GPT-6 viene quindi articolata su tre livelli complementari: Astra rimane destinato ai workload nei quali prevale la necessità della massima capacità disponibile, Sol concentra capacità avanzate di reasoning, coding e azione agentica in una configurazione meno costosa, mentre Luna porta la stessa generazione tecnologica verso applicazioni ad alto volume nelle quali il costo di inferenza diventa uno dei parametri principali di progettazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)