
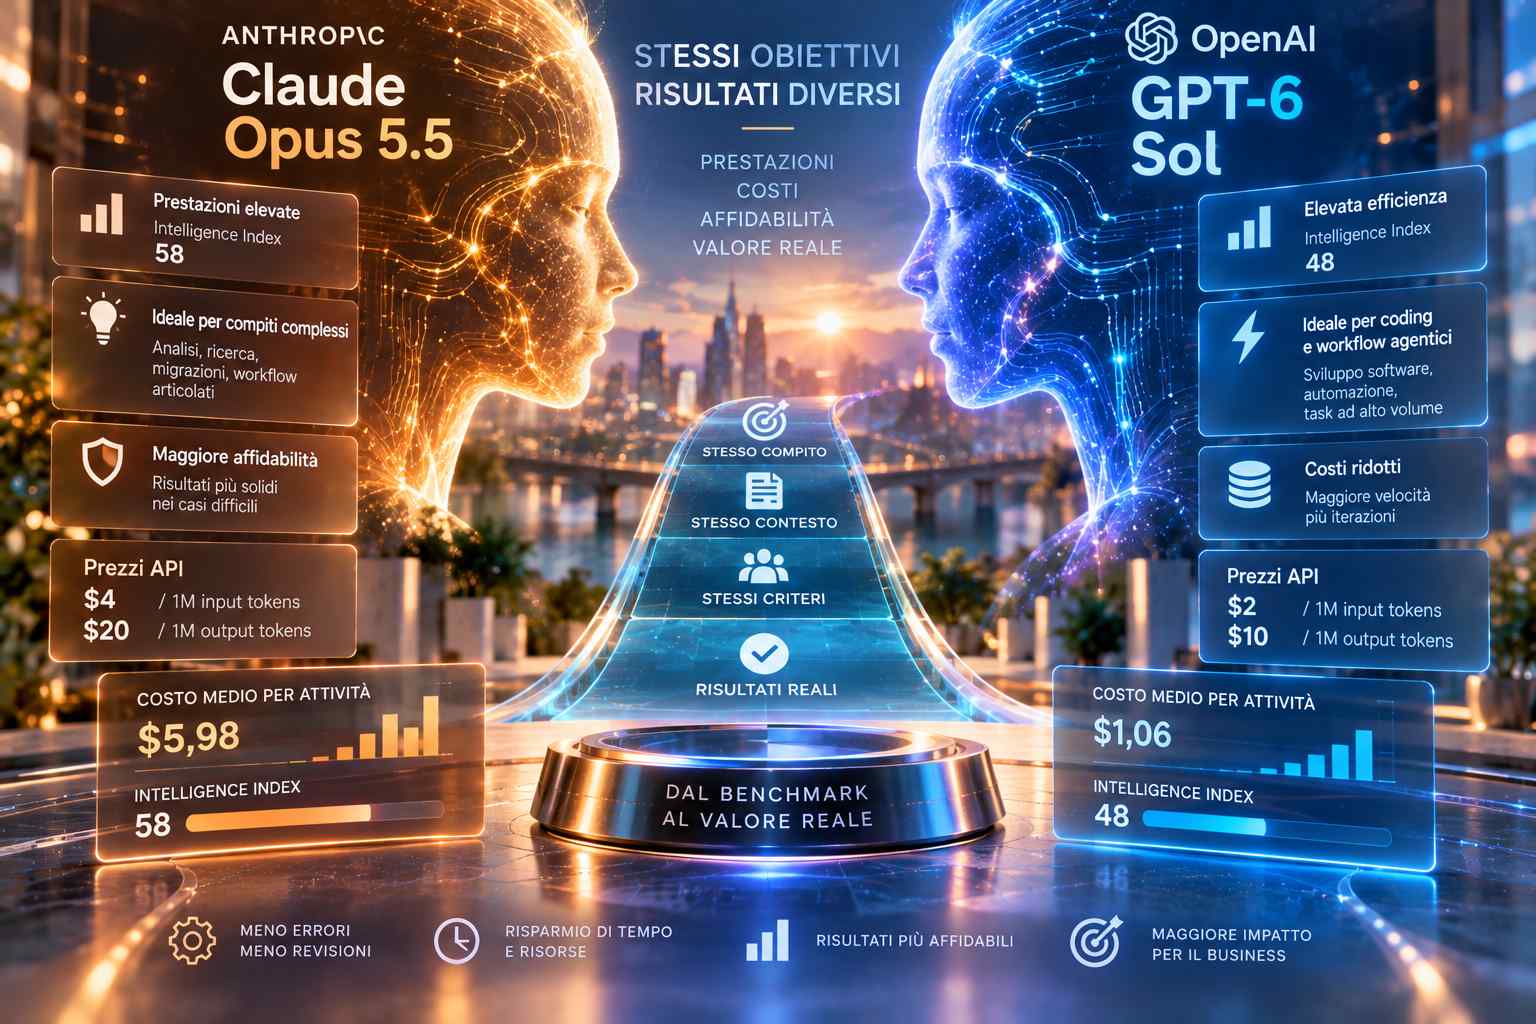
Claude Opus 5.5 e GPT-6 Sol sono arrivati entrambi il 22 settembre 2026 con un’impostazione simile: offrire capacità avanzate per attività professionali, sviluppo software e workflow agentici riducendo al tempo stesso il costo rispetto alle rispettive generazioni precedenti. Le differenze diventano però evidenti quando si confrontano prestazioni e prezzi. Anthropic propone Claude Opus 5.5 a 4 dollari per milione di token di input e 20 dollari per milione di token di output, mentre GPT-6 Sol parte da 2 dollari per milione di token in ingresso e 10 dollari per l’output nella fascia di pricing utilizzata nel confronto. A parità di volume, il modello OpenAI presenta quindi un costo nominale sensibilmente inferiore, ma in un ambiente aziendale il prezzo dei token rappresenta soltanto una parte del costo complessivo: devono essere considerate anche la quantità di revisione umana necessaria, le eventuali correzioni, il tempo perso per rifare un’attività e le conseguenze di un risultato apparentemente completo ma non sufficientemente affidabile.
Un confronto diretto arriva dall’Artificial Analysis Intelligence Index, che ha valutato entrambi i modelli utilizzando la stessa versione del benchmark. Con il livello massimo di elaborazione, Claude Opus 5.5 ha ottenuto un punteggio di 58, mentre GPT-6 Sol si è fermato a 48. La configurazione di Opus utilizzata nel test comprendeva il comportamento di fallback previsto di default. Il rapporto si inverte però considerando il costo medio necessario per completare le attività incluse nell’indice: circa 5,98 dollari per Opus 5.5 contro 1,06 dollari per GPT-6 Sol. I risultati mostrano quindi due profili piuttosto differenti all’interno dello stesso insieme di test: Opus raggiunge un punteggio complessivo più elevato, mentre Sol completa le attività con un costo medio nettamente inferiore. Il benchmark non determina però automaticamente quale configurazione sia più adatta a uno specifico processo aziendale, perché non misura direttamente elementi come il tempo impiegato da un revisore per controllare il risultato, la necessità di ripetere l’operazione o l’impatto di eventuali errori sul processo successivo.
Anche i benchmark pubblicati direttamente dalle due aziende devono essere letti tenendo conto delle configurazioni utilizzate. OpenAI ha confrontato GPT-6 Sol principalmente con Claude Opus 5, mentre Anthropic ha utilizzato GPT-5.6 Sol come termine di paragone per Opus 5.5. I risultati permettono quindi di osservare il miglioramento ottenuto dalle nuove generazioni rispetto a modelli precedenti, ma non costituiscono da soli un confronto diretto fra Opus 5.5 e GPT-6 Sol sottoposti esattamente allo stesso incarico e alle stesse condizioni. Anthropic descrive Opus 5.5 come un modello capace di raggiungere, nella maggior parte dei workload, prestazioni comparabili a Claude Fable 5.1 con costi inferiori del 40% rispetto a Opus 5, mentre OpenAI presenta GPT-6 Sol come una piattaforma progettata specificamente per coding complesso e workflow agentici, con una finestra di contesto da 1.050.000 token, output massimo di 128.000 token e livelli di reasoning regolabili fino alla modalità max.
Il costo effettivo di un modello emerge soprattutto quando l’output deve essere trasformato in un risultato utilizzabile senza ulteriori interventi. Un sistema può generare rapidamente un rapporto di ricerca costruito su più fonti e produrre una risposta formalmente convincente, ma perdere una contraddizione capace di modificare l’intera conclusione; in quel caso una persona deve ricostruire le fonti, individuare l’errore e correggere l’argomentazione. Un problema analogo può verificarsi nello sviluppo software quando un agente produce una pull request apparentemente pulita e capace di superare un insieme ristretto di test, ma introduce modifiche indesiderate in altre parti del prodotto, costringendo il team a una seconda fase di indagine. Nei workflow di marketing, invece, il costo può assumere la forma del tempo necessario a riscrivere un testo le cui affermazioni non corrispondono al materiale fornito. Il confronto economico fra modelli deve quindi considerare non soltanto la spesa API iniziale, ma anche il lavoro necessario per arrivare a un risultato definitivamente approvato.
Claude Opus 5.5 presenta caratteristiche particolarmente rilevanti quando l’attività è complessa, poco strutturata o articolata in numerosi passaggi, soprattutto nei casi in cui recuperare da un errore comporta costi significativi. Fra gli esempi rientrano migrazioni estese di codebase, investigazioni che richiedono di integrare informazioni provenienti da fonti differenti e documenti professionali nei quali è necessario riconciliare evidenze potenzialmente contrastanti. Anthropic ha riportato, fra i test effettuati prima del lancio, il caso di una migrazione riguardante circa 680.000 righe di codice completata in meno di un giorno, un’operazione che secondo il tester coinvolto avrebbe normalmente richiesto settimane di lavoro a un team di ingegneri. Il punteggio ottenuto sull’Artificial Analysis Intelligence Index costituisce un ulteriore elemento utile per valutare il modello su compiti di elevata complessità, ma l’effettivo vantaggio deve comunque essere verificato sulla tipologia di attività svolta dall’organizzazione che intende utilizzarlo.
GPT-6 Sol presenta invece una struttura economica particolarmente rilevante quando gli input sono ben definiti e il risultato può essere sottoposto a verifiche affidabili. Applicazioni come la trasformazione di materiali strutturati, la preparazione di bozze a partire da un insieme di fonti già approvate o modifiche circoscritte al codice accompagnate da test automatici possono sfruttare il costo inferiore per aumentare il numero di iterazioni senza far crescere rapidamente la spesa di inferenza. La piattaforma supporta diversi livelli di reasoning effort, da none fino a max, consentendo di modificare il quantitativo di elaborazione impiegato in funzione della difficoltà dell’attività. In questo tipo di utilizzo il vantaggio economico rimane però legato alla percentuale di risultati che supera la revisione al primo tentativo: una generazione meno costosa perde parte del proprio vantaggio se richiede ripetuti cicli di correzione, mentre un costo superiore può risultare meno rilevante se evita a personale altamente specializzato di ricostruire un lavoro complesso.
La scelta del modello non sostituisce inoltre la necessità di fornire correttamente il contesto aziendale. Un sistema può generare una risposta tecnicamente coerente per il servizio clienti utilizzando però una policy ormai ritirata, oppure produrre un documento di prodotto ben strutturato ma indirizzato al segmento di clientela sbagliato. Né Claude Opus 5.5 né GPT-6 Sol possono ricostruire in modo affidabile decisioni interne, vincoli organizzativi e criteri di approvazione che non siano stati inclusi nel compito. Per questo motivo il test più significativo consiste nell’assegnare ai due modelli lo stesso materiale, lo stesso obiettivo e una definizione verificabile del risultato atteso, osservando non soltanto la risposta finale ma anche quando il sistema richiede ulteriori informazioni, quando procede sulla base di presupposti non esplicitati e quali elementi tende eventualmente a trascurare.
Un confronto aziendale può essere costruito riproducendo attività realmente svolte dall’organizzazione. Una piccola attività può utilizzare alcune operazioni recenti che hanno richiesto molto tempo al titolare, mentre una startup può mettere alla prova entrambi i modelli sullo stesso bug software, sul medesimo pacchetto di ricerca sui clienti o su un brief di lancio identico. In aziende più grandi è possibile ripetere la prova su incarichi rappresentativi provenienti da sviluppo, assistenza, finanza e marketing, facendo valutare i risultati direttamente ai responsabili dei rispettivi processi. I parametri da osservare comprendono il costo del modello, la percentuale di risultati accettati al primo tentativo, il tempo impiegato per le correzioni e il costo complessivo necessario per arrivare a un output approvato. In questo modo il confronto tra il punteggio di 58 ottenuto da Opus 5.5 e quello di 48 registrato da GPT-6 Sol sull’indice di Artificial Analysis può essere affiancato al dato economico di 5,98 contro 1,06 dollari per attività, verificando se la differenza osservata nel benchmark si traduca effettivamente in un vantaggio all’interno dei workflow utilizzati dall’azienda.
Le differenze tra Claude Opus 5.5 e GPT-6 Sol riguardano quindi soprattutto il rapporto fra capacità, costo dell’inferenza e quantità di lavoro necessaria dopo la generazione. I test indipendenti disponibili al momento del lancio mostrano un punteggio superiore per Opus 5.5 nell’Artificial Analysis Intelligence Index e un costo per attività considerevolmente inferiore per GPT-6 Sol. La valutazione operativa richiede però di collegare questi numeri alla natura del carico di lavoro: attività complesse con elevato costo dell’errore, workflow ripetitivi sottoposti a controlli automatici e processi professionali che richiedono una revisione specialistica presentano profili economici differenti anche utilizzando lo stesso modello. Il parametro più significativo diventa quindi il costo necessario per ottenere un risultato definitivamente utilizzabile, che comprende consumo API, iterazioni, controlli e tempo umano richiesto prima dell’approvazione finale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)