
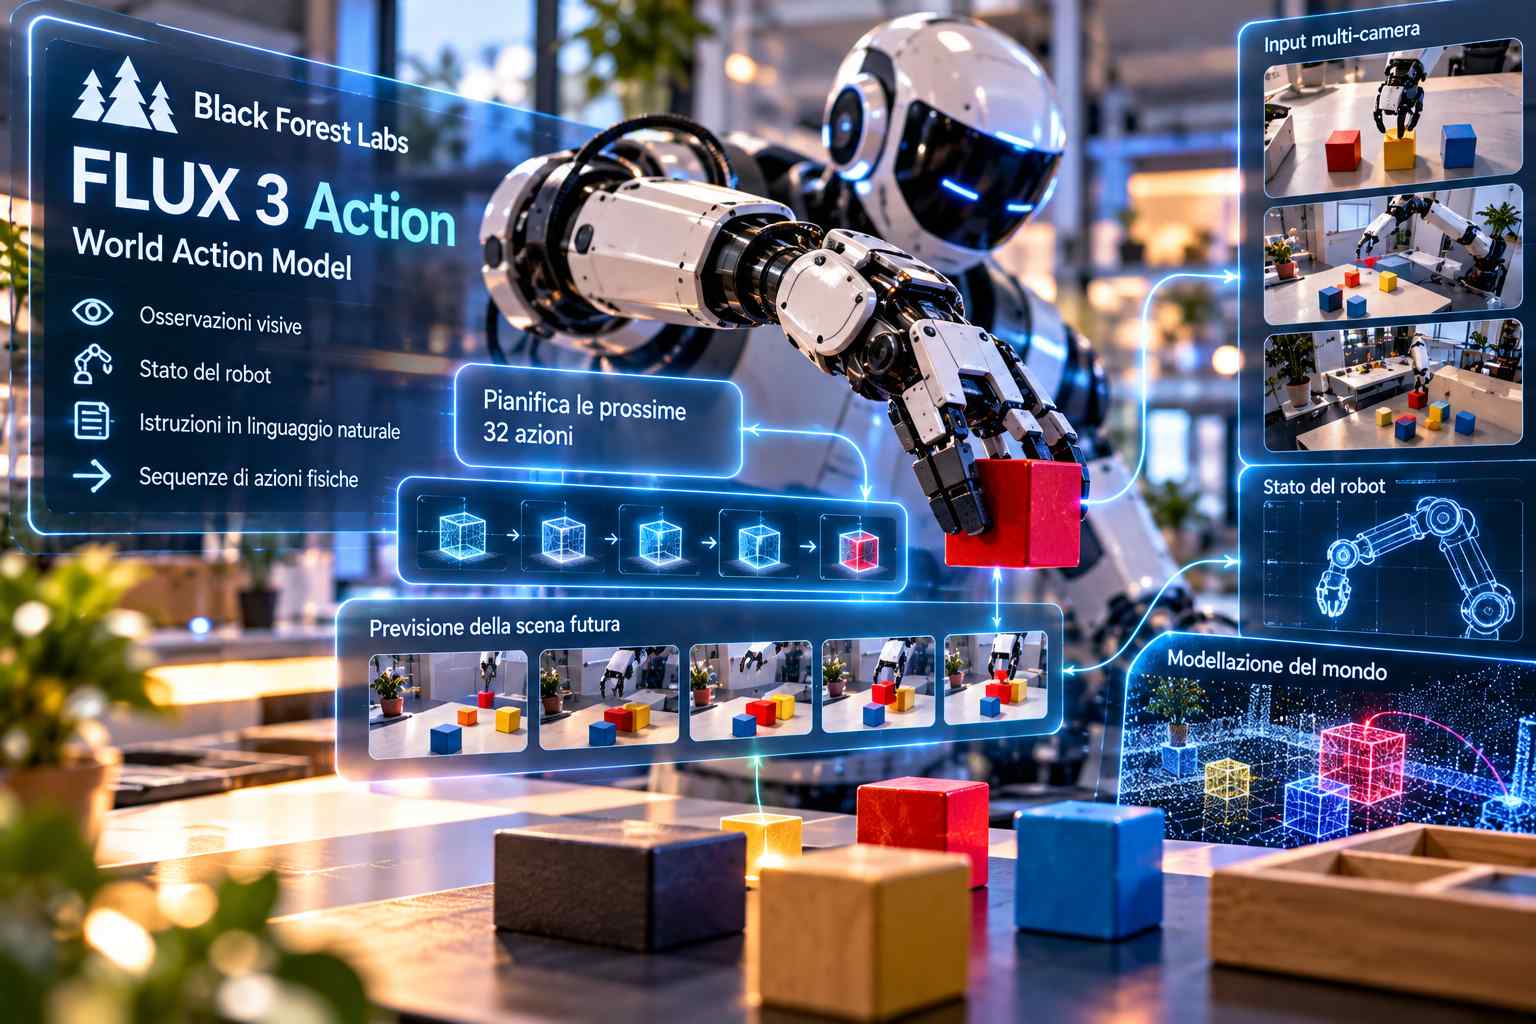
Black Forest Labs ha presentato FLUX 3 Action, un World Action Model open-weight da 7 miliardi di parametri progettato per trasformare osservazioni visive, stato corrente del robot e istruzioni in linguaggio naturale in sequenze di azioni fisiche. Il modello rappresenta l’estensione alla robotica dell’architettura multimodale FLUX 3, sviluppata originariamente per immagini, video e audio, e viene costruito attorno all’idea che un sistema addestrato in profondità sul video possa apprendere rappresentazioni utili di movimento, contatto tra oggetti, dinamiche fisiche e relazioni causa-effetto riutilizzabili successivamente per il controllo robotico. Durante l’inferenza FLUX 3 Action riceve i frame più recenti delle telecamere, lo stato del sistema e la descrizione del compito, quindi genera contemporaneamente le successive 32 azioni e una previsione di come dovrebbe evolvere la scena visiva; il robot esegue il blocco di azioni, osserva nuovamente l’ambiente e ripete il ciclo. La nuova versione utilizza un’architettura più compatta rispetto al backbone FLUX 3 completo ed è stata ulteriormente addestrata per prevedere insieme frame futuri e comandi robotici, collegando quindi direttamente modellazione del mondo e action generation. Il progetto deriva dalla ricerca Self-Flow di Black Forest Labs, che punta a far apprendere allo stesso modello sia rappresentazioni significative degli input sia la loro generazione, riducendo la dipendenza da encoder separati e congelati come CLIP o DINO. Questa stessa impostazione era già stata sperimentata con FLUX-mimic, sviluppato insieme alla svizzera Mimic Robotics e testato anche in ambienti produttivi Audi per attività di manipolazione industriale.
Nei risultati comunicati da Black Forest Labs, FLUX 3 Action raggiunge un success rate complessivo del 42,92% su RoboLab-120, benchmark sviluppato da NVIDIA per valutare policy robotiche general purpose su 120 attività che comprendono comprensione visiva, ragionamento relazionale e abilità procedurali con differenti livelli di difficoltà e variazioni nella precisione delle istruzioni. Il risultato supera di 6,1 punti percentuali Cosmos3-Nano-Policy, modello World Action da 16 miliardi di parametri di NVIDIA, pur utilizzando soltanto 7 miliardi di parametri, equivalenti a circa il 44% della dimensione, e con una velocità dichiarata 1,43 volte superiore. Immediatamente prima del rilascio di FLUX 3 Action, OASIS WAM occupava la prima posizione complessiva di RoboLab-120 con il 39%, quindi il 42,92% dichiarato da BFL collocherebbe il nuovo modello al vertice del benchmark. Il confronto dimensionale con Cosmos è particolarmente favorevole, ma FLUX 3 Action non è in assoluto il modello robotico più piccolo disponibile: MolmoAct 2 di Ai2 dispone di circa 5 miliardi di parametri e NVIDIA distribuisce un checkpoint GR00T N1.7 da 3 miliardi. Questi sistemi vengono però valutati attraverso combinazioni differenti di test reali e simulati e non compaiono direttamente accanto a FLUX 3 Action nel benchmark RoboLab, rendendo improprio confrontarne numericamente le percentuali di successo. Anche le categorie architetturali sono differenti: FLUX 3 Action e Cosmos 3 vengono descritti come World Action Models, π0.5 di Physical Intelligence e la famiglia GR00T come Vision-Language-Action models, mentre Ai2 definisce MolmoAct 2 un Action Reasoning Model. Tutti possono essere applicati a workload robotici sovrapposti, ma apprendono e producono le azioni attraverso impostazioni differenti.
Black Forest Labs sottolinea anche il rapporto tra accuratezza e velocità d’inferenza, utilizzando il real-time factor come metrica per confrontare la latenza computazionale con la durata dell’azione fisica prodotta dal robot: valori inferiori indicano che il modello trascorre meno tempo a decidere rispetto al tempo di movimento effettivamente controllato. Secondo i risultati forniti dall’azienda, le varianti distillate di FLUX 3 Action definiscono una nuova frontiera di Pareto tra successo su RoboLab e velocità d’inferenza su GPU da datacenter e superano π0.5 nel real-time factor mantenendo un tasso di completamento delle attività sensibilmente superiore. Questo aspetto è particolarmente rilevante per l’impiego reale, perché una policy robotica può ottenere buoni risultati nei benchmark ma diventare poco pratica se il tempo richiesto per generare continuamente i comandi produce pause, movimenti irregolari o reazioni tardive. I risultati RoboLab e quelli relativi alla velocità sono stati però forniti direttamente da Black Forest Labs prima del lancio e, al momento della verifica effettuata prima della pubblicazione, il leaderboard pubblico NVIDIA non era ancora stato aggiornato con FLUX 3 Action. Il modello è stato comunque progettato esplicitamente per il deployment e BFL sostiene che la combinazione tra dimensione relativamente contenuta e rappresentazioni apprese durante il pretraining multimodale permetta di ridurre sia il costo dell’inferenza sia la quantità di dati robot-specifici necessaria per l’adattamento.
Nei test mostrati da Black Forest Labs, la policy utilizzata per le dimostrazioni è stata sottoposta a fine-tuning utilizzando circa 200 episodi teleoperati relativi a un piccolo insieme di attività pick-and-place correlate. Gli oggetti presenti nei video di prova non facevano parte del dataset utilizzato per il fine-tuning, elemento impiegato per valutare la capacità del modello di trasferire le rappresentazioni acquisite a nuovi oggetti. In una delle dimostrazioni il robot fallisce inizialmente l’azione e tenta successivamente una seconda esecuzione migliore, comportamento che BFL collega alla capacità del world model preaddestrato di reagire a uno stato imprevisto senza richiedere necessariamente una dimostrazione esplicita di ogni possibile modalità di errore. Si tratta tuttavia di una dimostrazione selezionata dall’azienda e non di una prova che questo recupero autonomo generalizzi a hardware, attività e ambienti differenti. L’obiettivo dichiarato è proprio ridurre la dipendenza dalle grandi raccolte di dati specifiche di ogni robot: un modello che possiede già rappresentazioni di movimento, manipolazione e dinamica degli oggetti può essere adattato al nuovo embodiment attraverso un numero relativamente limitato di dimostrazioni. Un’impostazione analoga viene seguita anche da altri laboratori: Google DeepMind dichiara che Gemini Robotics On-Device 2 può essere adattato a nuovi robot con meno di 200 esempi, mentre Ai2 ha reso MolmoAct 2 disponibile insieme a codice di training, script di fine-tuning, dataset, rollout di valutazione e integrazione LeRobot. Ai2 riporta per il proprio modello un successo medio dell’87,1% su cinque task reali eseguiti con robot Franka contro il 45,2% di π0.5, ma questi risultati utilizzano task e metodologie differenti da RoboLab e non possono quindi essere confrontati direttamente con il 42,92% di FLUX 3 Action.
Il rilascio prevede la pubblicazione di pesi, codice, ricetta di fine-tuning, benchmark ed esempi riproducibili, compresa un’implementazione basata sul robot SO-101 relativamente economico e sul framework LeRobot di Hugging Face. I team potranno partire dal checkpoint preaddestrato e adattarlo utilizzando dimostrazioni raccolte direttamente sui propri robot, invece di addestrare da zero un foundation model per la robotica. FLUX 3 Action era stato mostrato per la prima volta a luglio insieme alla famiglia FLUX 3, ma in quella fase era accessibile soltanto a partner di ricerca e commerciali selezionati. La disponibilità open-weight modifica quindi in modo sostanziale il modello di utilizzo, permettendo ai team di eseguire inferenza sulla propria infrastruttura, modificare il modello e mantenere internamente dati operativi e dimostrazioni proprietarie. Al momento del lancio non sono stati però ancora annunciati un endpoint API specifico per Action, un listino per l’uso hosted o i termini definitivi della licenza commerciale dei pesi, quindi il percorso principale iniziale rimane il self-hosting e il fine-tuning locale. Black Forest Labs aveva già adottato un approccio simile con precedenti versioni Dev della famiglia FLUX dedicate alle immagini, mentre FLUX 3 amplia per la prima volta questa impostazione a un backbone multimodale che comprende video, audio, immagini e previsione delle azioni.
L’architettura viene già sperimentata anche al di fuori della manipolazione robotica. Black Forest Labs dichiara di aver addestrato policy specifiche basate su FLUX 3 Action per pilotare droni nel mondo reale e di aver utilizzato la stessa impostazione per completare Doom senza morti del personaggio controllando direttamente la visuale in prima persona e il movimento dell’arma. L’azienda considera questi risultati esperimenti preliminari e non capacità pronte per la produzione, ma li utilizza per mostrare come la stessa struttura possa essere applicata anche a simulazioni, videogiochi e computer use, tutti ambienti nei quali il modello deve interpretare uno stato visivo che cambia nel tempo, prevederne l’evoluzione e decidere quale azione effettuare successivamente. Questa estensione segue la strategia più ampia introdotta con FLUX 3, modello multimodale con cui Black Forest Labs ha collegato generazione di immagini, video e audio alla nozione di “visual intelligence”: immagini e video forniscono informazioni su struttura, movimento e relazioni spaziali, l’audio aggiunge segnali temporali e sugli eventi fisici, il linguaggio definisce obiettivi e istruzioni e le azioni permettono di apprendere relazioni causali. FLUX 3 Action rappresenta quindi la parte operativa di questa architettura, nella quale il modello non deve soltanto generare o prevedere ciò che accadrà in un ambiente, ma utilizzare la stessa rappresentazione per modificarlo.
Il rilascio arriva mentre Black Forest Labs amplia rapidamente il proprio raggio d’azione rispetto alle origini nella generazione di immagini. Fondata da ricercatori che hanno contribuito allo sviluppo di VQGAN, latent diffusion e Stable Diffusion, la società ha costruito inizialmente la propria posizione attraverso FLUX.1 e le successive famiglie per generazione ed editing visivo, prima di estendere FLUX 3 al video, all’audio e ora alla robotica. Nel dicembre 2025 BFL ha raccolto 300 milioni di dollari in un round Series B che ha portato la valutazione post-money a 3,25 miliardi di dollari e il finanziamento complessivo oltre 450 milioni, mentre la società opera oggi tra Freiburg e San Francisco. FLUX 3 Video è diventato generalmente disponibile tramite API ad agosto con pricing pay-as-you-go a partire da 0,06 dollari al secondo per Draft HD, 0,17 dollari per HD standard e 0,29 dollari per FHD text-to-video o image-to-video, ma per Action non è ancora stato annunciato un equivalente servizio hosted. Nel settore robotico il nuovo modello entra quindi in competizione con un ecosistema sempre più ampio che comprende GR00T N1.7 di NVIDIA, MolmoAct 2 di Ai2 e Gemini Robotics On-Device 2 di Google, differenziandosi soprattutto attraverso la combinazione tra 7 miliardi di parametri, pretraining da world model, pesi scaricabili e possibilità di fine-tuning su hardware proprietario. La verifica decisiva sarà ora la riproducibilità dei risultati al di fuori dei benchmark e delle dimostrazioni preparate da BFL, su robot differenti e in ambienti reali meno controllati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)