
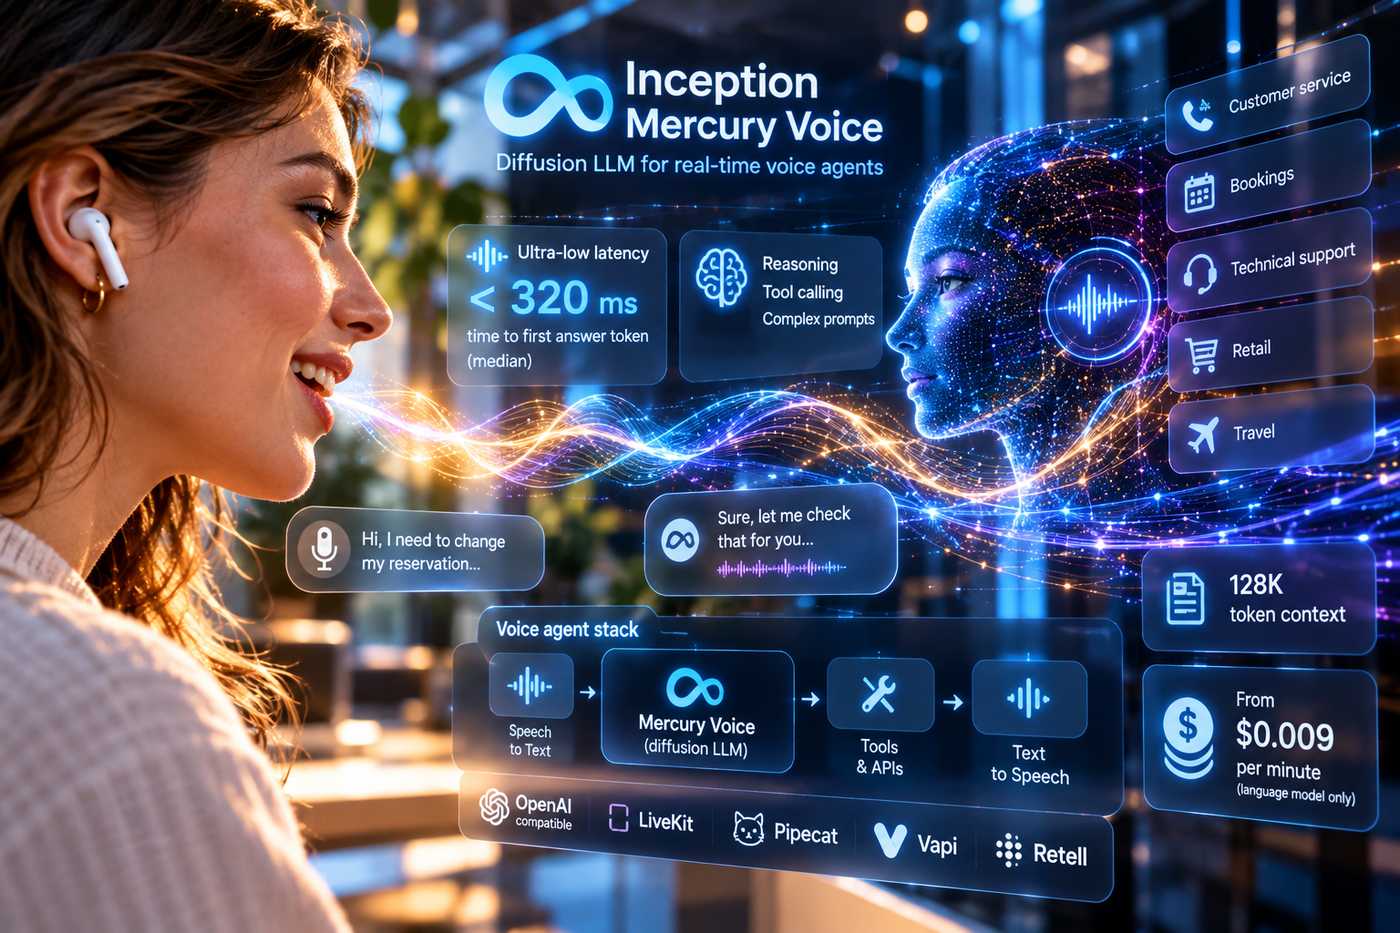
Inception ha reso disponibile per i clienti enterprise Mercury Voice, un modello linguistico diffusion specializzato per agenti vocali e progettato per ridurre la latenza senza rinunciare a ragionamento, tool calling e gestione di prompt di sistema complessi. A differenza dei modelli autoregressivi tradizionali, che generano i token uno dopo l’altro, l’architettura diffusion consente di elaborare e affinare gruppi di token in parallelo, con l’obiettivo di comprimere il tempo necessario prima dell’inizio della risposta. Nei test condotti da Inception su prompt reali di customer service, Mercury Voice ha registrato un time to first answer token mediano inferiore a 320 millisecondi e un valore p95 di 750 millisecondi, risultando secondo l’azienda 5,9 volte più rapido di GPT-6 Luna senza reasoning. Il parametro misura il tempo che intercorre fino alla produzione del primo token della risposta effettivamente destinata all’utente, dopo il completamento del ragionamento interno del modello, e rappresenta quindi una delle metriche più critiche per evitare pause percepibili nelle conversazioni vocali in tempo reale.
Mercury Voice non viene proposto soltanto come modello a bassa latenza, ma come componente centrale dello stack di un agente vocale capace di gestire conversazioni multi-turno, utilizzare strumenti esterni e seguire istruzioni estese mantenendo tempi di risposta compatibili con una normale interazione telefonica. Inception dichiara prestazioni superiori a GPT-6 Luna, Gemma 4 31B e altri modelli nei benchmark utilizzati internamente per valutare attività agentiche e vocali, comprendenti τ³-Bench Telecom, Retail e Airline, IFBench e BFCL v4, anche se al momento non sono stati pubblicati tutti i punteggi dettagliati necessari per un confronto indipendente completo. Il modello dispone di una finestra di contesto da 128.000 token e permette di regolare il livello di reasoning in funzione della complessità del compito, così da riservare più calcolo ai passaggi che lo richiedono e mantenere invece latenze minime nelle richieste più semplici. L’obiettivo è evitare il compromesso tipico dei sistemi vocali attuali, nei quali i modelli più veloci spesso rinunciano a capacità di ragionamento avanzato mentre quelli più potenti introducono pause troppo lunghe per una conversazione naturale.
Il modello può essere inserito nelle architetture voice-agent già esistenti attraverso endpoint compatibili con OpenAI e integrazioni con framework e piattaforme come LiveKit, Pipecat, Vapi e Retell, mantenendo separati i moduli di speech-to-text e text-to-speech. Mercury Voice occupa quindi il livello linguistico centrale della pipeline, dove interpreta il contenuto trascritto, decide eventuali chiamate a strumenti, esegue il reasoning necessario e produce il testo destinato alla sintesi vocale. Questa impostazione consente di sostituire il modello senza riprogettare l’intero sistema e permette alle aziende di impiegarlo in call center, assistenza clienti, prenotazioni, supporto tecnico e altre applicazioni telefoniche o vocali automatizzate nelle quali il ritardo cumulativo tra trascrizione, inferenza e generazione audio determina direttamente la naturalezza dell’interazione.
Mercury Voice è disponibile dal 29 settembre 2026 per clienti enterprise, con un prezzo standard di 0,40 dollari per milione di token in input e 1,50 dollari per milione in output; Inception applica inoltre uno sconto iniziale del 50% e stima un costo medio di circa 0,009 dollari per minuto di conversazione per la sola componente linguistica. La società presenta il modello come estensione della famiglia Mercury, basata interamente su diffusion LLM e già utilizzata per applicazioni di ricerca e generazione testuale ad alta velocità. I dati di latenza e costo pubblicati riguardano tuttavia il modello e non l’intera pipeline vocale, nella quale continuano a incidere anche speech recognition, rete, tool esterni e sintesi audio; le prestazioni effettive di un agente dipendono quindi dall’integrazione complessiva dello stack e dai carichi reali dell’applicazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)