
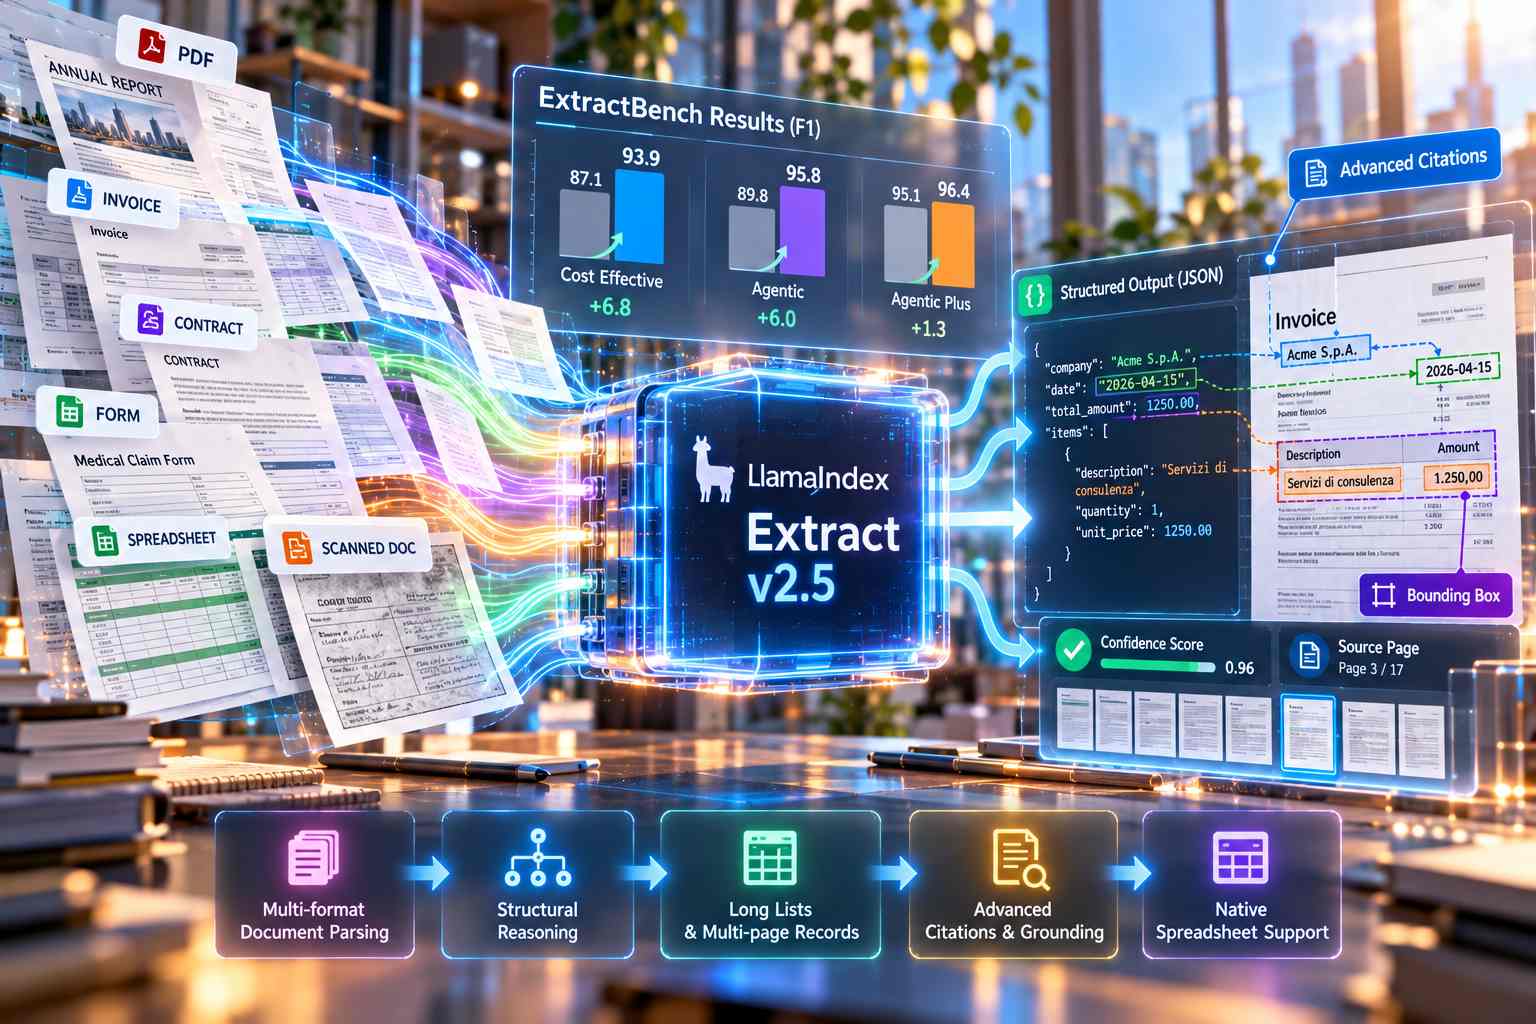
LlamaIndex ha rilasciato Extract v2.5, nuova versione del sistema di estrazione strutturata da documenti basato su schema, con miglioramenti dichiarati su tutti e tre i livelli disponibili: Cost Effective, Agentic e Agentic Plus. Nei test ExtractBench, il valore F1 complessivo passa da 87,1 a 93,9 per Cost Effective, da 89,8 a 95,8 per Agentic e da 95,1 a 96,4 per Agentic Plus, senza aumenti del prezzo per pagina. Il benchmark utilizzato comprende 370 documenti enterprise per un totale di 4.869 pagine, distribuiti su otto domini aziendali e 67 tipologie documentali, ciascuna associata a uno schema specifico. Con la nuova versione, il livello Cost Effective supera quindi i risultati ottenuti in precedenza da Agentic, mentre Agentic raggiunge prestazioni superiori alla precedente generazione di Agentic Plus.
Il miglioramento deriva da un nuovo agent harness progettato specificamente per l’estrazione documentale e ispirato ai più recenti sistemi agentici per il coding, con strumenti dedicati alla gestione degli errori di visione, ragionamento e verifica. L’agente può confrontare informazioni distribuite su più pagine, ricondurre i valori estratti alle fonti precise e utilizzare una funzione di Structural Reasoning che adatta il processo alla tipologia di documento, alla struttura del layout e alla densità delle informazioni, dedicando maggiore elaborazione ai documenti più complessi e riducendo invece la latenza su quelli più semplici. L’architettura utilizzata in precedenza soprattutto da Agentic Plus è stata estesa anche agli altri due tier, adattando strumenti e strategie ai rispettivi vincoli di costo; il sistema è stato inoltre ottimizzato per seguire schemi e istruzioni molto estesi, fino a casi con 3.200 campi.
Uno dei progressi principali riguarda le liste molto lunghe e i record distribuiti su più pagine. Nei long-list task, i punteggi salgono da 82,0 a 92,6 per Cost Effective, da 86,1 a 95,5 per Agentic e da 94,5 a 96,3 per Agentic Plus. LlamaIndex utilizza rappresentazioni intermedie dell’intero dataset e valida l’output rispetto allo schema richiesto: in un filing finanziario di 17 pagine, per esempio, la versione precedente di Cost Effective aveva estratto 87 delle 238 partecipazioni presenti, mentre v2.5 ne recupera tutte e 238, portando il punteggio del documento da 52,8 a 98,7. Anche sui record che proseguono oltre un’interruzione di pagina i risultati aumentano sensibilmente, passando rispettivamente da 80,3 a 92,0, da 85,5 a 96,5 e da 93,6 a 96,7 nei tre livelli. Sui moduli scannerizzati i valori salgono invece da 89,6 a 93,9, da 90,9 a 95,7 e da 94,4 a 96,1, con una migliore capacità di distinguere dati originali, annotazioni e informazioni aggiunte successivamente al documento.
Extract v2.5 introduce inoltre Advanced Citations nei tier Agentic e Agentic Plus, con bounding box che individuano direttamente nel documento l’area da cui deriva l’informazione estratta, anche quando il valore finale non compare letteralmente nel testo ma viene ricavato attraverso il ragionamento. Il grounding score di Agentic passa da 46,8 a 80,6 e quello di Agentic Plus da 46,4 a 82,2. Le citazioni possono essere combinate con confidence score per costruire workflow human-in-the-loop nei quali i valori ad alta affidabilità vengono elaborati automaticamente, mentre quelli più incerti vengono sottoposti a verifica confrontandoli con il documento originale.
La versione 2.5 aggiunge anche una modalità nativa per i fogli di calcolo: invece di trasformare il workbook in una rappresentazione appiattita, gli agenti possono lavorare direttamente sulle singole celle, preservando meglio la struttura del documento. Extract v2.5 è disponibile attraverso LlamaCloud, il tool da riga di comando llp, un server MCP utilizzabile da client agentici come Claude Code e Codex e il Python SDK llama-cloud, dove i job di estrazione possono selezionare esplicitamente la versione 2.5 e attivare citazioni delle fonti e confidence score. LlamaIndex consiglia di testare la nuova release utilizzando documenti reali rappresentativi dei propri workflow e gli schemi già in uso, soprattutto nei casi in cui le versioni precedenti richiedevano correzioni manuali o non erano sufficientemente affidabili per un’automazione completa.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)